De fleste leverandører, der sælger "AI-agenter", pakker ufleksible RPA-scripts ind på ny. Ægte AI-agenter til automatisering af forretningsprocesser bruger LLM'er til at planlægge, udføre og tilpasse sig undervejs. Det største afkast kommer fra automatisering af dataarbejde bag kulisserne, ikke fra opsigtsvækkende chatbots til kunderne.
Bygger du med AI-modeller? AIGROW API-kredit kører Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listeprisen.
- Kun 16% af virksomheders implementeringer er ægte autonome agenter. Langt de fleste er arbejdsgange med en fast rækkefølge, der udgiver sig for at være AI.
- Samarbejde med leverandører om implementering af AI-agenter lykkes i omkring 67% af tilfældene, langt oftere end løsninger udviklet internt.
- Det største afkast fra AI-agenter kommer fra automatisering af administrative opgaver som dataanalyse og rapportering, ikke fra hypen om kundevendte løsninger.
Hvad er en AI-agent i automatisering af forretningsprocesser?
En AI-agent kan vælge og bruge godkendte værktøjer, se resultatet og vælge næste skridt inden for fastsatte rammer. En fast arbejdsgang følger en forudbestemt rute. Forskellen skal testes på systemets adfærd, ikke udledes af leverandørens betegnelse.
En løsning, der skal i drift, kræver fire klart definerede dele:
- Mål og grænser: Definér opgaven, tilladte handlinger, stopbetingelser og den ansvarlige person.
- Værktøjer og tilladelser: Giv hvert værktøj adgang til så få data og skriverettigheder som nødvendigt.
- Tilstand og genopretning: Registrér input, handlinger, resultater, nye forsøg og eskaleringer.
- Evaluering: Test normale tilfælde, grænsetilfælde, afviste handlinger og tjenestefejl før lancering.
I en tænkt arbejdsgang for lagerstyring kan en agent slå lagerbeholdningen op, sammenligne med en godkendt priskilde og forberede en advarsel. Den må ikke ændre en pris, medmindre politikken og godkendelsesprocessen tillader det. Registrér genopretningsrate, svartid, forkerte handlinger og tilfælde, hvor den ansvarlige griber ind, under pilotprojektet.
Hvordan skelner du mellem ægte autonome agenter og 'agent washing'?
Det er den centrale fordel ved AI-agenter til automatisering af forretningsprocesser: De kan håndtere ændringer i deres omgivelser. 'Agent washing' er, når almindelige automatiseringsscripts, RPA-botter eller simple chatløsninger bygget oven på en LLM markedsføres som "autonome AI-agenter" for at udnytte efterspørgslen. Det er udbredt lige nu.
Den afgørende test er, om systemet selv kan tilpasse sin plan, når det møder uventede dataformater, defekte API'er eller manglende felter. Ifølge Gartner er kun omkring 130 af de tusindvis af leverandører, der kalder deres løsninger agentbaserede, reelle. Resten gør det, Gartner kalder "agent washing".
Når du vurderer en leverandør, ser du derfor sandsynligvis på en avanceret Zapier-arbejdsgang, hvor en LLM er sat på til at fortolke input i naturligt sprog.
- Bed om en livedemo med dine data, ikke deres testmiljø. Giv systemet en fejlformateret JSON-payload eller en CSV-fil med forskudte kolonner. En ægte agent vil opdage formatfejlen og forsøge at fortolke dataene eller bede om en præcisering. En scriptstyret bot vil gå ned eller ubemærket levere ubrugelige resultater.
- Få en API til at fejle midt i demoen. Bed leverandøren vise, hvad der sker, når et endpoint returnerer 503. En ægte agent bør prøve igen, skifte til et reserveværktøj eller rapportere fejlen med relevant kontekst. Et script vil give en uhåndteret fejl.
- Bed om at se, hvordan planen bliver til. Ægte agenter danner mellemregninger. Hvis leverandøren ikke kan vise, hvordan LLM'en planlægger, før den handler, ser du på en fast pipeline.
- Giv systemet et mål med flere trin, der afhænger af hinanden. Sig: "Hent sidste kvartals omsætning fra vores ERP, sammenlign den med konkurrentens offentliggjorte regnskab, og markér afvigelser over 15%." Hvis systemet ikke selv kan kæde trinnene sammen, er det ikke en agent.
Leverandørdemoer udelader ofte de krav, der gælder i drift. Bed om logge, fejlhåndtering, adgangsbegrænsninger, evalueringsresultater og en plan for tilbagerulning, før du tager en demo som bevis for, at løsningen er klar til drift.
Når vi undersøger den slags fejl, er årsagen næsten altid, at "agenten" var en hardkodet pipeline uden evne til at tilpasse sin plan. Når du vurderer AI-agenter til automatisering af forretningsprocesser, så bed leverandørerne vise, hvordan deres system håndterer tilstand og lægger en ny plan.
Trin 1: Vælg en arbejdsgang til pilotprojektet, og sæt realistiske mål for afkastet
Bed leverandøren om en plan for pilotprojektet med et målbart udgangspunkt, før du beslutter dig. Valget af arbejdsgang afgør, om din første implementering af en agent giver en målbar effekt på resultatet eller bliver endnu et mislykket forsøg. Vælg en afgrænset arbejdsgang med klare input, handlinger der kan omgøres, en ansvarlig kontrollant og et mål, der kan måles før og efter implementeringen.
Pilotprojekter med størst afkast handler om interne dataarbejdsgange med klare input og output, ikke kundekontakt, hvor antallet af grænsetilfælde vokser eksponentielt. Dataanalyse og rapportering er de anvendelser af AI-agenter, der har størst effekt. 60% af organisationerne nævner dem som nogle af de mest betydningsfulde opgaver.
Automatisering af interne processer følger tæt efter og nævnes som særligt betydningsfuld af 48% af organisationerne.
Disse arbejdsgange er velegnede, fordi de har strukturerede input (databaser, API'er, filer), klart definerede output (rapporter, dashboards, advarsler) og begrænset risiko i kundekontakten. Manglende læring i organisationen kan få et pilotprojekt til at køre af sporet: Teams har taget agenter i brug uden at definere succeskriterier, lære medarbejderne at fortolke agenternes output eller tilpasse de efterfølgende arbejdsgange, så de kan bruge indsigterne.
- Kortlæg den nuværende manuelle proces. Dokumentér hvert trin, hvert beslutningspunkt og hvert værktøj, medarbejderen bruger. Medtag tidsforbrug pr. trin og fejlprocenter.
- Beregn den nuværende omkostning. Beregn de månedlige lønomkostninger, alternativomkostninger og omkostninger ved fejl. Det er dit udgangspunkt.
- Vurder, hvor struktureret arbejdsgangen er. Har den definerede input og output? Kan en agent gennemføre den med 5 eller færre værktøjskald? Hvis ikke, egner den sig ikke som pilotprojekt.
- Definér et succeskriterium, der enten er opfyldt eller ikke opfyldt. Angiv en grænse, arbejdsgangen skal overholde. "Øget effektivitet" kan ikke stå alene som målbart mål.
Sådan vurderer vi en arbejdsgang til et pilotprojekt:
| Målepunkt | Manuelt udgangspunkt | Med agenthjælp |
|---|---|---|
| Månedlig mængde | 120 rapporter | 120 rapporter |
| Arbejdstimer | 180 timer | 22 timer |
| Lønomkostning ved $75/time | $13,500 | $1,650 |
| Omkostning til API-tokens | $0 | $340 |
| Omkostning til agentplatform | $0 | $800 |
| Fejlprocent | 4,2% | 0,8% |
| Samlet månedlig omkostning | $13,500 | $2,790 |
| Månedlig besparelse | - | $10,710 |
| Tid til investeringen er tjent hjem | - | 2,1 måneder |
Beregn afkastet fra en agent
Beregn den månedlige besparelse ved at erstatte en manuel arbejdsgang med en AI-agent.
Her er et gennemregnet eksempel på et pilotprojekt inden for finansiel rapportering: Valget af AI-agenter til automatisering af forretningsprocesser begynder med en grundig udvælgelse af arbejdsgangen.
Trin 2: Vurder, om du skal bygge eller købe, og vælg et framework til din agent
Spring det over, og I ender blandt de 95% af pilotprojekterne, der ikke påvirker P&L. Valget mellem at bygge og købe infrastrukturen til AI-agenter handler ikke om teknisk kunnen. Det handler om, hvorvidt organisationen er klar, har kapacitet til vedligeholdelse og kan skabe værdi hurtigt.
Her tager de fleste teams fejl.
Forskellen skyldes, at en agent i produktion kræver orkestrering, overvågning, fejlhåndtering og integration med værktøjer. Leverandørernes platforme har allerede bygget og testet disse lag. Hvorfor insisterer så mange teams alligevel på at starte fra bunden?
Køb, når: Jeres arbejdsgang er standardiseret (rapportering, dataudtræk eller fordeling af kundehenvendelser), I ikke har dedikerede ML-ingeniører, og I hurtigt skal skabe værdi.
Byg selv, når: Jeres arbejdsgang omfatter egne systemer uden eksisterende integrationer, lovkrav forhindrer datadeling med leverandører, eller I har brug for detaljeret kontrol over agentens planlægningslogik.
Interne teams undervurderer, hvor meget udviklingsarbejde der skal til for at gøre agenter pålidelige i stor skala. Vælger I at bygge selv, er valget af framework også vigtigt.
| Framework | Arkitektur | Bedst til | Håndtering af tilstand | Kompleksitet |
|---|---|---|---|---|
| LangGraph | Grafbaseret (noder + forbindelser) | Komplekse arbejdsgange med tilstand og betingede forgreninger | Eksplicit graftilstand med checkpoints | Høj |
| CrewAI | Rollebaserede teams med flere agenter | Samarbejdsopgaver, hvor agenter har forskellige roller | Delt hukommelse med adskilte roller | Middel |
| AutoGen | Samtalebaseret samarbejde mellem flere agenter | Iterative opgaver, der kræver dialog mellem agenter | Beskeder udveksles mellem agenter | Middel til høj |
Her er en sammenligning af de tre førende open source-frameworks til agenter pr. juli 2026: LangGraph egner sig bedst til komplekse arbejdsgange med tilstand. Arkitekturen er grafbaseret, hvor hver node repræsenterer et beregningstrin, og forbindelserne repræsenterer betingede overgange.
CrewAI egner sig bedst til rollebaserede teams med flere agenter, hvor en researcher, en analytiker og en skribent skal samarbejde om et struktureret resultat.
from langgraph.graph import StateGraph, END
from typing import TypedDict, Annotated
import operator


Here is a minimal LangGraph configuration for a reporting pipeline: class AgentState(TypedDict): queries: list[str] raw_data: Annotated[list, operator.add] report: str


errors: list[str] def execute_queries(state: AgentState) -> dict: results = [] errors = [] for q in state["queries"]: try: result = run_query(q) # Your DB query function results.append(result) except Exception as e: errors.append(f"Query failed: {q} - {str(e)}")


return {"raw_data": results, "errors": errors} def should_retry(state: AgentState) -> str: if len(state["errors"]) > 0 and len(state["raw_data"]) == 0: return "retry"


return "generate" def generate_report(state: AgentState) -> dict: llm = ChatOpenAI(model="gpt-6-luna") report = llm.invoke(f"Generate a summary from: {state['raw_data']}")


return {"report": report.content} graph = StateGraph(AgentState) graph.add_node("execute", execute_queries) graph.add_node("generate", generate_report) graph.set_entry_point("execute") graph.add_conditional_edges("execute", should_retry, {"retry": "execute", "generate": "generate"}) graph.add_edge("generate", END) app = graph.compile()
mermaid graph TD A[Start] --> B[Execute Queries] B --> C{Data Retrieved?} C -->|No| B C -->|Yes| D[Generate Report] D --> E[End]
Når I vælger AI-agenter til automatisering af forretningsprocesser, sætter jeres valg af framework grænsen for, hvor komplekse løsninger I kan bygge. Start enkelt.
Trin 3: Integrér AI-agenter med ældre ERP- og CRM-systemer
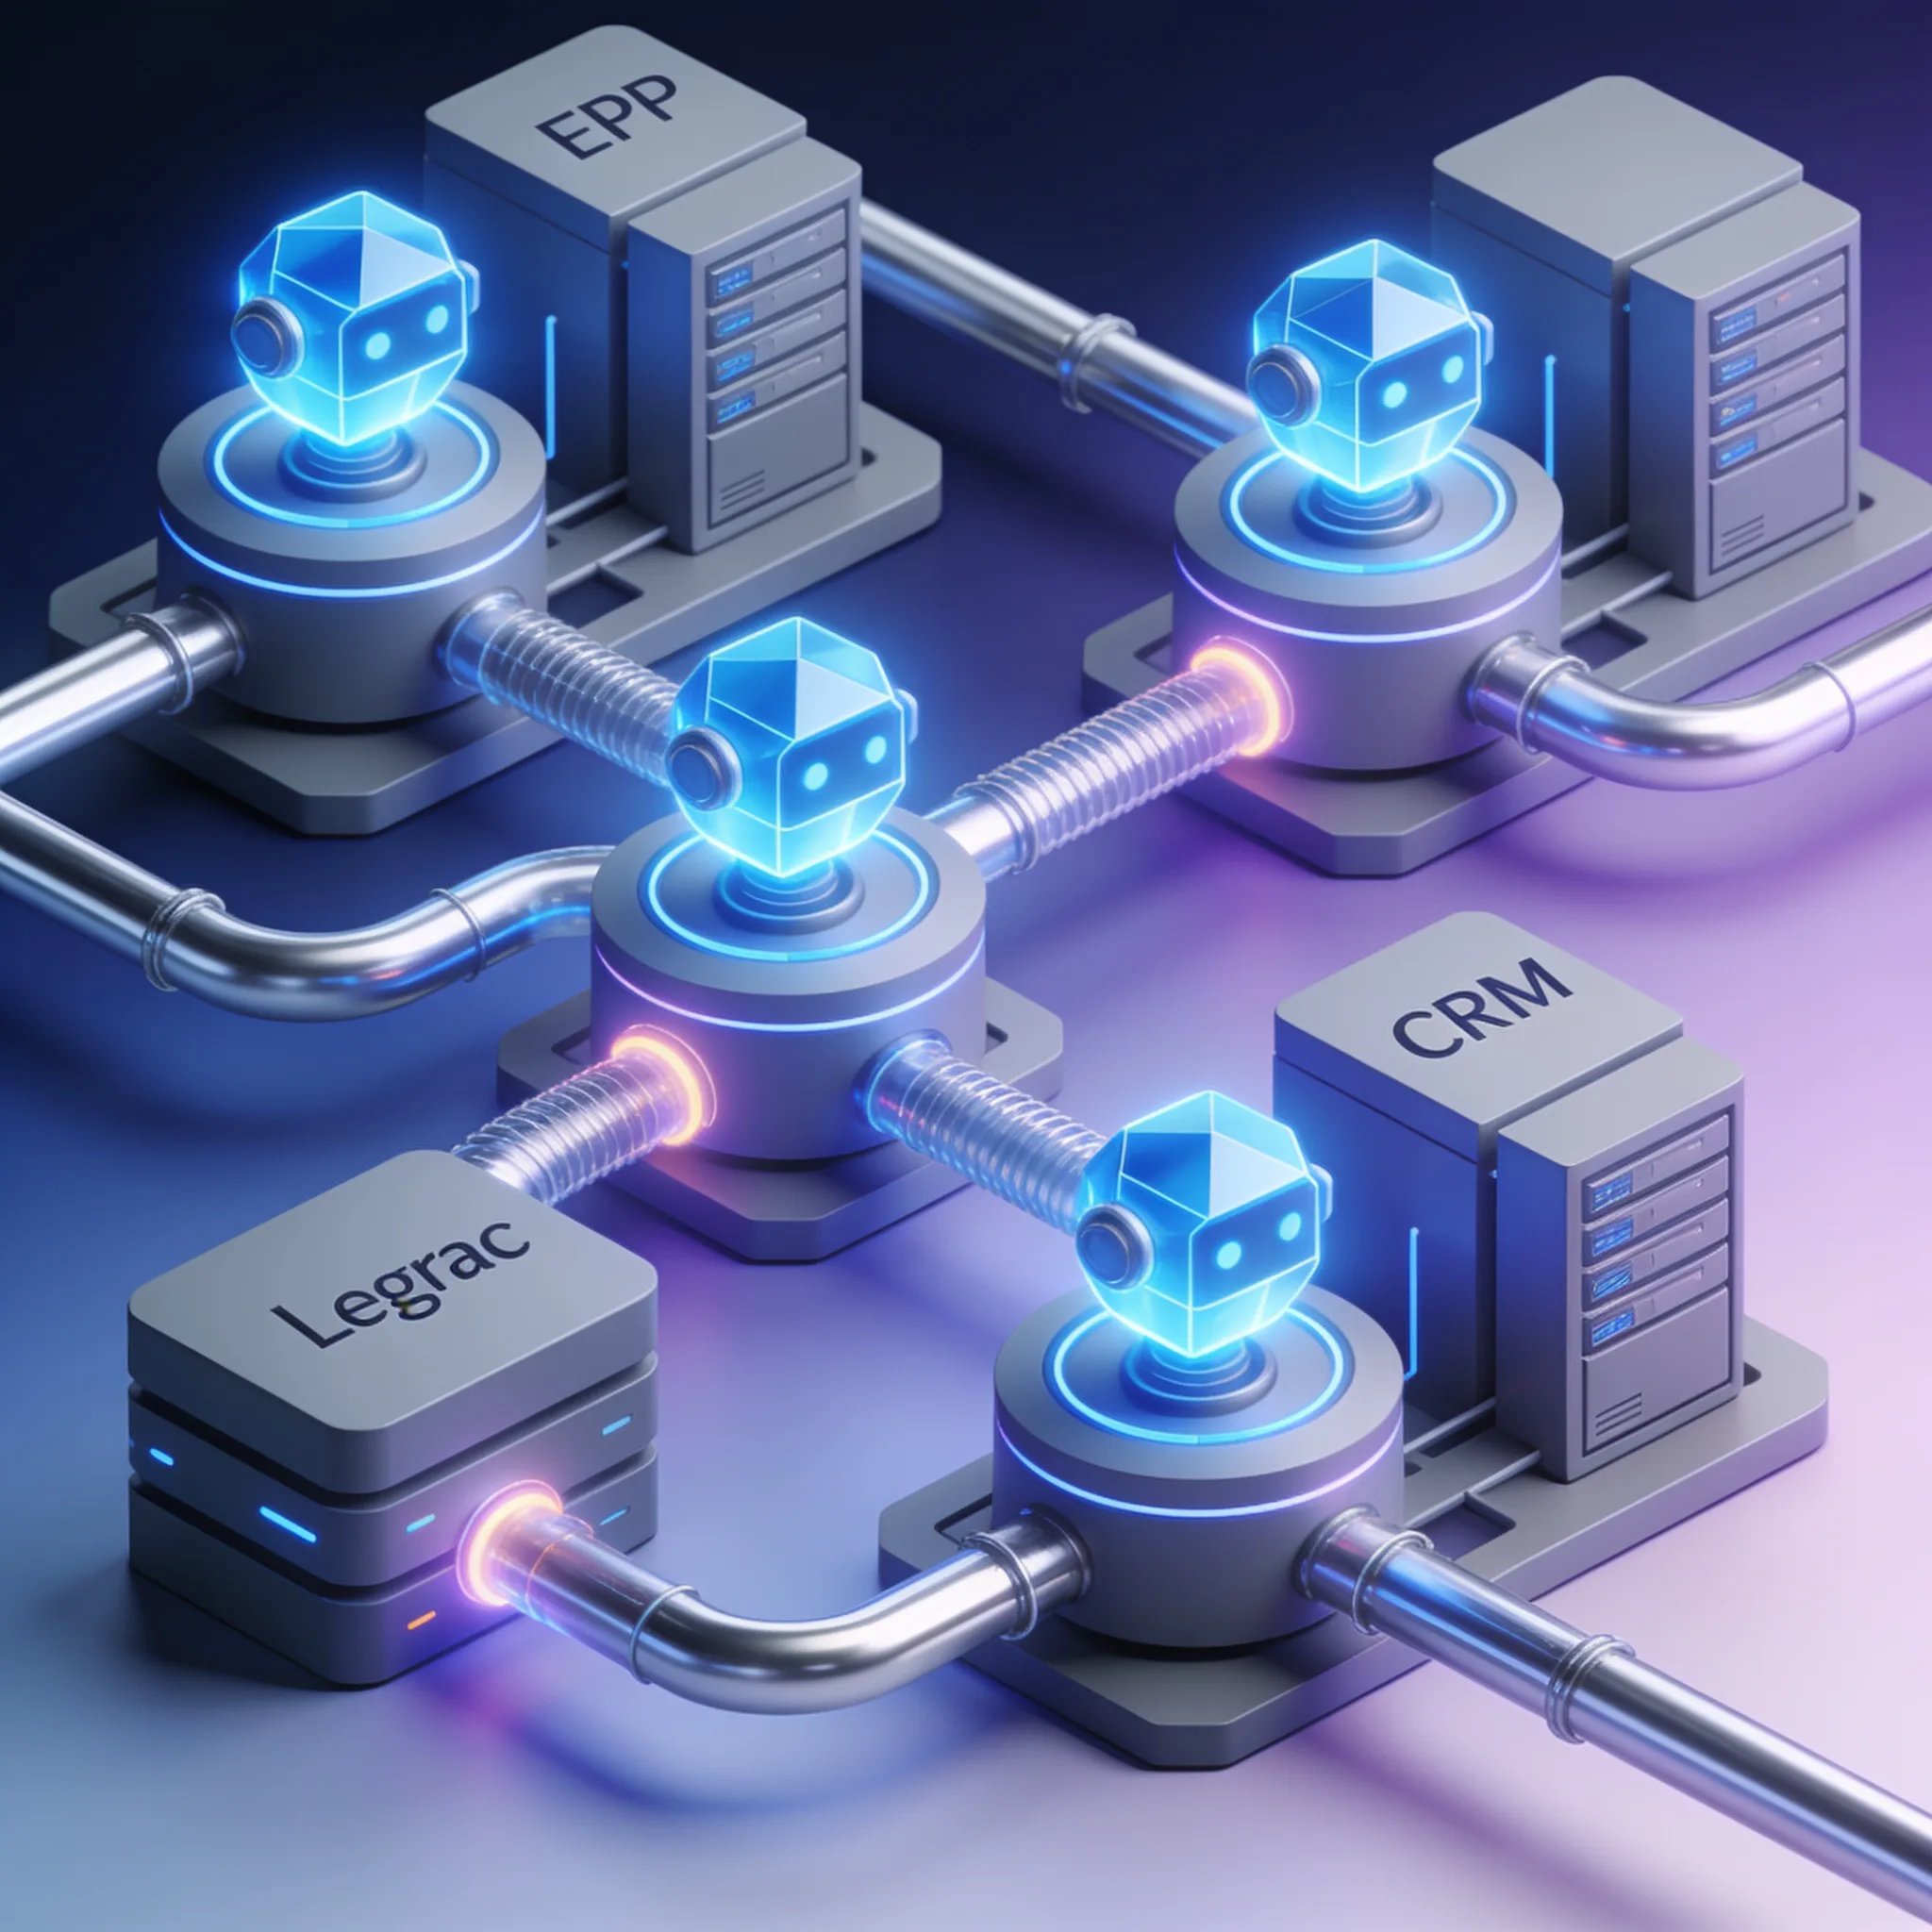
Sæt først en arbejdsgang med én agent i LangGraph i drift, før I forsøger jer med orkestrering af flere agenter. Integration med eksisterende systemer er den største hindring ved implementering, nævnt af 46% af de organisationer, der tager AI-agenter i brug. Det er ikke overraskende.
De fleste ERP- og CRM-systemer til virksomheder er bygget til medarbejdere, der klikker sig gennem brugerflader, ikke til autonome agenter, der kalder API'er. Udfordringen har to sider: forbindelse til systemerne og datakvalitet. 42% af organisationerne peger på adgang til data og datakvalitet som en væsentlig hindring.
I kan bygge en fremragende agent, men hvis jeres ERP-system returnerer datoer i forskellige formater, eller 30% af posterne i jeres CRM er dubletter, bliver agentens resultater upålidelige.
- Brug middleware frem for direkte forbindelser. Placér en API-gateway eller et integrationslag mellem agenten og de ældre systemer. Det skærmer agenten mod særheder hos den enkelte leverandør og gør det muligt at udskifte systemer uden at ændre agentens arkitektur.
- Standardisér datakontrakterne. Definér et fælles skema for hver datatype (kunde, ordre, faktura). Omdan data fra ældre systemer til dette skema i middlewarelaget.
- Håndtér hastighedsbegrænsning og nye forsøg i middlewarelaget. Ældre API'er har ofte udokumenterede grænser for antallet af kald. Agenten bør ikke selv skulle håndtere dem.
- Gennemfør en audit af datakvaliteten, før agenten sættes i drift. Undersøg kildedataene for manglende værdier, uens formater og dubletter. Ret de kritiske problemer, før agenten begynder at bruge dataene.
Sådan forbinder vi agenter med ældre systemer:
# middleware_config.yaml
agent_gateway:
 port: 8080
 timeout: 45
 max_retries: 3

endpoints:
 - name: sap_inventory
 base_url: ${SAP_API_BASE}
 auth:
 type: oauth2
 token_url: ${SAP_TOKEN_URL}
 client_id: ${SAP_CLIENT_ID}
 transform:
 request:
 # Agent sends standardized format
 map_fields:
 sku: MATNR
 warehouse: LGORT
 response:
 # SAP returns legacy format, normalize it
 map_fields:
 MATNR: sku
 LGORT: warehouse
 LABST: quantity
 MEINS: unit
 validate:
 - field: quantity
 type: float
 required: true
 - field: sku
 type: string
 regex: "^[A-Z0-9]{8,12}$"

 - name: salesforce_crm
 base_url: ${SF_API_BASE}
 auth:
 type: bearer
 token: ${SF_TOKEN}
 transform:
 response:
 map_fields:
 Id: customer_id
 Name: customer_name
 AnnualRevenue: revenue
 LastActivityDate: last_contact
 validate:
 - field: customer_id
 required: true
 - field: revenue
 type: float
 default: 0.0


Here is a middleware configuration example for connecting an agent to a legacy SAP system via an abstraction layer: data_quality: rules: - check: duplicate_detection fields: [customer_name, email] action: flag - check: null_rate field: revenue threshold: 0.15 action: alert - check: format_consistency field: last_contact expected_format: "%Y-%m-%d" action: auto_fix
Med denne konfiguration kan agenten kalde sap_inventory via en enkel grænseflade, mens middleware håndterer godkendelse, omdannelse af data, validering og nye forsøg. Agenten ser aldrig SAP's feltnavne eller den komplicerede godkendelse, og sådan bør det være. Da vi indførte løsningen hos en produktionsvirksomhed med et 15 år gammelt SAP ECC-system, koblede vi en agent til lageroptimering på i 3 uger uden at ændre SAP-konfigurationen.
Middlewarelaget håndterede alle særhederne i det ældre system. Når I integrerer AI-agenter til automatisering af forretningsprocesser, skal middleware være en selvstændig teknisk leverance. Det er ikke noget, man kan vælge fra.
Et andet perspektiv: Hvorfor hypen om automatisering af kundevendte opgaver overser det reelle afkast
Administrative arbejdsgange kan være oplagte til et pilotprojekt, fordi det ofte er lettere at følge deres input, ansvarlige og undtagelser end åbne kundesamtaler. Det garanterer ikke et afkast. Teamet har stadig brug for et udgangspunkt og en kontrolleret sammenligning.
Vurdér mulighederne ud fra de samme spørgsmål:
- Er inputtet godkendt, opdateret og tilstrækkeligt struktureret til opgaven?
- Kan en person gennemgå handlinger med stor betydning eller handlinger, der ikke kan fortrydes?
- Er fejl synlige, kan de rettes, og er der en ansvarlig for dem?
- Kan teamet måle behandlingstid, rettelsesarbejde, softwareomkostninger, hændelser og kvaliteten af resultaterne før og efter pilotprojektet?
En daglig afvigelsesrapport er ét eksempel. Software kan hente godkendte poster, beregne forskelle, skrive et udkast til en forklaring og sende det til gennemgang. Business casen skal bygge på organisationens faktiske antal forespørgsler, tid brugt på gennemgang, omkostninger ved fejl, platformsgebyrer og vedligeholdelsesarbejde.
Præsentér ikke beregnede besparelser, som om de stammer fra en gennemført AIGROW-implementering.
Hvordan håndterer I medarbejdernes modstand og oplæring, når I tager agenter i brug?
Start der, hvor besparelserne er: administrative arbejdsgange, hvor omkostninger kan fjernes direkte. Medarbejdernes modstand er den næsthyppigste årsag til, at implementering af AI-agenter går i stå, kun overgået af integrationsproblemer. Det er helt forudsigeligt.
Kompleksiteten gør også oplæring sværere, fordi medarbejderne skal lære at føre tilsyn med, gennemgå og tilsidesætte agenter i stedet for blot at bruge dem som værktøjer.
- Design løsningen sammen med de medarbejdere, der skal bruge agenten. Byg den ikke isoleret for så at overdrage den. Inddrag den person, der udfører den manuelle proces i dag, når I designer arbejdsgangen. Vedkommende kender de undtagelser, I ellers vil overse.
- Start i "copilot-tilstand". Agenten udarbejder resultater, men udfører ingen handlinger. Et menneske gennemgår og godkender dem. Det skaber tillid og afdækker undtagelser, før agenten arbejder selvstændigt.
- Opret et synligt revisionsspor. Medarbejderne skal kunne se, hvad agenten gjorde, hvorfor den traf hver beslutning, og hvilke data den brugte. Uden gennemsigtighed er modstand forståelig.
- Definér medarbejderens nye rolle tydeligt. Sig til teamet: "I skal ikke længere selv udføre arbejdet. I skal føre tilsyn med agenten, der gør det." Det kan mindske frygten for at blive erstattet og giver medarbejderen kontrol med processen.
- Læg en plan for overgangen på 90 dage. Uge 1-4: copilot-tilstand, hvor et menneske gennemgår alt. Uge 5-8: agenten udfører opgaverne, og et menneske gennemgår dem bagefter. Uge 9-12: agenten arbejder selvstændigt, og et menneske griber ind ved undtagelser.
Leverandørdemoer udelader ofte de krav, der gælder i produktion. Bed om logge, fejlhåndtering, adgangsgrænser, evalueringsresultater og en plan for at rulle løsningen tilbage, før I tager en demo som bevis på, at den er klar til drift.
Men efter hver implementering, vi har gennemført, er resultatet det samme: Medarbejderne går fra at udføre opgaver til at føre tilsyn med kvaliteten, og teamet får tid til mere værdifuldt arbejde, der tidligere blev nedprioriteret. Når I tager AI-agenter til automatisering af forretningsprocesser i brug, skal forandringsledelse være en teknisk leverance med milepæle, ansvarlige og mål for succes.
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listepris
Én API-nøgle til modellerne fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellerne fungerer også med Anthropic SDK og Claude Code.
Hver models pris via AIGROW-kredit ligger ved siden af udviklerens listepris, aldrig over den.
Ofte stillede spørgsmål
