De meeste leveranciers die 'AI-agents' verkopen, verpakken starre RPA-scripts opnieuw. Echte AI-agents voor bedrijfsprocesautomatisering gebruiken LLM's om te plannen, taken uit te voeren en zich tijdens het werk aan te passen. Het hoogste rendement komt van weinig aansprekende backofficeprocessen rond data, niet van opvallende klantgerichte chatbots.
Bouw je met AI-modellen? Met AIGROW API-tegoed gebruik je Claude-, GPT-, Gemini- en Grok-modellen tot 75% onder de catalogusprijs.
- Slechts 16% van de AI-implementaties bij grote bedrijven bestaat uit echte autonome agents. De overgrote meerderheid bestaat uit workflows met een vaste volgorde die zich voordoen als AI.
- Samenwerkingen met leveranciers bij de implementatie van AI-agents slagen in ongeveer 67% van de gevallen, veel vaker dan intern ontwikkelde oplossingen.
- Het hoogste rendement van AI-agents komt van weinig aansprekende backofficeprocessen, zoals data-analyse en rapportage, niet van de hype rond klantgerichte toepassingen.
Wat is een AI-agent bij bedrijfsprocesautomatisering?
Een AI-agent kan goedgekeurde tools kiezen en aanroepen, het resultaat beoordelen en binnen vastgestelde grenzen een volgende stap kiezen. Een vaste workflow volgt een vooraf bepaald pad. Toets dat verschil aan het gedrag van het systeem, niet aan het label van een leverancier.
Een ontwerp voor productie heeft vier expliciete onderdelen nodig:
- Doel en grenzen: Leg de taak, toegestane handelingen, stopvoorwaarden en verantwoordelijke vast.
- Tools en rechten: Geef elke tool alleen toegang tot de gegevens en schrijfrechten die nodig zijn.
- Status en herstel: Leg invoer, handelingen, resultaten, nieuwe pogingen en escalaties vast.
- Evaluatie: Test normale situaties, uitzonderingen, geweigerde handelingen en storingen voordat je het systeem in gebruik neemt.
In een denkbeeldig voorraadproces kan een agent de voorraad opvragen, die vergelijken met een goedgekeurde prijsbron en een waarschuwing voorbereiden. De agent mag een prijs pas wijzigen als het beleid en het goedkeuringsproces dat toestaan. Meet tijdens de pilot hoe vaak het proces zich na een fout herstelt, hoeveel tijd het kost, hoeveel onjuiste handelingen er zijn en hoe vaak beoordelaars ingrijpen.
Hoe onderscheid je echte autonome agents van 'agent washing'?
Daarin schuilt de waarde van AI-agents voor bedrijfsprocesautomatisering: ze kunnen omgaan met veranderingen in hun omgeving. Bij 'agent washing' worden gewone automatiseringsscripts, RPA-bots of eenvoudige chatinterfaces rond een LLM als 'autonome AI-agents' verkocht om mee te liften op de vraag in de markt. Dat gebeurt momenteel op grote schaal.
De belangrijkste test is of het systeem zijn uitvoeringsplan zonder menselijke tussenkomst kan aanpassen wanneer het onverwachte dataformaten, defecte API's of ontbrekende velden tegenkomt. Gartner schat dat van de duizenden leveranciers die zichzelf 'agentic' noemen, er slechts ongeveer 130 echte agents aanbieden. De rest doet aan wat Gartner 'agent washing' noemt.
Bij het beoordelen van een leverancier kijk je dus waarschijnlijk naar een geavanceerde Zapier-workflow waaraan een LLM is toegevoegd om invoer in gewone taal te verwerken.
- Vraag om een live demo met jouw data, niet in hun testomgeving. Lever een ongeldig JSON-object of een CSV-bestand met verschoven kolommen aan. Een echte agent herkent het formaatprobleem en probeert de gegevens te verwerken of vraagt om verduidelijking. Een gescripte bot loopt vast of levert ongemerkt onzin op.
- Laat tijdens de demo een API uitvallen. Vraag de leverancier te laten zien wat er gebeurt als een endpoint een 503 retourneert. Een echte agent probeert het opnieuw, schakelt over op een alternatieve tool of meldt de fout met context. Een script loopt vast op een niet-afgevangen fout.
- Vraag om inzicht in de planning. Echte agents doorlopen tussentijdse redeneerstappen. Kan de leverancier niet laten zien hoe het LLM een plan maakt voordat het iets uitvoert, dan kijk je naar een vaste pipeline.
- Geef een doel met meerdere afhankelijke stappen. Zeg bijvoorbeeld: 'Haal de omzet van het afgelopen kwartaal uit ons ERP, vergelijk die met de openbare winstcijfers van de concurrent en markeer afwijkingen van meer dan 15%.' Kan het systeem die stappen niet dynamisch aan elkaar koppelen, dan is het geen agent.
Demo's van leveranciers laten de beperkingen van productieomgevingen vaak buiten beeld. Vraag naar logboeken, foutafhandeling, toegangsgrenzen, evaluatieresultaten en een manier om wijzigingen terug te draaien voordat je een demo als bewijs ziet dat het systeem klaar is voor gebruik.
Als we zulke mislukkingen onderzoeken, blijkt de oorzaak bijna altijd dat de 'agent' een vast geprogrammeerde pipeline was zonder mogelijkheid om opnieuw te plannen. Vraag leveranciers bij het beoordelen van AI-agents voor bedrijfsprocesautomatisering daarom te laten zien hoe hun systeem de status bijhoudt en zijn plan aanpast.
Stap 1: kies de workflow voor je pilot en stel realistische rendementsdoelen vast
Vraag de leverancier om een pilotplan met een meetbare uitgangssituatie voordat je je vastlegt. De keuze van de workflow bepaalt of je eerste agentimplementatie meetbaar bijdraagt aan het bedrijfsresultaat of weer een mislukt experiment wordt. Kies een afgebakend proces met duidelijke invoer, omkeerbare handelingen, een verantwoordelijke beoordelaar en een meetwaarde die je voor en na de implementatie kunt volgen.
De pilots met het hoogste rendement richten zich op backofficeprocessen met duidelijke gegevensstromen, niet op klantcontact, waar uitzonderingen zich snel opstapelen. Data-analyse en rapportage zijn de AI-agenttoepassingen met de grootste impact: 60% van de organisaties noemt dit een van de taken met de meeste impact. Automatisering van interne processen volgt op korte afstand en wordt door 48% van de organisaties als zeer impactvol genoemd.
Deze processen zijn geschikt omdat ze gestructureerde invoer hebben (databases, API's, bestanden), duidelijk omschreven uitkomsten opleveren (rapporten, dashboards, waarschuwingen) en weinig risico in klantcontact met zich meebrengen. Een gebrek aan kennis binnen de organisatie kan een pilot laten mislukken: teams implementeerden agents zonder succescriteria vast te leggen, medewerkers te leren hoe ze de uitkomsten moesten interpreteren of de daaropvolgende processen aan te passen zodat ze de inzichten van de agent konden benutten.
- Breng het huidige handmatige proces in kaart. Leg elke stap, elk beslismoment en elke tool van de medewerker vast. Noteer ook de tijd per stap en het foutenpercentage.
- Bereken de huidige kosten. Bepaal de maandelijkse arbeidskosten, gemiste kansen en kosten van fouten. Dit is je uitgangssituatie.
- Beoordeel hoe gestructureerd het proces is. Zijn de invoer en uitkomsten duidelijk gedefinieerd? Kan een agent het proces met 5 of minder toolaanroepen afronden? Zo niet, dan is het geen goede pilot.
- Stel een toetsbaar succescriterium vast. Bepaal een grens die het proces moet halen. Alleen 'efficiënter werken' is niet meetbaar.
Zo kiezen wij een geschikte workflow voor een pilot:
| Meetwaarde | Handmatige uitgangssituatie | Met hulp van een agent |
|---|---|---|
| Maandelijks volume | 120 rapporten | 120 rapporten |
| Werkuren | 180 uur | 22 uur |
| Arbeidskosten bij $75/uur | $13,500 | $1,650 |
| Kosten voor API-tokens | $0 | $340 |
| Kosten van het agentplatform | $0 | $800 |
| Foutenpercentage | 4,2% | 0,8% |
| Totale maandelijkse kosten | $13,500 | $2,790 |
| Maandelijkse besparing | - | $10,710 |
| Terugverdientijd | - | 2,1 maanden |
Bereken het rendement van een agent
Schat de maandelijkse besparing als je een handmatig proces door een AI-agent laat uitvoeren.
Hieronder staat een uitgewerkt voorbeeld van een pilot voor financiële rapportage. De keuze voor AI-agents voor bedrijfsprocesautomatisering begint met deze zorgvuldige selectie van de workflow.
Stap 2: kies tussen zelf bouwen en inkopen, en selecteer een agentframework
Sla je dit over, dan beland je bij de 95% van de pilots die geen enkel effect op de winst-en-verliesrekening hebben. De keuze om infrastructuur voor AI-agents zelf te bouwen of in te kopen draait niet om technische mogelijkheden, maar om hoe goed je organisatie erop is voorbereid, hoeveel onderhoud je aankunt en hoe snel je waarde kunt realiseren. De meeste teams schatten dit verkeerd in.
Dat komt doordat een agent die in productie draait, lagen nodig heeft voor orkestratie, monitoring, foutherstel en toolintegratie. Leveranciersplatforms hebben die al gebouwd en getest. Waarom blijven zoveel teams dan toch vanaf nul bouwen?
Koop in wanneer: Je workflow standaard is (rapportage, data-extractie, routering van klantvragen), je team geen gespecialiseerde ML-engineers heeft en je snel resultaat nodig hebt.
Bouw zelf wanneer: Je workflow gebruikmaakt van eigen systemen waarvoor geen integraties bestaan, regelgeving verhindert dat je gegevens met leveranciers deelt, of je nauwkeurige controle nodig hebt over hoe de agent plannen maakt.
Interne teams onderschatten hoeveel ontwikkelwerk nodig is om agents op schaal betrouwbaar te laten werken. Kies je ervoor zelf te bouwen, dan is ook je frameworkkeuze belangrijk.
| Framework | Architectuur | Meest geschikt voor | Statusbeheer | Complexiteit |
|---|---|---|---|---|
| LangGraph | Graafgebaseerd (knooppunten + verbindingen) | Complexe workflows met status en voorwaardelijke vertakkingen | Expliciete graafstatus met checkpoints | Hoog |
| CrewAI | Rolgebaseerde teams van meerdere agents | Samenwerkingstaken waarbij agents elk een eigen rol hebben | Gedeeld geheugen met gescheiden rollen | Gemiddeld |
| AutoGen | Meerdere agents die met elkaar communiceren | Iteratieve taken waarvoor overleg tussen agents nodig is | Berichtenuitwisseling tussen agents | Gemiddeld tot hoog |
Dit is een vergelijking van de drie belangrijkste open-source frameworks voor agents in juli 2026. LangGraph is het geschiktst voor complexe workflows met status. Het gebruikt een graafgebaseerde architectuur waarin elk knooppunt een rekenstap is en verbindingen voorwaardelijke overgangen voorstellen.
CrewAI is het geschiktst voor rolgebaseerde teams van meerdere agents, bijvoorbeeld wanneer een onderzoeker, analist en schrijver samenwerken aan een gestructureerd resultaat.
from langgraph.graph import StateGraph, END
from typing import TypedDict, Annotated
import operator


Here is a minimal LangGraph configuration for a reporting pipeline: class AgentState(TypedDict): queries: list[str] raw_data: Annotated[list, operator.add] report: str


errors: list[str] def execute_queries(state: AgentState) -> dict: results = [] errors = [] for q in state["queries"]: try: result = run_query(q) # Your DB query function results.append(result) except Exception as e: errors.append(f"Query failed: {q} - {str(e)}")


return {"raw_data": results, "errors": errors} def should_retry(state: AgentState) -> str: if len(state["errors"]) > 0 and len(state["raw_data"]) == 0: return "retry"


return "generate" def generate_report(state: AgentState) -> dict: llm = ChatOpenAI(model="gpt-6-luna") report = llm.invoke(f"Generate a summary from: {state['raw_data']}")


return {"report": report.content} graph = StateGraph(AgentState) graph.add_node("execute", execute_queries) graph.add_node("generate", generate_report) graph.set_entry_point("execute") graph.add_conditional_edges("execute", should_retry, {"retry": "execute", "generate": "generate"}) graph.add_edge("generate", END) app = graph.compile()
mermaid graph TD A[Start] --> B[Execute Queries] B --> C{Data Retrieved?} C -->|No| B C -->|Yes| D[Generate Report] D --> E[End]
Bij het kiezen van AI-agents voor de automatisering van bedrijfsprocessen bepaalt het framework hoe complex je workflows kunnen worden. Begin eenvoudig.
Stap 3: integreer AI-agents met bestaande ERP- en CRM-systemen
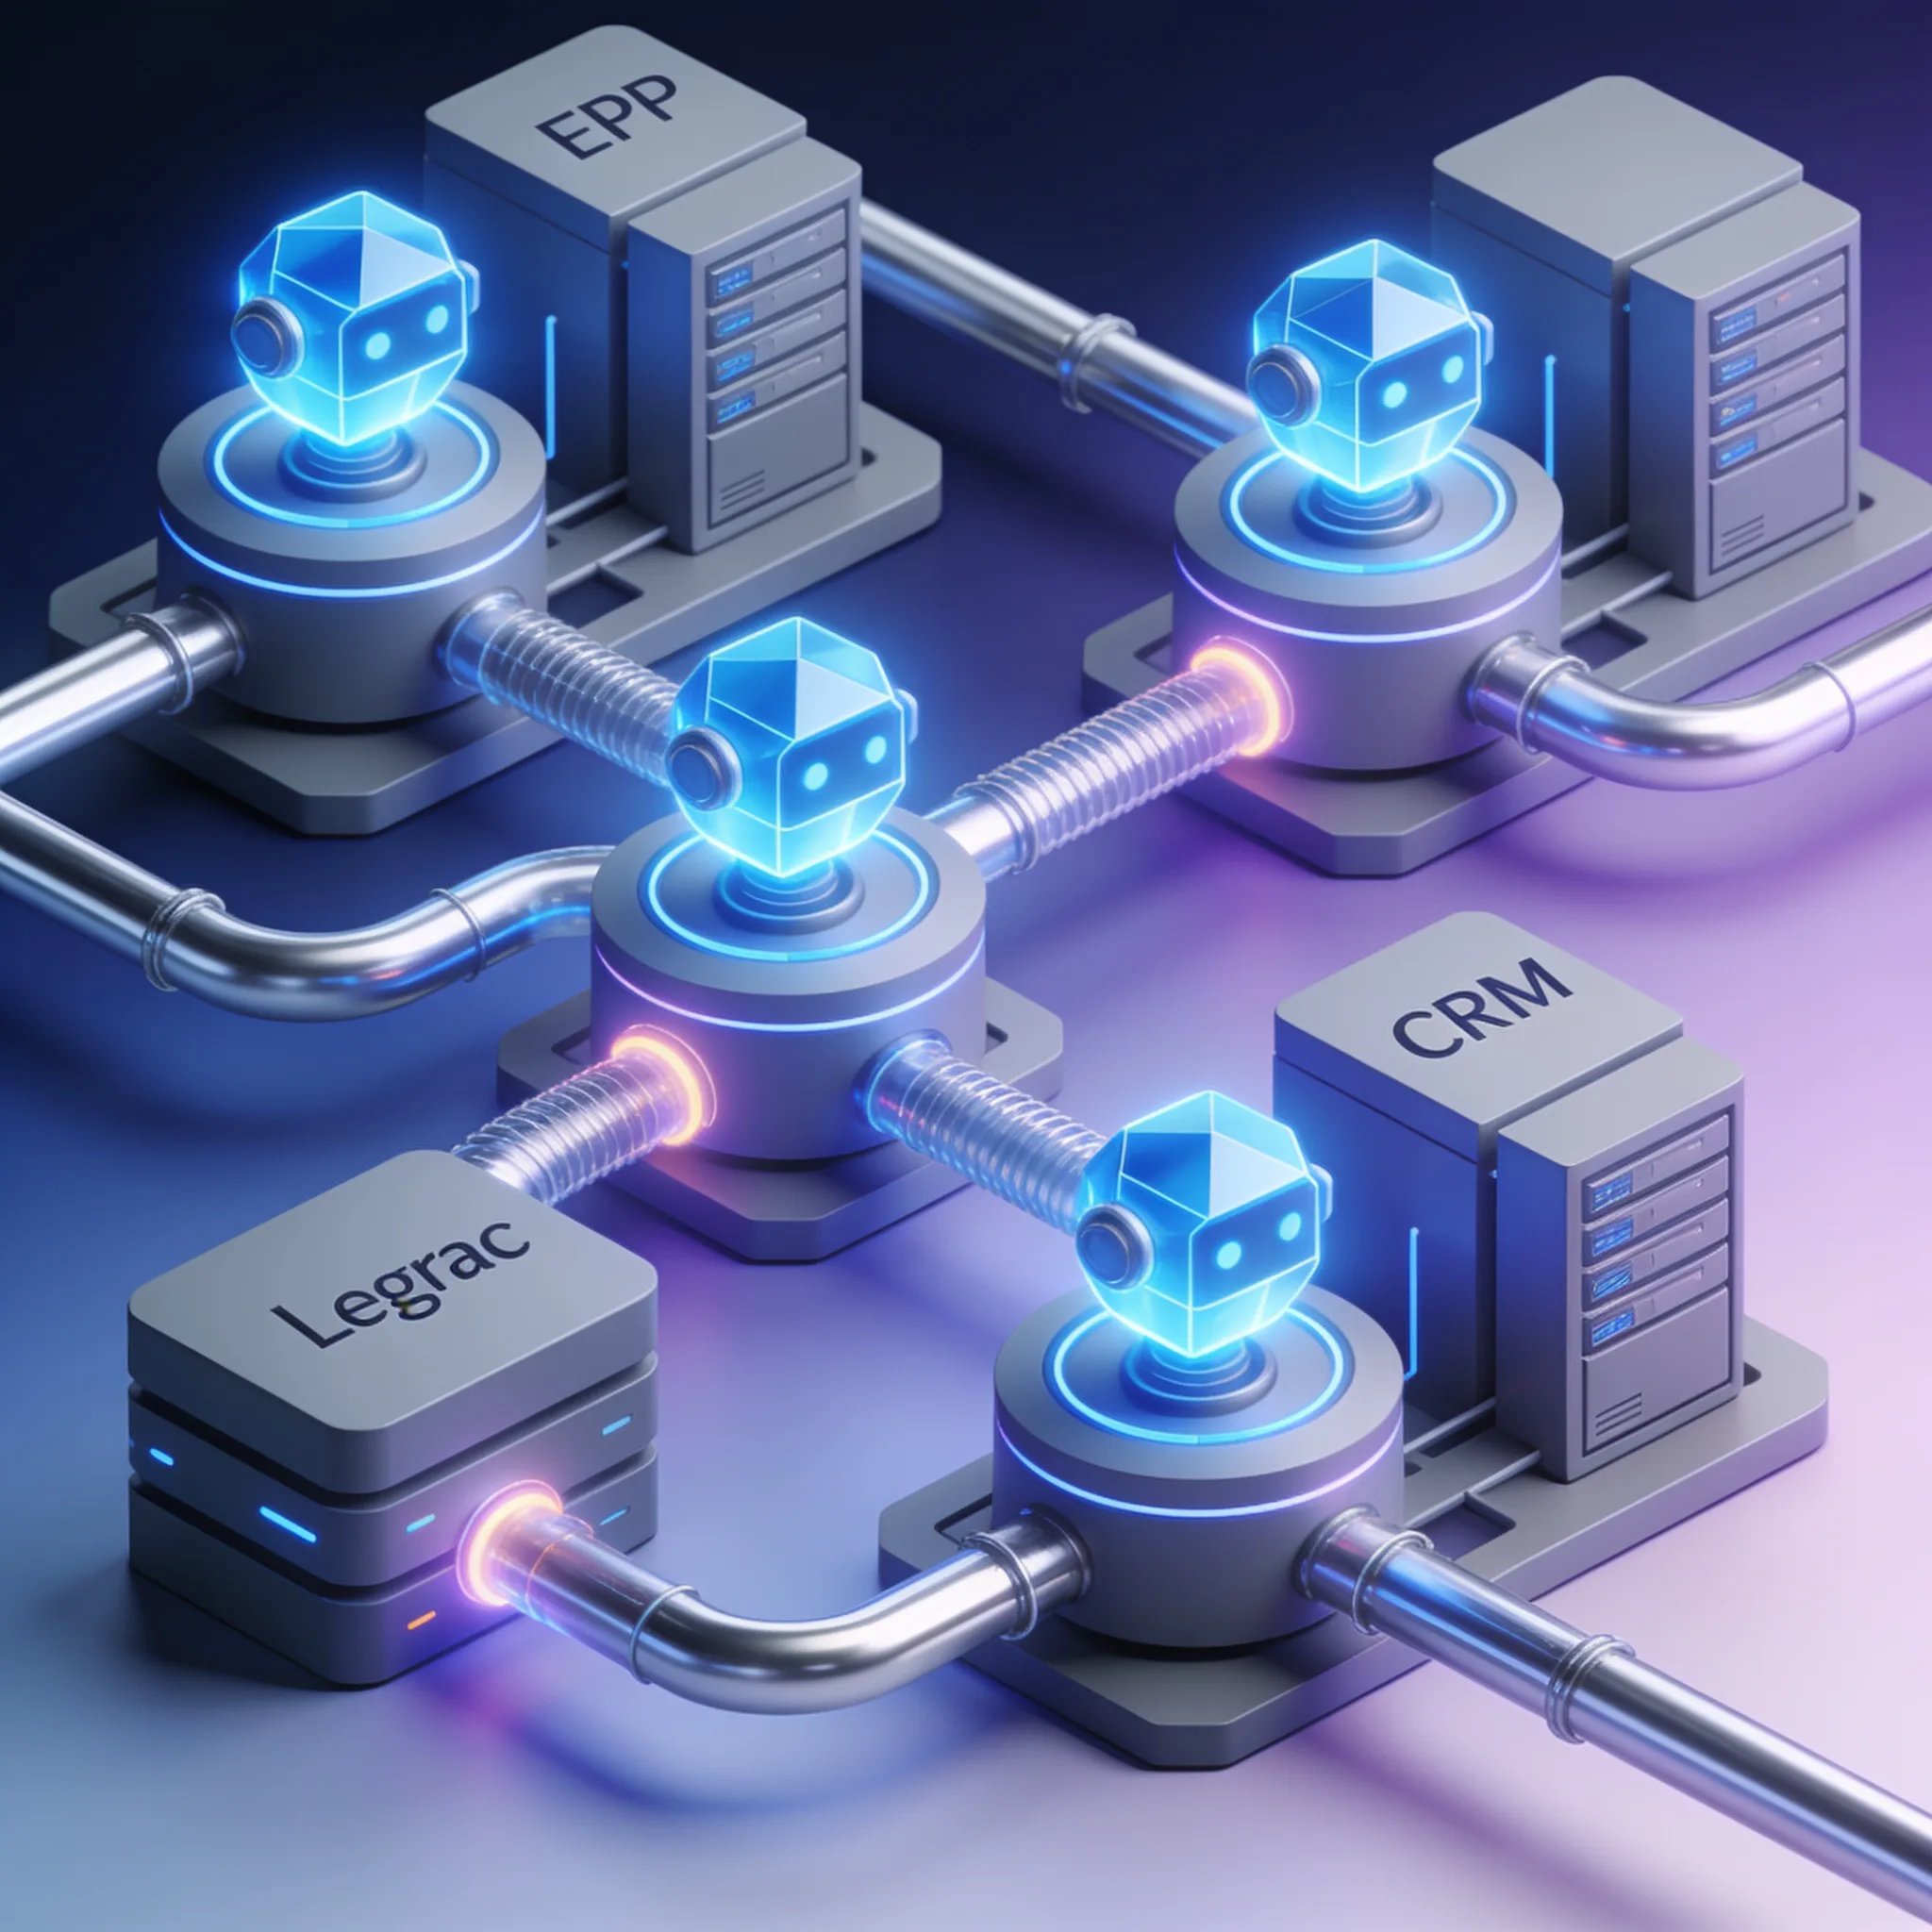
Breng eerst een LangGraph-workflow met één agent in productie voordat je meerdere agents laat samenwerken. Integratie met bestaande systemen is de grootste hindernis bij de implementatie: 46% van de organisaties die AI-agents inzetten, noemt dit probleem. Dat is niet verrassend.
De meeste ERP- en CRM-systemen voor grote organisaties zijn ontworpen voor medewerkers die door een gebruikersinterface klikken, niet voor autonome agents die via een API werken. De uitdaging heeft twee kanten: verbindingen leggen en zorgen voor goede data. 42% van de organisaties noemt problemen met toegang tot data en datakwaliteit als een belangrijk obstakel.
Je kunt een uitstekende agent bouwen, maar als je ERP datums in wisselende notaties teruggeeft of 30% van de records in je CRM dubbel is, worden de resultaten onbetrouwbaar.
- Gebruik middleware in plaats van rechtstreekse verbindingen. Plaats een API-gateway of integratielaag tussen je agent en bestaande systemen. Zo scherm je de agent af van eigenaardigheden van leveranciers en kun je systemen vervangen zonder de agent opnieuw te ontwerpen.
- Standaardiseer datastructuren. Definieer voor elk gegevenstype (klant, bestelling, factuur) een standaardschema. Zet data uit bestaande systemen in de middleware om naar dat schema.
- Regel snelheidsbeperkingen en nieuwe pogingen in de middleware. Oudere API's hebben vaak niet-gedocumenteerde snelheidslimieten. Je agent hoeft de logica om daarmee om te gaan niet zelf te bevatten.
- Controleer de datakwaliteit voordat je de agent implementeert. Onderzoek je brondata op ontbrekende waarden, afwijkende notaties en dubbele records. Los ernstige problemen op voordat de agent de data gaat gebruiken.
Zo pakken wij de koppeling tussen agents en bestaande systemen aan:
# middleware_config.yaml
agent_gateway:
 port: 8080
 timeout: 45
 max_retries: 3

endpoints:
 - name: sap_inventory
 base_url: ${SAP_API_BASE}
 auth:
 type: oauth2
 token_url: ${SAP_TOKEN_URL}
 client_id: ${SAP_CLIENT_ID}
 transform:
 request:
 # Agent sends standardized format
 map_fields:
 sku: MATNR
 warehouse: LGORT
 response:
 # SAP returns legacy format, normalize it
 map_fields:
 MATNR: sku
 LGORT: warehouse
 LABST: quantity
 MEINS: unit
 validate:
 - field: quantity
 type: float
 required: true
 - field: sku
 type: string
 regex: "^[A-Z0-9]{8,12}$"

 - name: salesforce_crm
 base_url: ${SF_API_BASE}
 auth:
 type: bearer
 token: ${SF_TOKEN}
 transform:
 response:
 map_fields:
 Id: customer_id
 Name: customer_name
 AnnualRevenue: revenue
 LastActivityDate: last_contact
 validate:
 - field: customer_id
 required: true
 - field: revenue
 type: float
 default: 0.0


Here is a middleware configuration example for connecting an agent to a legacy SAP system via an abstraction layer: data_quality: rules: - check: duplicate_detection fields: [customer_name, email] action: flag - check: null_rate field: revenue threshold: 0.15 action: alert - check: format_consistency field: last_contact expected_format: "%Y-%m-%d" action: auto_fix
Dankzij deze configuratie kan je agent sap_inventory via een overzichtelijke interface aanroepen. De middleware regelt authenticatie, omzetting, validatie en nieuwe pogingen. De agent krijgt de veldnamen van SAP en de complexiteit van de authenticatie nooit te zien, precies zoals het hoort.
Bij een productiebedrijf met een 15 jaar oud SAP ECC-systeem koppelden we op deze manier binnen 3 weken een agent voor voorraadoptimalisatie, zonder iets aan de SAP-configuratie te veranderen. De middleware ving alle eigenaardigheden van het oude systeem op. Behandel middleware bij de integratie van AI-agents voor de automatisering van bedrijfsprocessen als een volwaardig onderdeel van het ontwikkelwerk.
Het is geen extraatje.
Een ander perspectief: waarom de hype rond frontofficeautomatisering het echte rendement mist
Backofficeworkflows kunnen geschikte kandidaten voor een pilot zijn, omdat de invoer, verantwoordelijken en uitzonderingen vaak makkelijker te volgen zijn dan bij open gesprekken met klanten. Dat garandeert geen rendement. Het team heeft nog steeds een nulmeting en een gecontroleerde vergelijking nodig.
Beoordeel kandidaten aan de hand van dezelfde vragen:
- Zijn de ingevoerde gegevens toegestaan, actueel en voldoende gestructureerd voor de taak?
- Kan een persoon acties met grote gevolgen of onomkeerbare acties beoordelen?
- Zijn fouten zichtbaar, herstelbaar en toegewezen aan een verantwoordelijke?
- Kan het team vóór en na de pilot de afhandeltijd, het correctiewerk, de softwarekosten, incidenten en de kwaliteit van de resultaten meten?
Een dagelijks rapport over afwijkingen is een voorbeeld. Software kan goedgekeurde gegevens ophalen, verschillen berekenen, een toelichting opstellen en die naar een beoordelaar sturen. De businesscase moet uitgaan van het werkelijke aantal zoekopdrachten binnen de organisatie, de beoordelingstijd, de kosten van fouten, platformkosten en de benodigde onderhoudsinspanning.
Presenteer berekende besparingen niet als het resultaat van een afgeronde implementatie door AIGROW.
Hoe ga je om met weerstand van medewerkers en training tijdens de implementatie van agents?
Begin waar de kostenbesparing zit: backofficeworkflows die rechtstreeks kosten vervangen. Weerstand van medewerkers is, na integratieproblemen, de op één na meest voorkomende reden waarom implementaties van AI-agents vastlopen. Dat is goed te voorspellen.
Dit maakt training extra belangrijk: medewerkers moeten leren agents te begeleiden, te controleren en zo nodig in te grijpen, in plaats van ze alleen als hulpmiddel te gebruiken.
- Ontwerp samen met de medewerkers die de agent gaan gebruiken. Bouw niet afzonderlijk iets om het daarna over te dragen. Betrek de persoon die het proces nu handmatig uitvoert bij het ontwerp van de workflow. Die kent uitzonderingen die jij over het hoofd ziet.
- Begin in de 'copilot-modus'. De agent produceert resultaten, maar voert geen acties uit. Een persoon beoordeelt ze en geeft goedkeuring. Zo groeit het vertrouwen en komen uitzonderingen aan het licht voordat de agent zelfstandig werkt.
- Maak een inzichtelijk auditspoor. Medewerkers moeten kunnen zien wat de agent heeft gedaan, waarom die elke beslissing nam en welke data daarbij zijn gebruikt. Zonder transparantie is weerstand begrijpelijk.
- Omschrijf de rol van de medewerker opnieuw. Zeg tegen je team: 'Jij voert het werk niet meer zelf uit. Je houdt toezicht op de agent die het werk doet.' Dat vermindert de angst om vervangen te worden en geeft de mens de regie.
- Plan een overgang van 90 dagen. Week 1-4: copilot-modus met volledige beoordeling door een persoon. Week 5-8: de agent voert acties uit, waarna een persoon ze beoordeelt. Week 9-12: de agent werkt zelfstandig en een persoon grijpt in bij uitzonderingen.
Demo's van leveranciers laten beperkingen van de productieomgeving vaak buiten beeld. Vraag om logboeken, procedures voor fouten, duidelijke toegangsrechten, evaluatieresultaten en een manier om terug te draaien voordat je een demo als bewijs ziet dat het systeem klaar is voor dagelijks gebruik.
Maar na elke implementatie die wij hebben uitgevoerd, zien we hetzelfde resultaat: medewerkers gaan van taken uitvoeren naar kwaliteit bewaken, en het team pakt waardevoller werk op dat eerder bleef liggen. Behandel verandermanagement bij de implementatie van AI-agents voor de automatisering van bedrijfsprocessen als een technisch onderdeel van het project, met mijlpalen, verantwoordelijken en meetbare succescriteria.
Actuele Claude-, GPT-, Gemini- en Grok-modellen, tot 75% onder de catalogusprijs
Eén API-sleutel voor Claude-, GPT-, Gemini- en Grok-modellen via de OpenAI SDK. Claude-modellen werken ook met de Anthropic SDK en Claude Code.
Het tarief van elk model via AIGROW-tegoed staat naast de catalogusprijs van de maker en komt daar nooit boven.
Veelgestelde vragen
