Når du spør «et markedsføringsteam orkestrerer kampanjeressurser på tvers av team og plattformer. passer dette scenarioet for agentbasert ki eller ikke? ja nei», er det entydige svaret ja, forutsatt at du innfører streng styring, smale spesialistagenter og menneskelig kontroll i prosessen for å håndtere overleveringer mellom team.
Bygger du med KI-modeller? AIGROW API-kreditt kjører modeller fra Claude, GPT, Gemini og Grok opptil 75 % under listepris.
- Ja, orkestrering av kampanjeressurser på tvers av team og plattformer passer godt for agentbasert KI, forutsatt at styring og integrasjonsmodenhet er på plass.
- Uten et orkestreringslag gir flere KI-agenter «agentkaos» i stedet for et koordinert system.
- En hybrid tilnærming, der KI håndterer rutinemessig koordinering og mennesker godkjenner viktige beslutninger, reduserer risikoen for enkeltpunktsfeil i hub-and-spoke-arkitekturer.
- Regelen «én agent, én oppgave» forhindrer kontekstforfall og gjør smale agenter enkle å bytte ut, versjonere og revidere.
- Tilsynsagenter som er bygget for etterlevelse, datakvalitet og kostnadsovervåking skalerer tillit bedre enn menneskelig gjennomgang av alt som produseres.
Trinn 1: Hvordan avgjør scenarioets kompleksitet om agentbasert KI passer?
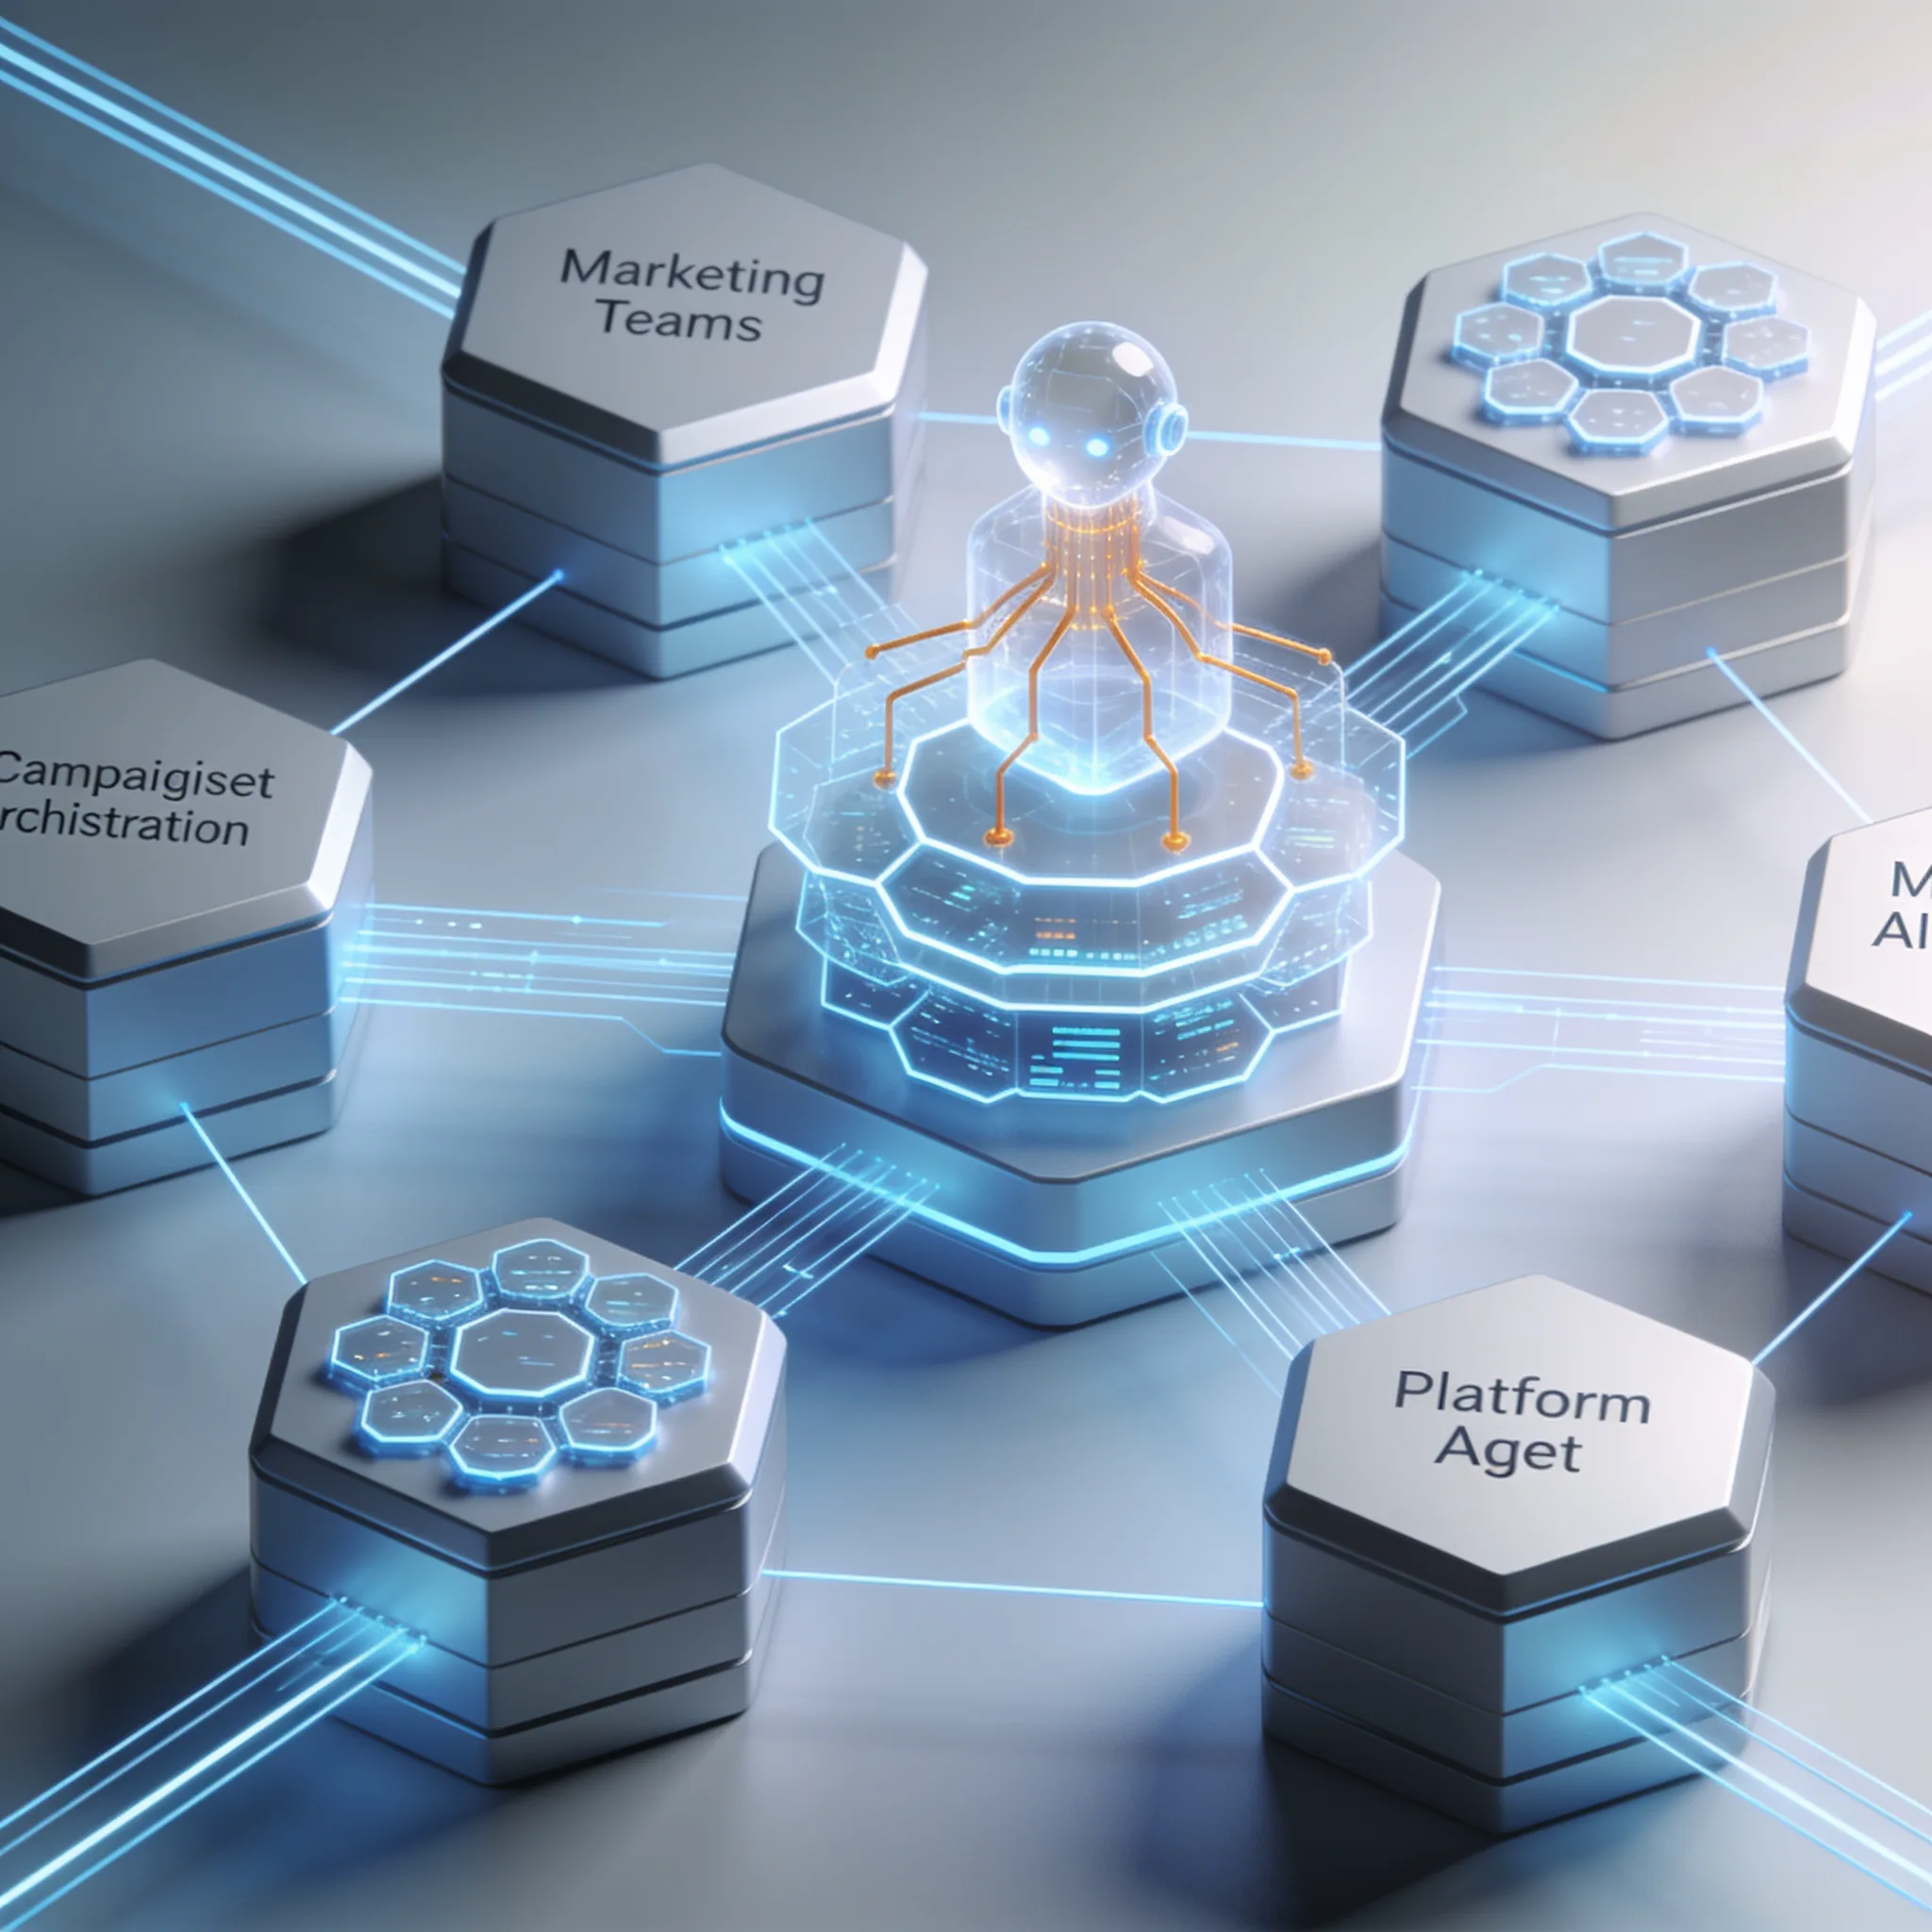
Agentbasert KI-orkestrering koordinerer flere agenter. Agentene samarbeider om å utføre komplekse markedsføringsarbeidsflyter, og hver av dem har en definert rolle, tilgang til bestemte verktøy og et strengt beslutningsomfang. Orkestreringslaget styrer avhengigheter aktivt og tar seg av alle nødvendige overleveringer mellom agenter.
Det holder fremdriften på sporet. Uten denne sentrale koordineringen har du bare en samling frakoblede, uavhengige agenter. Med den får du et samlet og velfungerende driftssystem.
Vår konklusjon er et tydelig ja. Spør du om det passer for agentbasert KI at et markedsføringsteam orkestrerer kampanjeressurser på tvers av team og plattformer, er svaret at samarbeid på tvers av team skaper ikke-lineære avhengigheter som regelbaserte systemer rett og slett ikke klarer å håndtere. Du trenger adaptiv ruting for å mestre disse svært komplekse avhengighetene i driften.
Regelbaserte verktøy svikter her. De bryter sammen med en gang når uforutsigbare spesialtilfeller dukker opp, og derfor anbefaler vi sterkt adaptiv ruting for alle team som orkestrerer ressurser på flere plattformer i 2026.
La oss se på markedssignalene. Skiftet skjer nå. Hvis du venter til markedet er fullt modent før du bygger de første prototypene, har konkurrentene dine allerede sikret seg fordelene ved å komme tidlig i gang.
For en kompleks kampanje bør du bygge en kostnadsmodell basert på faktiske arbeidstimer, tid til gjennomgang, verktøyavgifter, modellbruk, retting av feil og hendelser. Se på den som en planleggingsøvelse, og bytt ut hver inndata med målte data før du hevder at du sparer penger eller når break-even.
Er du klar for denne arkitekturen? For å kvalifisere må arbeidsflyten din kreve justeringer i sanntid basert på engasjementsdata, og overleveringene mellom teamene må innebære at ressurser flyttes mellom tekst, design og distribusjon, med ulike verktøy. Hvor moden integrasjonen din er, har også mye å si for en vellykket utrulling.
Ikke bruk enkel automatisering.
- Arbeidsflytens kompleksitet: Krever kampanjen justeringer i sanntid basert på engasjementsdata?
- Overleveringer mellom team: Flyttes ressurser mellom tekst-, design- og distribusjonsteam som bruker ulike verktøy?
- Integrasjonsmodenhet: Kan dagens stack tilby rene API-er som agenter kan bruke?
Hvis du skårer høyt på to av disse tre punktene, trenger du agentbasert orkestrering umiddelbart. Ikke prøv å lappe på dette med enkle automatiseringsflyter, for de vil uunngåelig svikte under press.
Trinn 2: Agentbasert orkestrering sammenlignet med regelbaserte alternativer og løsninger med én agent
Sammenlign multiagentsystemer med alternativene. Skal du avgjøre om det passer for agentbasert KI at et markedsføringsteam orkestrerer kampanjeressurser på tvers av team og plattformer, må du vite at en tradisjonell integrert B2B-kampanje kan involvere rundt et dusin personer. En tradisjonell integrert B2B-kampanje bruker vanligvis fire eller fem sentrale verktøy.
Det tar uker. En tradisjonell integrert B2B-kampanje bruker 3 til 6 uker fra brief til lansering, og det betyr at de manuelle flaskehalsene vokser raskt i hvert eneste tverrfaglige team som er involvert i prosessen.
Regelbasert automatisering fungerer for lineære oppgaver. Systemer med én agent fungerer for avgrensede oppgaver, men ingen av dem håndterer orkestrering av ressurser på tvers av team godt. Når en tekstforfatter trenger SEO-data fra ett verktøy, designressurser fra et annet og et distribusjonsvindu fra et tredje, brytes overleveringene.
Kompleksiteten knekker dem.
Regelbaserte systemer svikter i det stille her. Hvorfor svikter akkurat disse systemene så stille, uten forvarsel? Systemer med én agent svikter derimot raskt gjennom et fenomen som kalles alvorlig kontekstforfall. De når tokengrensene fort.
Når én stor språkmodell prøver å holde SEO-research, generering av annonsetekster og formateringsinstruksjoner for CMS i kontekstvinduet samtidig, begynner en agent som nærmer seg modellens kontekstgrense å miste de tidligste instruksjonene. Den glemmer merkevarens tone. Den glemmer retningslinjene for tone helt og produserer innhold som ikke passer merkevaren.
Derfor kan du ikke stole på at én enkelt agent styrer hele livssyklusen til en markedsføringskampanje uten mye menneskelig inngripen.
Orkestrering med flere agenter kommer til sin rett her. Det gjelder når verktøylandskapet er sterkt fragmentert og teamene er asynkront avhengige av hverandre. Orkestratoren fungerer som en sentral som sender nøyaktig den tilstanden den neste spesialistagenten trenger (som en flygeleder).
Orkestratoren bruker et felles minne for alle driftsoppgaver. Ingen enorme tokenblokker. I stedet for å sende videre en kontekstblokk på 80k tokens skriver hver agent et standardisert JSON-resultat, og den neste agenten leser bare de feltene den trenger.
Da faller datamengden til 4k tokens, noe som reduserer ventetid og kostnader.
Tenk deg dette avgrensede spesialtilfellet i et sandkassemiljø. Når et designteam bruker et verktøy uten offentlig API, svikter både regelbaserte systemer og systemer med én agent fullstendig, fordi de ikke får tilgang til ressursene. Et system med flere agenter løser det på en elegant måte.
Orkestratoren oppdager det manglende API-et med en gang og handler raskt. Den setter i gang en e-postagent. Agenten ber en menneskelig designer om ressursene, tolker e-postsvaret når ressursene kommer, og tar deretter opp arbeidsflyten automatisk igjen uten å miste et eneste steg.
Tenk så på globale, samtidige kampanjer. Når et globalt merke kjører samtidige kampanjer i Nord-Amerika og Europa, krever et regelbasert system en egen arbeidsflyt for hver region. Det doblerer vedlikeholdet og gjør de regionale reglene for etterlevelse uoversiktlige.
Europa krever strengt GDPR-samtykke for sporing i e-post, i motsetning til Nord-Amerika. Ikke bland reglene.
Orkestratoren med flere agenter løser dette. Den sender den europeiske kampanjen til en etterlevelsesagent som håndhever GDPR-reglene før ressursene går videre til distribusjonsagenten, mens den nordamerikanske kampanjen hopper over akkurat denne agenten og tar en raskere vei. Dynamisk ruting vinner.
Slik dynamisk ruting basert på regionale metadata er umulig med lineære alternativer, siden du da måtte bygge og vedlikeholde to helt separate Zapier-trær, mens systemet med flere agenter bruker betinget ruting i én enkelt graf.
| Scenarioegenskap | Regelbasert automatisering | System med én agent | Orkestrering med flere agenter |
|---|---|---|---|
| Verktøyintegrasjon | Statiske API-kall, 1 til 1 | Bred, men grunn kontekst | Dyp, dynamisk verktøytilgang per agent |
| Tilpasningsevne | Lav, svikter ved spesialtilfeller | Middels, utsatt for kontekstforfall | Høy, agentene spesialiserer seg og tilpasser seg |
| Overlevering mellom team | Manuell eller stive utløsere | Flaskehals i én prompt | Fordelt via orkestratoren |
| Kampanjens syklustid | 3 til 6 uker | 2 til 4 uker | Under 5 dager |
Vi flyttet produktlanseringen vår i Q3 2026 over til en stack med flere agenter og kortet ned tiden fra brief til lansering fra fire uker til seks dager, mens alternativet med én agent slet med kontekstvinduet. Vi prøvde først å blande SEO-research og generering av annonsetekster. Systemet diktet opp tall for annonsebudsjettet.
Det diktet opp tallene fordi det ikke klarte å skille researchkonteksten fra tekstkonteksten, og det er en fatal svakhet for alle team som prøver å samle arbeidsflytene i én enorm prompt. Alt dette er **et markedsføringsteam som orkestrerer kampanjeressurser på tvers av team og plattformer. passer dette scenarioet for agentbasert ki eller ikke?
ja nei**.
Motstemmen: Hvorfor hub-and-spoke-arkitektur svikter i koordinering mellom team uten hybrid kontroll
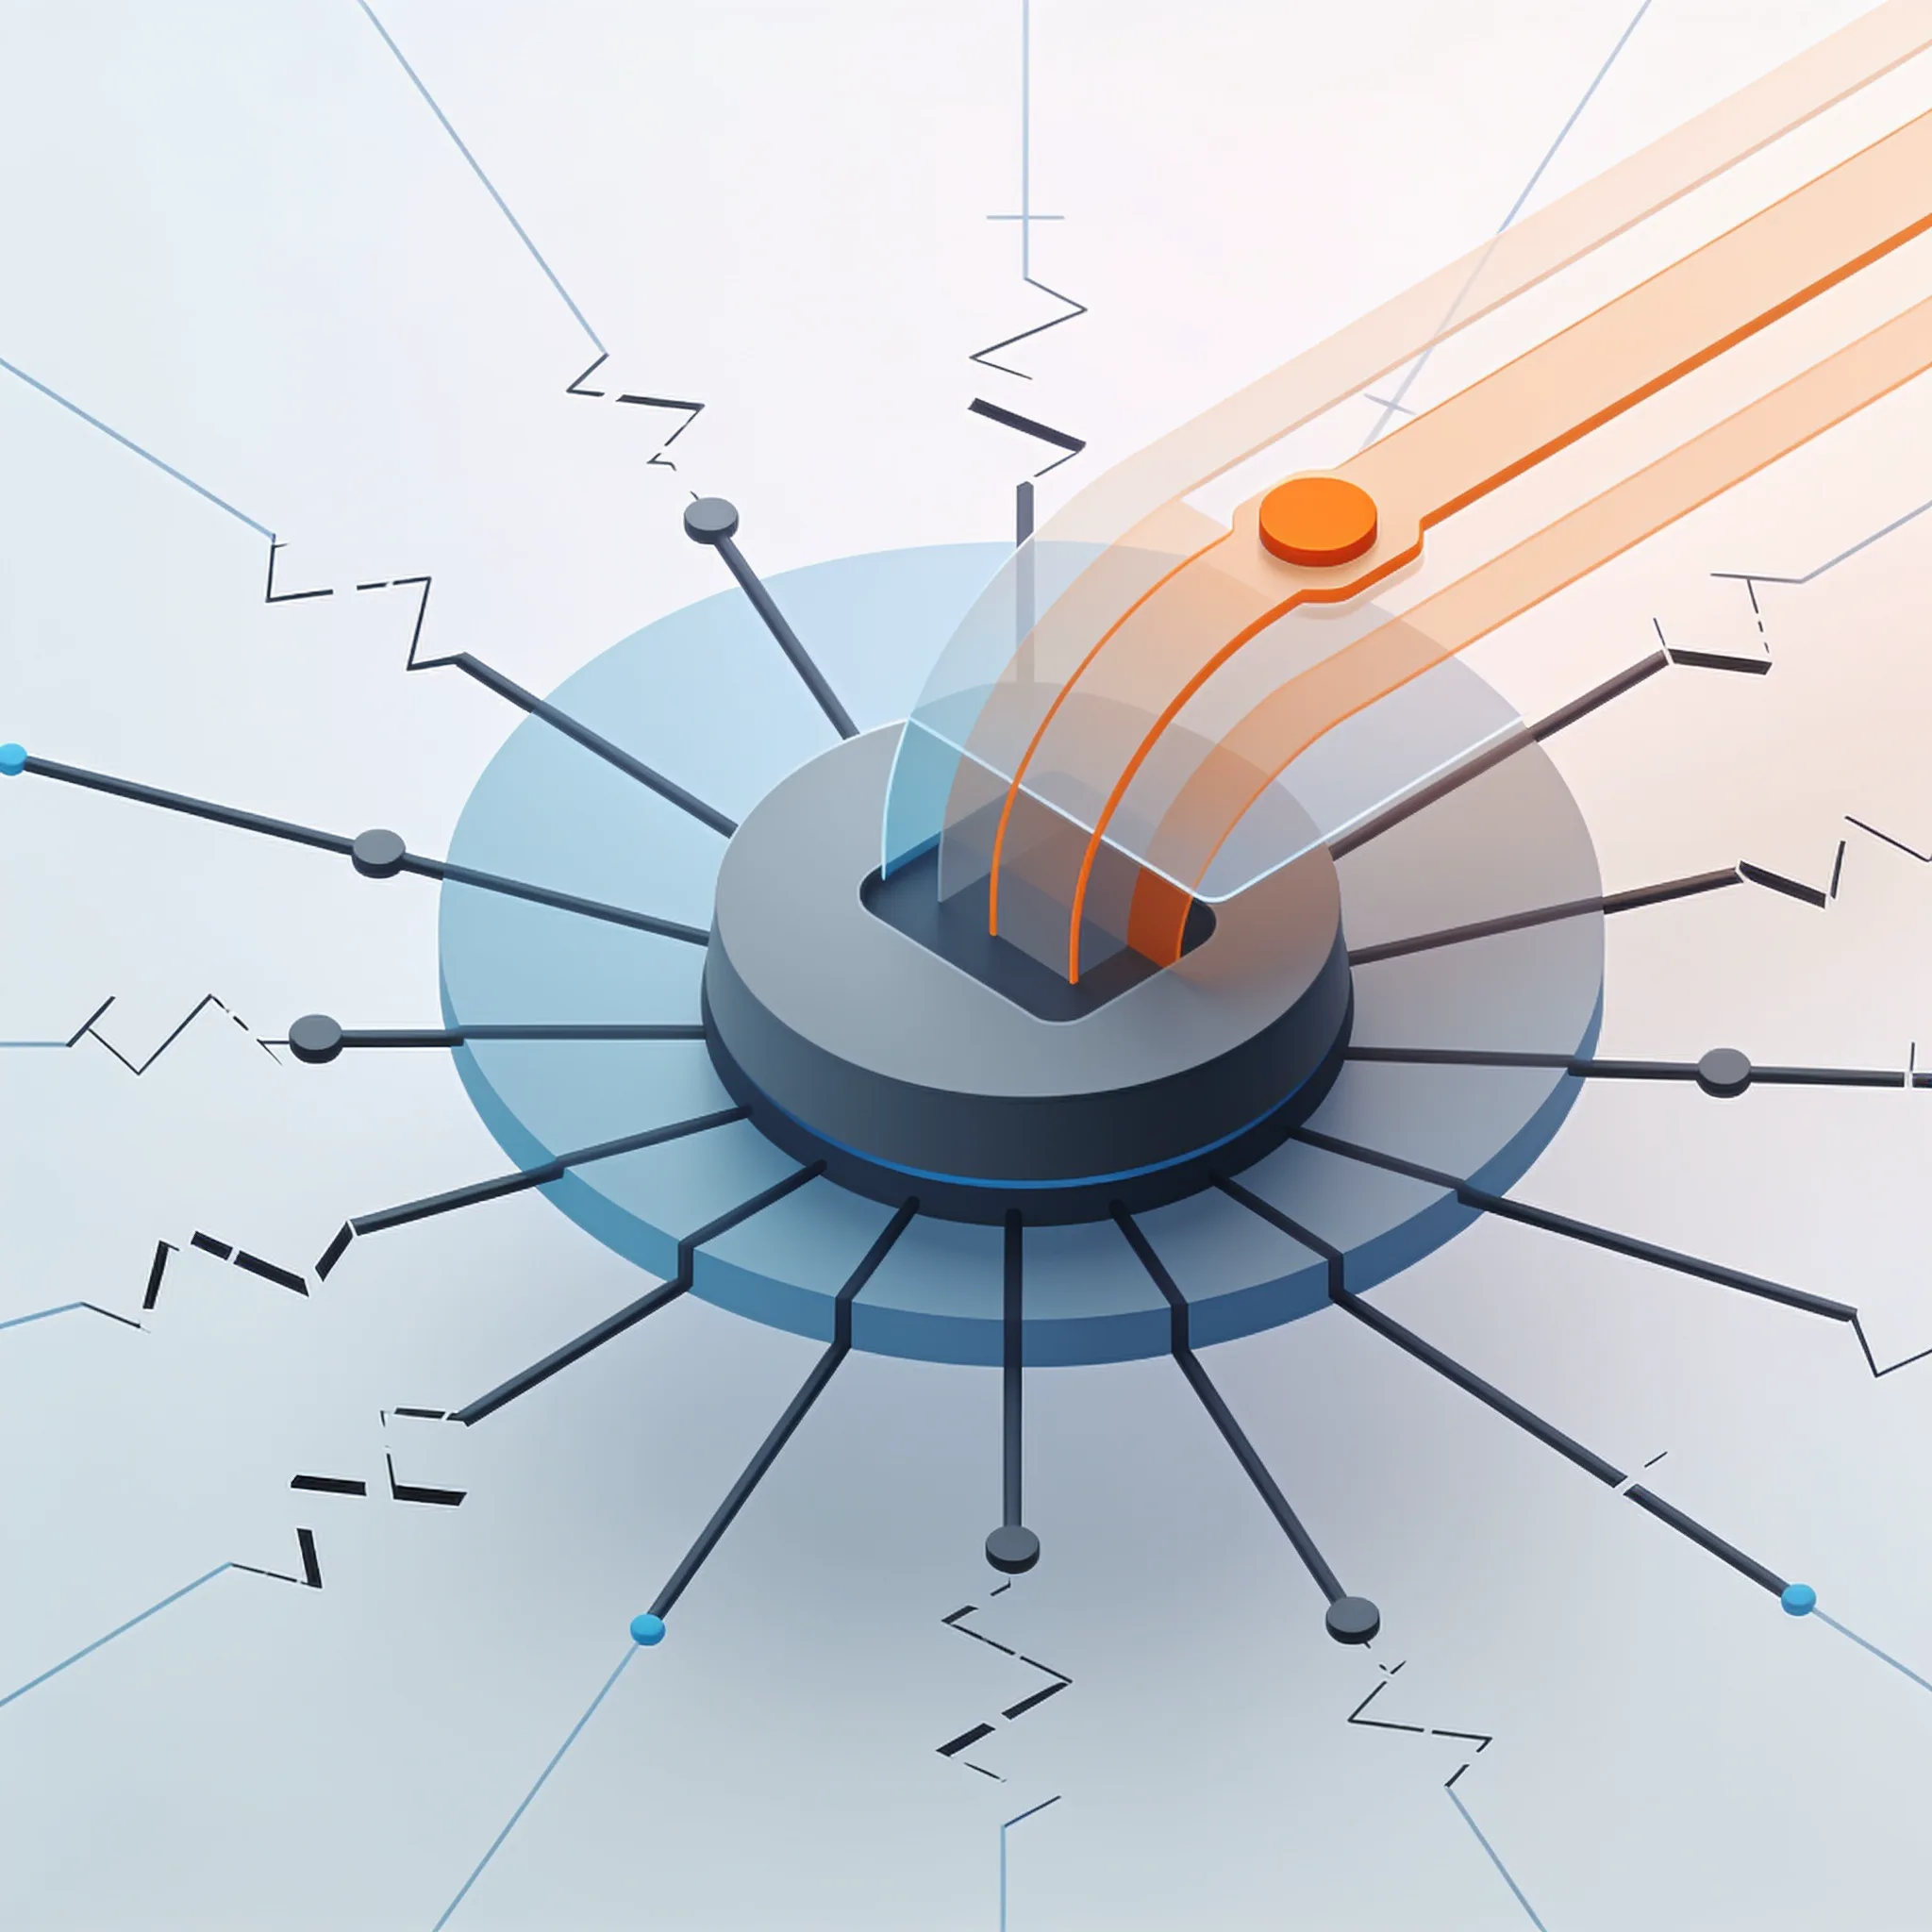
Hub-and-spoke er det vanligste mønsteret. Spør du om et markedsføringsteam som orkestrerer kampanjemateriell på tvers av plattformer passer for agentbasert KI, vil folk vise til hub-and-spoke, der en sentral orkestrator fordeler oppgaver til spesialister. I dag egner det seg best for komplekse kampanjer og lanseringer av produkter i flere kanaler.
Men huben er et sårbart punkt.
Hvis supervisor-agenten hallusinerer eller krasjer, fryser kampanjen, og systemet bryter sammen. Supervisor-agenten holder tilstandsgrafen i minnet og går i vranglås når den treffer en grense for antall forespørsler (noe som skjer ofte). Den prøver å komme seg på beina ved å forsøke på nytt.
På grunn av API-begrensningene kan den låse kontoen. Det skjedde i april 2026, da en kunde i finanssektoren kjørte en hub-and-spoke-modell og nådde en OpenAI-grense på 500 forespørsler per minutt. Orkestratoren krasjet og stoppet en annonselansering til 50 000 dollar midt i løpet, helt uventet.
Krasj fører til at tilstand under behandling går tapt. Når supervisor-agenten krasjer, mister den tilstanden til alle agentene som rapporterer til den. Hvis SEO-researcheren akkurat har fullført en gjennomgang på 10 minutter og sendt resultatene, må jobben gjøres om igjen.
Det sløser enorme mengder regnekraft og forsinker driften kraftig. Lagring av tilstand løser krasjproblemet, men ikke flaskehalsen: Når 50 ressurser går gjennom pipelinen, må supervisoren tolke 50 fullføringsmeldinger, bestemme neste steg for hver av dem og sende ut 50 nye oppgaver. Seriell behandling begrenser gjennomstrømmingen.
Orkestratoren kan være et menneske eller KI. I 2026 bruker de fleste team en hybrid løsning der KI tar seg av den rutinemessige koordineringen, mens mennesker legger strategien og godkjenner avgjørelser med store konsekvenser. Ren KI-orkestrering svikter i spesialtilfeller, og ren menneskelig orkestrering lar seg ikke skalere.
Hybridmodeller vinner.
Forsinkelse er den åpenbare ulempen. Hub-and-spoke reduserer forsinkelsen fordi alle agenter snakker med én supervisor, men et menneske i løkken gir enda mer forsinkelse. Løsningen er en lagdelt hub-and-spoke-modell.
Du bør gi hvert enkelt operative team sin egen under-supervisor. Lagdelt ruting fungerer. En tekstsupervisor styrer SEO-, innholds- og redigeringsagentene, mens en designsupervisor styrer bilde-, video- og formateringsagentene.
Dermed snakker hovedorkestratoren bare med under-supervisorene, noe som reduserer belastningen på huben med 80 % og samtidig holder systemet sporbart. Du trenger fortsatt menneskelig tilsyn. Du trenger fortsatt menneskelig tilsyn på hovedorkestratorens nivå for å løse konflikter mellom under-supervisorene for tekst og design.
Når SEO- og CRM-data er uenige, bør budsjettendringer rutes til en ansvarlig person. Test porten mot teamets egen feilrate i stedet for å knytte en udokumentert prosentandel til den.
Fjern det enkeltstående sviktpunktet. For å gjøre det trenger du disse konkrete sikkerhetsmekanismene med én gang. Start med en enkel LangGraph v0.2-supervisorkonfigurasjon som krever menneskelig godkjenning før distribusjon:
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.memory import MemorySaver


def human_approval_node(state):
 # Halts execution until human reviews the plan
 return {"status": "pending_approval"}


workflow = StateGraph(dict)
workflow.add_node("supervisor", supervisor_agent)
workflow.add_node("human_gate", human_approval_node)
workflow.add_edge("supervisor", "human_gate")
workflow.add_conditional_edges("human_gate", lambda x: "execute" if x["status"] == "approved" else END)
app = workflow.compile(checkpointer=MemorySaver())
Ikke hopp over disse stegene. Hvis du overser dem, krasjer systemet ditt i det verst tenkelige øyeblikket, og det koster deg tusenvis av dollar i bortkastede annonsekroner og tapt kundetillit.
Steg 3: Hvilke agentroller og verktøy trenger en markedsføringsstack på tvers av plattformer?
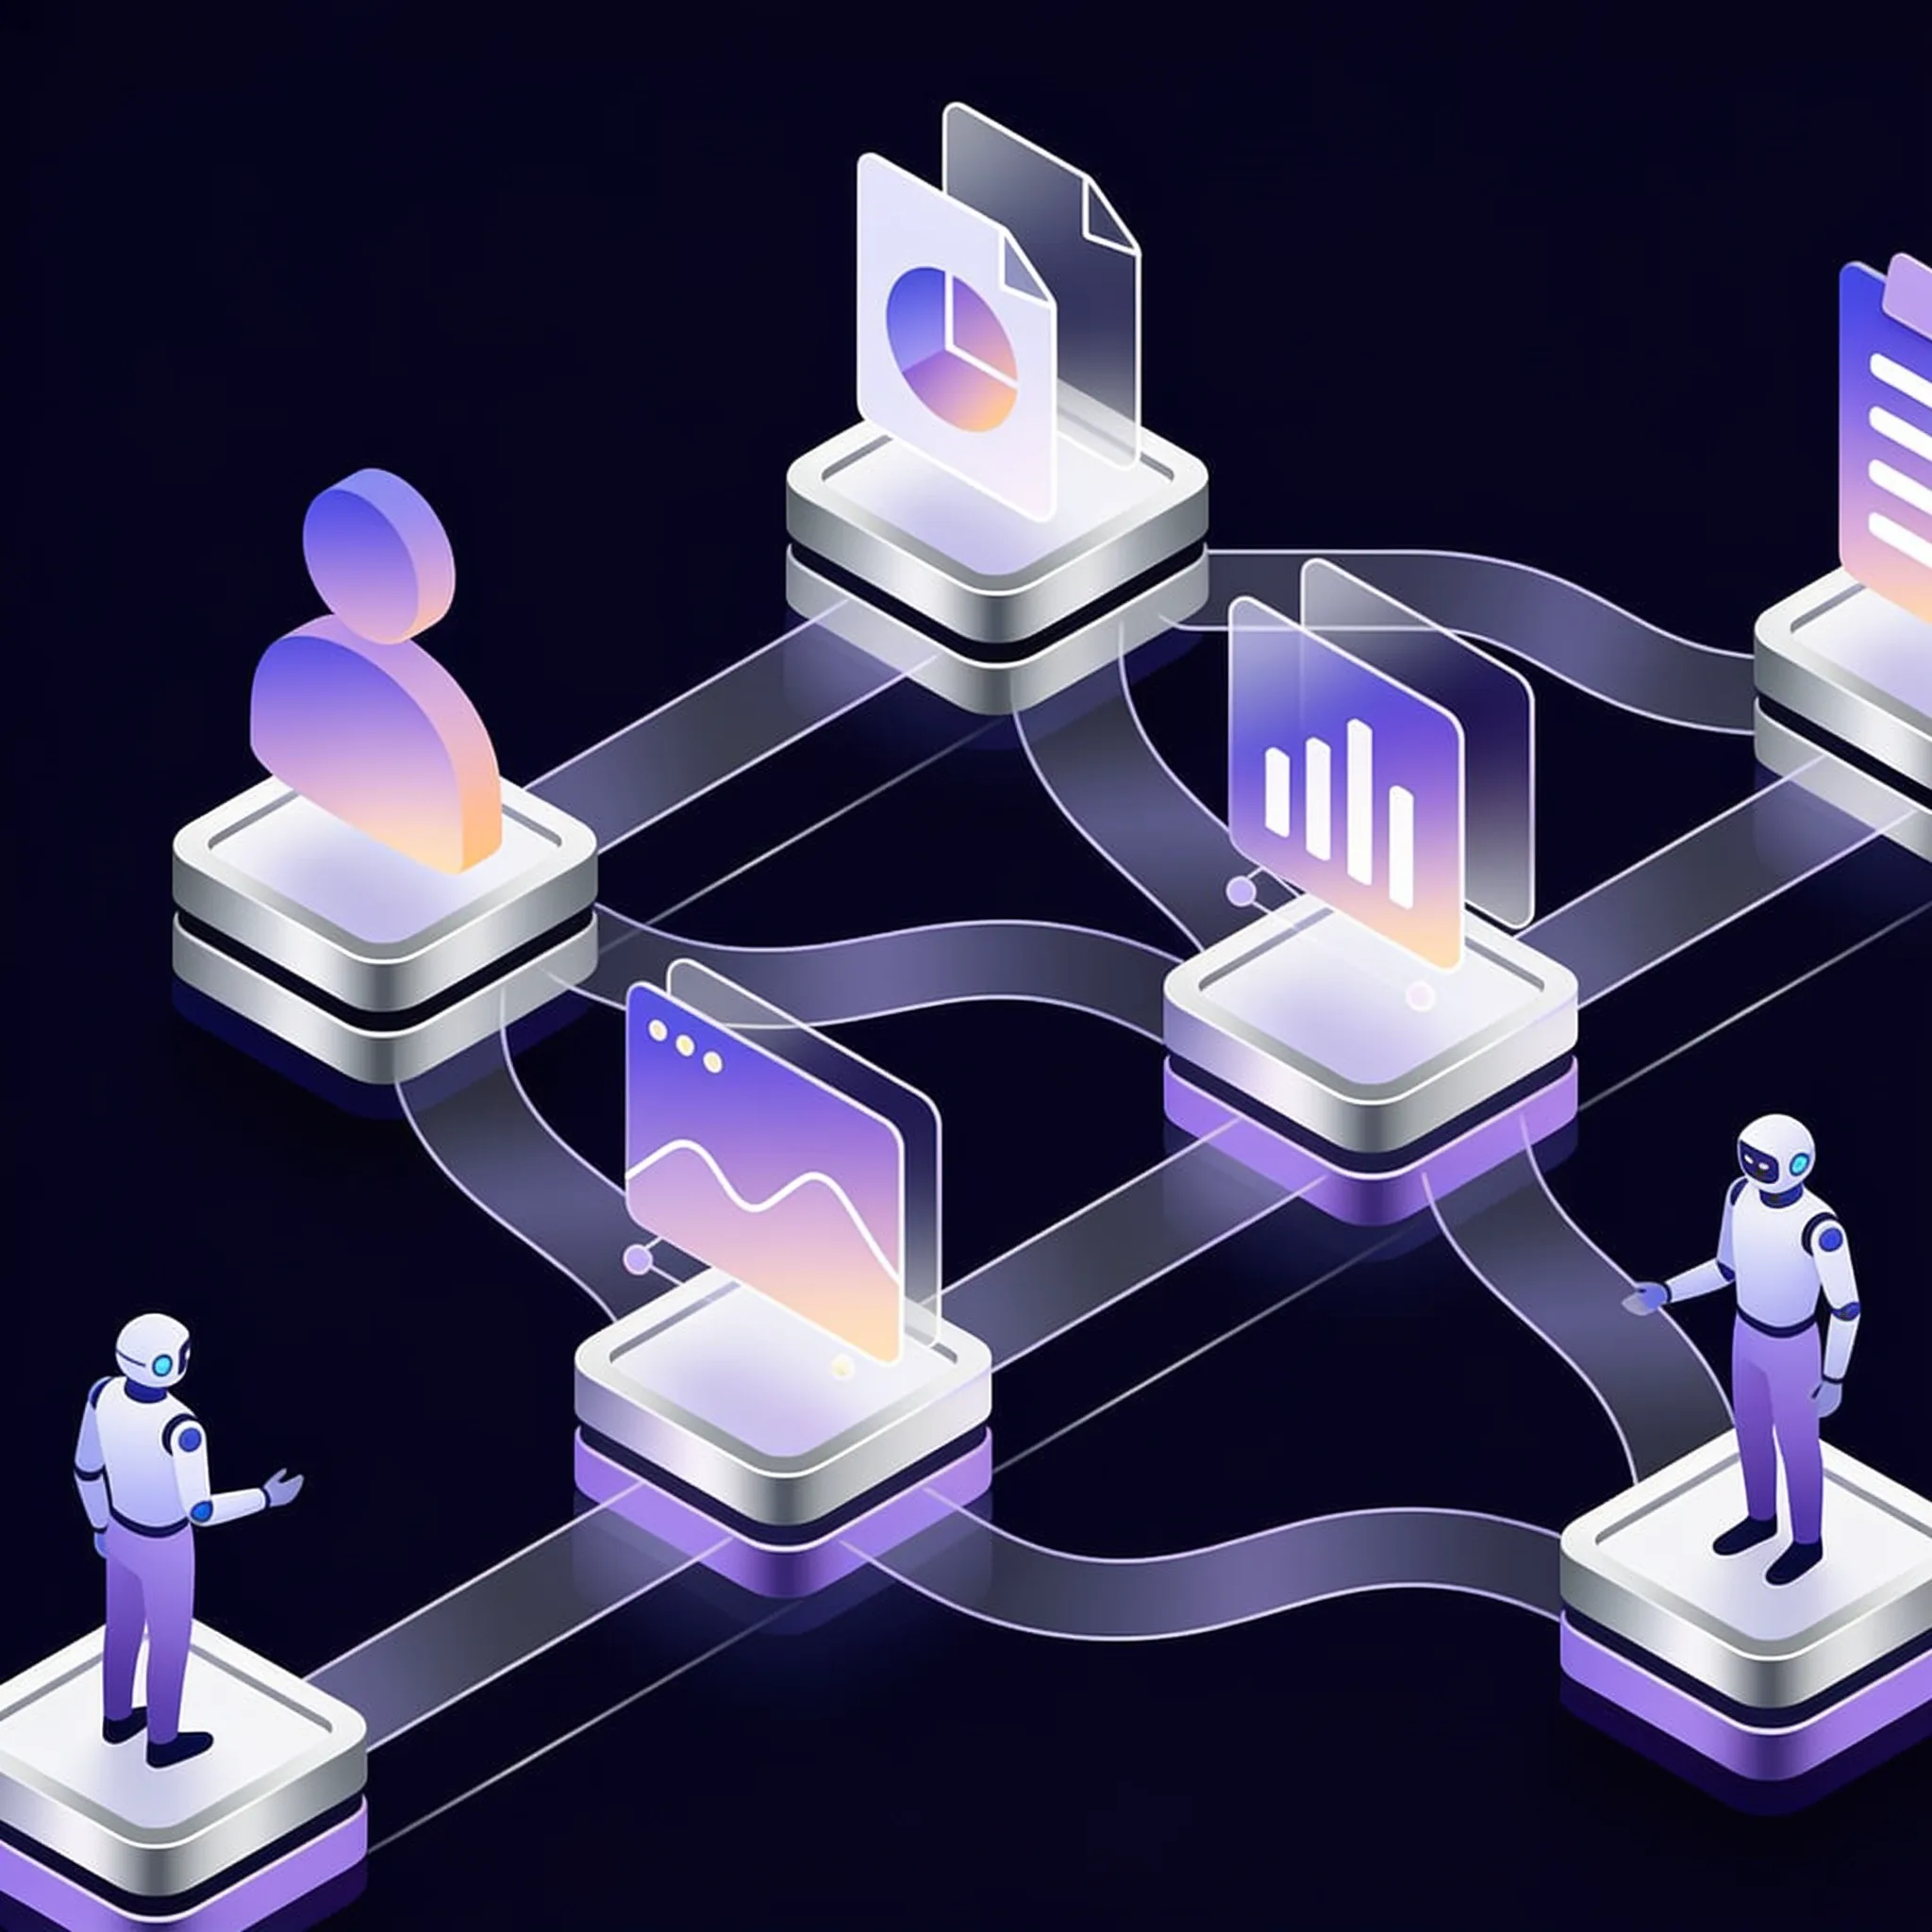
En markedsføringsstack på tvers av plattformer krever smale spesialister. Den krever et register over smale spesialistagenter, styrt av en orkestrator som tolker markedsførerens intensjon, velger ferdigheter og driver kampanjen fra brief til analyse. Agentene må følge regelen om én oppgave for å unngå forfall av kontekst og sikre sporbare feil gjennom hele arbeidsflyten.
Du må kartlegge arkitekturen nøye. Når du vurderer om et markedsføringsteam som orkestrerer kampanjemateriell på tvers av team og plattformer passer for agentbasert KI, tolker orkestratoren markedsførerens intensjon, velger agenter fra et register, bekrefter planen og driver kampanjen. En typisk arbeidsflyt kjeder sammen seks spesialistagenter: research (de 50 beste nøkkelordene), strategi (velg 12 målnøkkelord), innhold (skriv 12 innlegg), SEO (forbedring og intern lenking), distribusjon (planlegging og sosiale medier) og analyse (sporing og ukentlige rapporter).
Hovedregelen er streng.
Registerets hovedregel er én agent, én oppgave. Agenter som skal dekke flere jobber samler opp for mye kontekst, blir dårligere og svikter på måter som er vanskelige å spore. Smale agenter holder konteksten liten.
De holder konteksten liten og feilene sporbare, og de gjør agentene utskiftbare og versjonerbare, slik at én agent som presterer dårlig kan byttes ut uten å rulle tilbake hele systemet.
Her er JSON-konfigurasjonen. Dette er en JSON-konfigurasjon for å opprette agenter med LangChain v0.3 og CrewAI v0.40:
{
 "campaign_id": "q4_saas_launch",
 "orchestrator": {
 "type": "supervisor",
 "framework": "LangGraph_v0.2",
 "human_in_loop": true
 },
 "agents": [
 {
 "name": "SEO_Researcher",
 "role": "Extract top 50 keywords from web data",
 "tools": ["Ahrefs_API", "SerpAPI"],
 "model": "claude-sonnet-5-5"
 },
 {
 "name": "Content_Writer",
 "role": "Write 12 posts from target keywords",
 "tools": ["Internal_CMS"],
 "model": "gpt-6-luna"
 }
 ]
}
Vi bruker en streng beslutningstabell. Den kobler scenarioets egenskaper til riktig agentoppsett, slik at du velger riktig arkitektur for dine egne driftsbehov uten å gjette.
| Scenario Attribute | Single Broad Agent | Narrow Specialist Agents |
|---|---|---|
| Context Limit | Hits limit fast | Fits easily in window |
| Error Tracing | Diffuse, hard to pin down | Isolated to one node |
| System Upgrades | Requires full rollback | Swap one agent version |
Følg disse vedlikeholdsreglene nøye:
- Definer strenge skjemaer for inndata og utdata for hver agent.
- Overvåk tokenbruk per agent for å fange opp løpske løkker.
- Versjoner agentenes prompter atskilt fra koden din.
Hvis du ignorerer disse viktige stegene, vil hele orkestreringsrammeverket kollapse under sin egen vekt, og det koster deg mye tid, penger og tillit hos interessentene i organisasjonen.
Steg 4: Etabler styring for å hindre agentkaos i arbeidsflyter på tvers av team
Du må ta tak i styring med én gang. Når du spør om et markedsføringsteam som orkestrerer kampanjemateriell på tvers av team passer for agentbasert KI, må du ta opp styring. Uten den fører innebygde, oppgavespesifikke KI-agenter til agentkaos, overflødige bygg og uhåndtert risiko.
Team bygger ofte den samme agenten tre ganger, uavhengig av hverandre. Kvaliteten faller. Årsaken til kaoset er mangelen på et sentralt register.
Når designteamet bygger en agent for bildegenerering og sosiale medier-teamet bygger en tekst-til-bilde-agent hver for seg, bruker begge teamene DALL-E API-et. Uten utgiftsgrenser kan et selskap få en regning på 15 000 dollar fordi ingen av teamene fulgte med på bruken sin.
Tilsynsagenter kontrollerer utførende agenter. Vi bruker agenter for etterlevelse, samtykke, datakvalitet, evalueringsvurdering og utgiftsovervåking, fordi tillit skaleres gjennom agenter som er bygget for kontroll, ikke gjennom at mennesker gjennomgår alt som produseres. Hvis et menneske må sjekke hvert eneste blogginnlegg, har du ikke skalert.
Infrastruktur for Agent Ops er obligatorisk. Den omfatter kjøremiljø (isolerte økter per kampanje), evalueringer (testsett per endring av agent, prompt eller modell), observerbarhet (sporing av steg) og FinOps (token- og verktøykostnader per instans-ID). Du må vite nøyaktig hvor mye du bruker på SEO-agenten sammenlignet med innholdsagenten.
Isolerte kjøremiljøer forhindrer katastrofer. Isolerte kjøremiljøer i separate containere hindrer en løpsk agent i å bruke opp hele systemets minnebudsjett.
Følg kostnaden per godkjente handling, inkludert mislykkede evalueringer og nye forsøk, slik at dyre steg kan undersøkes.
En hypotetisk kostnadsgjennomgang kan vise at en dyr bildekontroll kan erstattes av deterministisk validering av dimensjoner. Mål godkjent resultat, korrigeringsrate og full kostnad for nye forsøk før og etter endringen.
Styring er tverrgående og håndheves. Styring er tverrgående og håndheves på alle lag, så policyen ligger utenfor agentkoden for å sikre at En slik ser a marketing team orchestrates campaign assets across teams and platforms. is this scenario a good fit for agentic ai or not? yes no ut i praksis.
Steg 5: Kartlegg overleveringer mellom team, menneskelige porter og sporbarhet for ansvar
For å sette rammeverket i drift må overleveringene kartlegges strengt. Hvis du fortsatt lurer på «a marketing team orchestrates campaign assets across teams and platforms. is this scenario a good fit for agentic ai or not? yes no», er svaret ja, men bare hvis du kartlegger de menneskelige portene.
Hver menneskegodkjente agentbaserte kampanjebevegelse blir sin egen isolerte tilstand, med sin egen agentblanding, sitt eget minne og sin egen logg. Det gjør at hundrevis av kampanjer kan kjøre parallelt uten å påvirke hverandre. Det gjør også hver kampanje fullt reviderbar.
Hvis én kampanje feiler, ødelegger den ikke minnet til en annen.
KI-drevet kampanjeorkestrering bruker KI til å planlegge, generere, koordinere og optimalisere alle elementer i en kampanje ut fra én strategisk brief. Den behandler kampanjen som ett sammenhengende system med innhold, målretting, timing og tilbakemeldingssløyfer i sanntid. Det er i overleveringene dette systemet enten holder sammen eller faller fra hverandre.
Her er et enkelt Mermaid-diagram som viser flyten:
Slik setter du dette i drift: * Kartlegg hver nødvendige godkjenning før du starter orkestratoren. * Gi hver menneskelig port en tydelig eier. * Lagre hele tilstanden og revisjonssporet i et sentralt datavarehus.
Quiz om beredskap for multiagent-orkestrering
Vurder hvor klart teamet ditt er for orkestrering av agentbasert KI på tvers av plattformer.
Hvordan håndterer teamet ditt overleveringer av materiell mellom team i dag?
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller, opptil 75 % under listepris
Én API-nøkkel til modellene fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellene fungerer også med Anthropic SDK og Claude Code.
Prisen for hver modell via AIGROW-kreditt ligger ved siden av utviklerens listepris, aldri over den.
Ofte stilte spørsmål
