Automatisering af kundeonboarding med AI erstatter statiske produktture med samtaler, der forstår brugerens hensigt og tilpasser sig det, den enkelte vil opnå. Denne guide gennemgår, hvorfor gamle ture fejler, hvordan du opbygger onboarding-stacken fra bunden, hvordan du designer de første 90 sekunders samtale, og hvilken bedømmelseslogik der skal til for at køre systemerne i stor skala.
Bygger du med AI-modeller? AIGROW API-kredit kører Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listeprisen.
- Mål aktiveringen efter 14 dage op mod dit nuværende onboardingforløb, før du udvider samtalebaseret AI til flere brugere.
- Statiske indtastningsformularer og gamle guide-overlays sender alle brugere ad samme vej. AI-native onboarding erstatter dem med en samtale på 90 sekunder, der afdækker brugerens hensigt.
- En solid arkitektur til AI-onboarding kræver en LLM, en vektordatabase til routing af hensigter og en CRM-webhook til strukturerede tilbageskrivninger af data.
- Resultatbedømt aktivering flytter fokus fra at tælle klik på funktioner til at vurdere, om brugeren har opnået et meningsfuldt forretningsresultat.
- Trods hypen om fuld autonomi viser 10-20-70-reglen, at de mest effektive implementeringer blander 10 % fuldt autonome opgaver, 20 % AI-assisterede og 70 % menneskeledede opgaver med AI-støtte.
Hvorfor bør du erstatte gamle produktture med AI-automatisering af kundeonboarding?
Hvis du stadig bygger klik-igennem-guides, mister du brugere. Automatisering af kundeonboarding med AI bruger store sprogmodeller til at erstatte statiske produktture med dynamiske samtaler, der forstår brugerens hensigt. Metoden fanger brugerens kontekst i realtid, så systemet kan skabe personlige aktiveringsforløb i stedet for at tvinge brugerne gennem generiske tjeklister, der ignorerer deres konkrete roller.
Et pilotprojekt kan vise, om samtalebaseret onboarding forbedrer aktiveringen hos dine brugere.
Gamle produktture går ud fra, at alle brugere har brug for den samme gennemgang i 5 trin. Det har de ikke. En marketingchef skal koble data om annonceforbrug til, og en dataingeniør skal kontrollere pipelinens skema, men statiske ture kan ikke skelne mellem de to roller.
Hvorfor vælte det samme indhold ind over brugerfladen? Det skaber voldsom friktion og får kunder til at forlade produktet.
Til en hypotetisk onboarding-pilot i en SaaS-virksomhed bør du følge aktivering, tid til første værdi, uløste spørgsmål, rettelsesrate og eskalering til support. Brug virksomhedens egen baseline og de observerede værdier fra piloten frem for et opdigtet datasæt på tværs af virksomheder.
| Funktion | Gamle ture (Pendo, Appcues) | AI-samtalelag |
|---|---|---|
| Arkitektur | DOM-injektion, statiske regler | Hændelsesdrevet, LLM-native |
| Brugerens hensigt | Forudvalgte rullelister | Udledt af fri tekst |
| Aktiveringsforløb | Generiske tjeklister | Personligt forløb i 3 trin |
| Tilbageskrivning af data | Simpel hændelsessporing | Strukturerede CRM-objekter |
| Aktivering efter 14 dage | Mål det eksisterende forløb | Mål piloten op mod den baseline |
Gamle ture er afhængige af præcise selektorer, som går i stykker, når brugerfladen opdateres. AI-samtalelag ligger derimod uden for brugerfladen. De indlæser adfærdshændelser, behandler hensigten via en LLM og leverer vejledning gennem en chatbot eller et dynamisk banner, hvilket gør dem meget robuste over for ændringer i produktet.
Automatisering af kundeonboarding med AI kræver en bestemt stack. Du skal bruge en LLM til ræsonnement, en vektordatabase til hentning og hændelsesdrevne webhooks til CRM-integration.
Trin 1: Sådan opbygger du din tech stack til AI-onboarding fra bunden
En afkoblet hændelsesstrøm kan mindske direkte ændringer i den eksisterende database, men den stiller krav til levering, rækkefølge, genafspilning, privatliv og observerbarhed. Vurder de afvejninger op mod det faktiske system.
Disse modeller klassificerer hensigter og udtrækker begrænsninger fra samtaleinput. De gemmer ikke tilstand. Tilstand hører hjemme i din primære applikationsdatabase, så hold LLM'en helt tilstandsløs for at undgå oppustede kontekstvinduer.
Derefter opsætter du en vektordatabase som Pinecone eller Weaviate. Den fungerer som din vidensbase.
Når en bruger stiller et konkret spørgsmål om API-grænser, henter systemet netop det relevante stykke dokumentation. Det forankrer LLM'en og forhindrer hallucinationer. Hver AI-onboardingsamtale skal skrives tilbage til CRM'et som et struktureret objekt med hensigt, begrænsninger, hindringer, nævnte konkurrenter og "hvorfor nu", så din marketing- og salgsrouting kan udløses med det samme.
Disse data fodrer direkte din omsætningsmotor. Her er det centrale arkitekturflow:
Vi bruger et stramt JSON-skema til tilbageskrivningen. Mål tid til første værdi før og efter en pilot for at se, om arbejdsgangen hjælper nye brugere hurtigere i mål med et brugbart resultat. Webhooken skriver direkte til HubSpot eller Salesforce og udløser en Slack-alarm til kundeansvarlig, hvis der registreres en hensigt med høj værdi, så dit team aldrig overser et upsell-signal.
{
 "event_type": "onboarding_conversation_completed",
 "user_id": "usr_8821",
 "session_data": {
 "intent": "Migrate DB from Heroku",
 "constraints": ["Budget under 500/mo", "Needs SSO"],
 "blockers": ["Cannot export CSV from current tool"],
 "competitors": ["Heroku", "Supabase"],
 "why_now": "End of quarter migration push"
 },
 "crm_sync": {
 "object_type": "lead",
 "properties": {
 "onboarding_status": "activated",
 "intent_category": "database_migration"
 }
 }
}
Det lukker kredsløbet mellem produktbrug og omsætning. Lad ikke disse data stå i en silo. Den første interaktion efter tilmelding er en AI-samtale på 90 sekunder, der erstatter statiske formularer om rolle og teamstørrelse med 3 til 5 åbne spørgsmål om, hvorfor brugeren er her, og hvad succes ser ud til.
Trin 2: Sådan designer du den første samtale på 90 sekunder
Udtræk af hensigt kan være forkert, selv når outputtet matcher et JSON-skema. Kontrollér betydningen mod gennemgåede eksempler, send resultater med lav sikkerhed videre til medarbejdere, og følg rettelserne under piloten.
Vi tvinger modellen til at lægge sine resultater i en stram struktur, som fodrer generatoren af aktiveringsforløb. Her er et Python-kodeeksempel, der viser en prompt-skabelon, som strukturerer LLM'ens output: client = Anthropic()
import json
from anthropic import Anthropic


prompt = f"""


You are an onboarding diagnostic assistant. Read the user's responses and extract their core intent. Output strictly valid JSON matching this schema: {{ "primary_goal": string, "use_case": string, "technical_level": "beginner" | "intermediate" | "advanced", "activation_path": ["step_1", "step_2", "step_3"] }} User responses: {user_responses} """ response = client.messages.create( model="claude-sonnet-5-5", max_tokens=1024, messages=[{"role": "user", "content": prompt}] ) return json.loads(response.content.text)
Det personliggør den første opgave ud fra brugerens rolle, så en marketingbruger får et forløb til at koble annoncekonti, mens en dataingeniør får et forløb til at konfigurere API-nøgler. Systemet følger fremdriften på de konkrete forløb. Følg disse regler, når du designer din samtale på 90 sekunder: 1.
Start med et bredt spørgsmål om målet: "Hvad bringer dig herind i dag?" 2.
Følg op på det, brugeren nævner: "Du nævnte X. Hvad vil du gerne opnå med det?" 3.
Afdæk begrænsninger: "Hvilke værktøjer bruger du i øjeblikket til det?" 4. Definér succes: "Hvordan ser en sejr ud for dig i den første uge?"
Den rækkefølge giver dyb indsigt uden at føles som et forhør. Chatbotten tager sig af friktionen. Brugeren taler bare.
Trin 3: Sådan implementerer du resultatbedømt aktivering og CRM-tilbageskrivning
Resultatbedømt aktivering er en evalueringsmetode, hvor AI afgør, om en bruger har opnået et meningsfuldt underliggende resultat, i stedet for blot at have gennemført opgaver i brugerfladen. Automatisering af kundeonboarding med AI bruger denne logik til at vurdere asynkrone adfærdssignaler og udløse opfølgende samtaler på baggrund af brugerens faktiske succes.
Vi må holde op med at tælle klik. At klikke på "create project" betyder ikke, at brugeren har skabt værdi. Det kræver sporing af adfærdshændelser, der er knyttet til semantisk betydning.
Rækken af velkomstmails er død. Getperspective (2026) bemærker, at velkomstmailrækken erstattes af asynkrone AI-samtaler, der udløses af adfærdssignaler. Hvis aktiveringen går i stå efter 24 timer, tager AI'en initiativ til en opfølgning.
Den spørger, hvad der blokerer. Den sender ikke et generisk nyhedsbrev.
Her er pseudokode til den bedømmelseslogik, der erstatter almindelige e-mail-drypkampagner:
def evaluate_activation_status(user_events: list) -> str:
    # Define meaningful outcomes
    shipped_shared_item = any(e.name == "item_shared" for e in user_events)
    connected_core_integration = any(e.name == "integration_connected" for e in user_events)

    if shipped_shared_item and connected_core_integration:
        return "Fully Activated"
    elif connected_core_integration and not shipped_shared_item:
        # Stalled after integration
        trigger_ai_follow_up(intent="share_project")
        return "Partial Activation"
    else:
        # Stalled early
        trigger_ai_follow_up(intent="unblock_setup")
        return "At Risk"
Den logik sikrer, at dine kunder får hjælp netop dér, hvor de går i stå. AI'en læser hændelsesstrømmen, finder hullet og genererer en konkret, kontekstbevidst besked. Det skåner dit supportteam for at skulle besvare de samme opsætningsspørgsmål igen og igen.
Pris for AI-onboarding vs. manuel pris
Beregn din månedlige besparelse ved at erstatte manuelle onboardingopkald med AI-samtaler.
Det kræver en robust hændelsespipeline at implementere dette bedømmelsessystem. Du skal bruge et datawarehouse som Snowflake eller BigQuery til at gemme rå hændelser. Bedømmelsestjenesten kører som et cronjob og scanner hver time efter brugere, der er gået i stå.
Den sender konteksten videre til LLM'en, som afgør, om der skal udløses en opfølgende chatbotbesked.
Den overraskende indsigt: Derfor fejler fuldt automatiseret onboarding stadig
Branchen går ud fra, at 100 % automatisering er målet. Det er det ikke. Hvis du forsøger at automatisere dokumentverifikation fuldstændigt, risikerer du compliancesvigt og svindel. AI kan markere afvigelser.
Men et menneske skal kontrollere dem. Vi bruger 10-20-70-reglen. Det er den optimale driftsmodel, og den viser, at AI-assisterede arbejdsgange med mennesker i loopet klarer sig bedre end fuldt autonome systemer i komplekse B2B-miljøer. Hvorfor fejler end-to-end-automatisering stadig?
Årsagen er tillid og ansvar. En chatbot kan ikke underskrive en rammeaftale om tjenesteydelser. Den kan ikke forhandle skræddersyede sikkerhedsvilkår.
Som Andrew Ng udtrykte det på Stanford GSB, er AI den nye elektricitet. Den forsyner nettet, men du har stadig brug for elektrikere til at installere i bygningerne, og dine customer success managers er de elektrikere. De tager sig af de 70 % af opgaverne, der kræver forhandling, empati og skræddersyede løsninger.
AI'en opbygger vidensbasen og forbereder konteksten, så mennesket kan arbejde hurtigere. Forsøg ikke at erstatte dit team. Rust det op.
Vurdering af parathed til AI-onboarding
Find ud af, om din organisation er klar til at tage AI-assisteret onboarding i brug.
Hvordan opbevares dine brugerdata i dag?
AI'en bør klare de gentagne 10 % og assistere med de 20 %. Dine medarbejdere bør fokusere på de 70 %, hvor relationer betyder noget, og netop den hybride tilgang giver de højeste aktiveringsrater og den laveste kundeafgang. Databeskyttelse i AI-onboarding kræver, at personhenførbare oplysninger fjernes, før data sendes til eksterne LLM-API'er, og at der oprettes lokale modeller til verifikation af følsomme dokumenter.
Automatisering af kundeonboarding med AI skal balancere fleksible samtaler med stramme compliancegrænser og sikre, at driftsomkostningerne forbliver forudsigelige, efterhånden som tokenforbruget vokser.
Hvordan håndterer du databeskyttelse og compliance, når onboardingdata sendes til LLM'er?
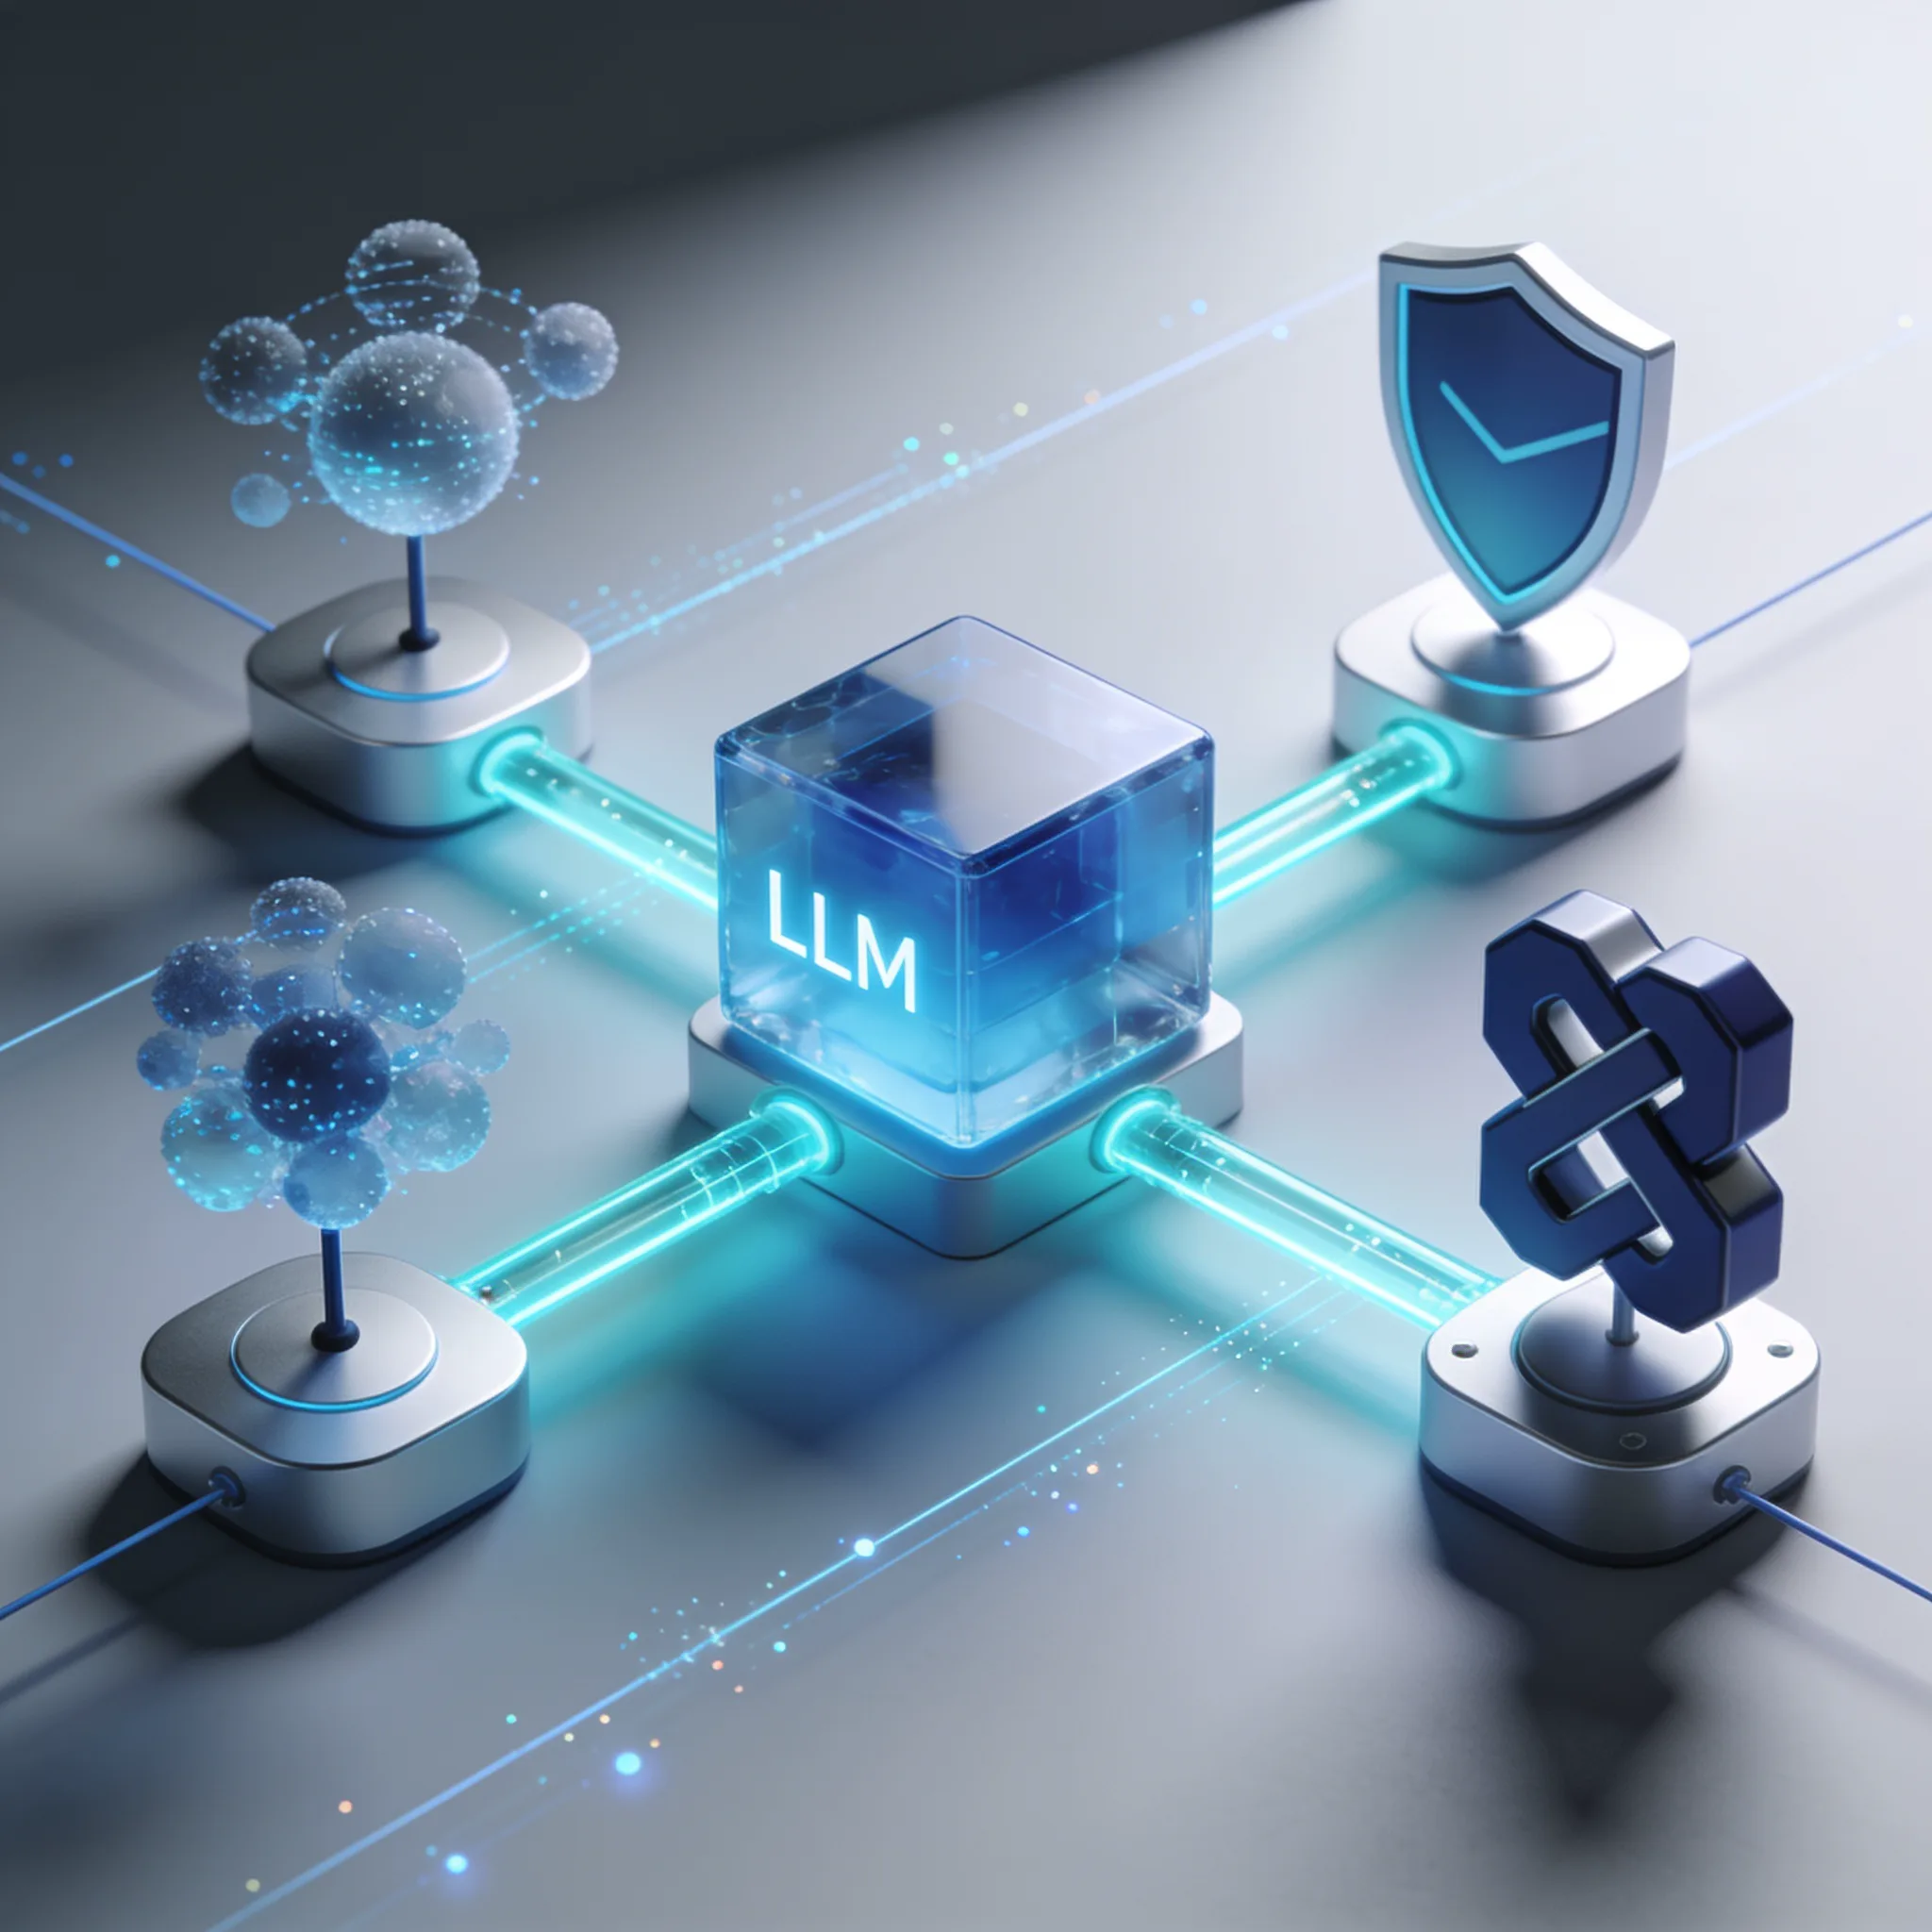
Du kan ikke sende rå brugerinput til OpenAI eller Anthropic, hvis det indeholder følsomme data. Du skal indføre et lag, der fjerner personhenførbare oplysninger. Vi bruger Microsoft Presidio til at scanne tekst, før den når LLM'en.
Det fjerner navne, e-mailadresser og telefonnumre. LLM'en modtager renset kontekst. Den bearbejder hensigten uden at røre private data.
Til verifikation af følsomme dokumenter skal du ikke bruge eksterne API'er. Sæt i stedet en lokal model i drift. En open-weight-model, der kører på dine egne AWS-instanser, kan verificere et dokuments ægthed, uden at data forlader dit VPC.
Denne orkestrering skal foregå inden for din sikkerhedsperimeter. Omkostningerne vokser hurtigt. Hver samtale koster tokens. Den massive udbredelse betyder, at tokenomkostninger nu er en væsentlig udgiftspost for SaaS-virksomheder. Du skal følge dit tokenforbrug. Vi begrænser samtaler til 10 ture.
Overskrider en bruger 10 ture, sender chatbotten vedkommende videre til et menneske. Det forhindrer løbske omkostninger fra forvirrede brugere, der kører i ring med botten. Vi cacher også almindelige forespørgsler i vores vidensbase for at undgå overflødige LLM-kald.
Følg tokenomkostningerne hver for sig: * Inputtokens afregnes til den valgte models inputpris. * Outputtokens har deres egen modelspecifikke pris. * Unødvendig kontekst gør inputregningen større.
Hvis en bruger uploader en kontrakt på 10 sider, skal du ikke sende hele teksten videre til LLM'en. Brug en vektorsøgning til at finde de relevante 500 ord. Send kun de ord videre til LLM'en.
Det reducerer inputtokens, og besparelsen afhænger af tekstens længde og modelpriserne. Automatisering af kundeonboarding med AI er kun bæredygtig, hvis du tilrettelægger den med omkostningseffektivitet for øje fra dag ét.
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listepris
Én API-nøgle til modellerne fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellerne fungerer også med Anthropic SDK og Claude Code.
Hver models pris via AIGROW-kredit ligger ved siden af udviklerens listepris, aldrig over den.
Ofte stillede spørgsmål
