Die Automatisierung des Kunden-Onboardings mit KI ersetzt statische Produkttouren durch Gespräche, die die Absicht erkennen und sich daran anpassen, was jeder Nutzer erreichen möchte. Dieser Leitfaden zeigt, warum klassische Touren scheitern, wie Sie den Onboarding-Stack von Grund auf aufbauen, wie Sie das erste Gespräch von 90 Sekunden gestalten und welche Bewertungslogik nötig ist, um solche Systeme im großen Maßstab zu betreiben.
Sie entwickeln mit KI-Modellen? Mit AIGROW API-Guthaben nutzen Sie Claude-, GPT-, Gemini- und Grok-Modelle bis zu 75 % unter dem Listenpreis.
- Messen Sie die Aktivierung nach 14 Tagen im Vergleich zu Ihrem bestehenden Onboarding-Ablauf, bevor Sie Conversational AI auf mehr Nutzer ausweiten.
- Statische Formulare und klassische Tour-Overlays schicken alle Nutzer auf denselben Weg. KI-natives Onboarding ersetzt sie durch ein 90-sekündiges Gespräch zur Erfassung der Absicht.
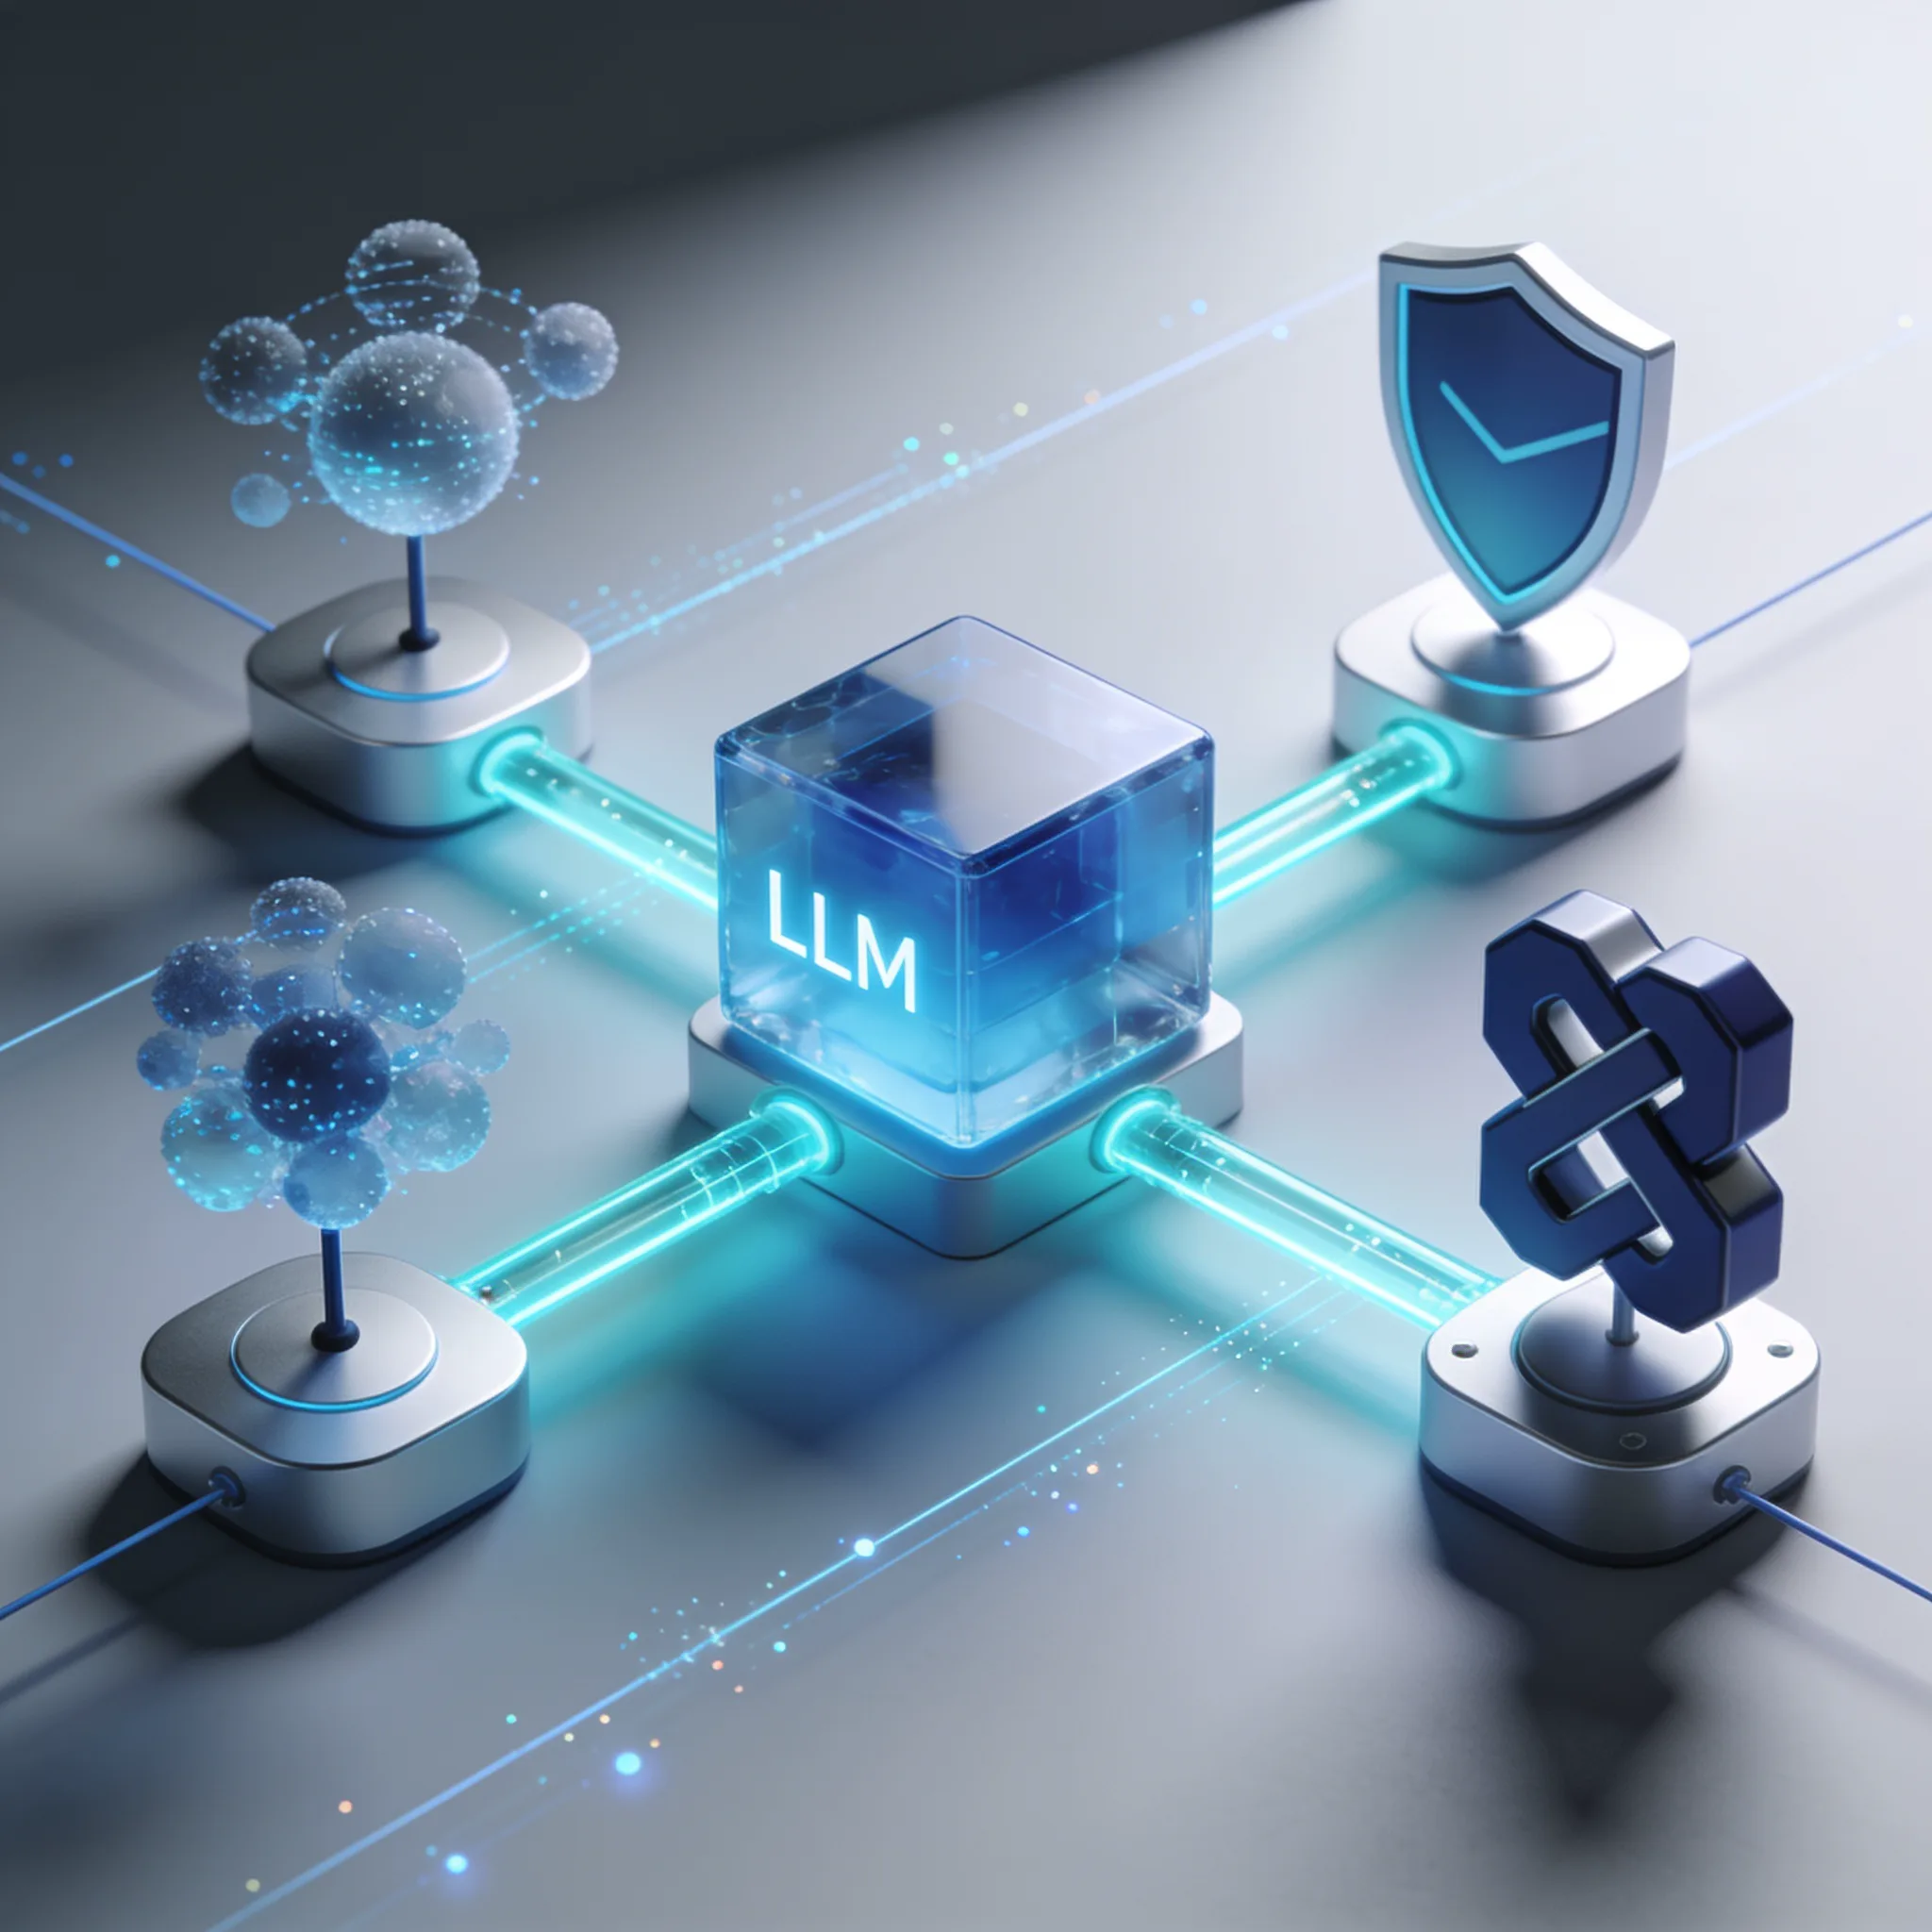
- Eine robuste KI-Onboarding-Architektur braucht ein LLM, eine Vektordatenbank für das Routing nach Absicht und einen CRM-Webhook für das Rückschreiben strukturierter Daten.
- Die ergebnisbasierte Aktivierung lenkt den Blick weg vom Zählen von Klicks auf Funktionen hin zur Frage, ob der Nutzer ein sinnvolles geschäftliches Ergebnis erreicht hat.
- Trotz des Hypes um vollständige Autonomie zeigt die 10-20-70-Regel: Die wirksamsten Umsetzungen kombinieren 10 % vollständig autonome Aufgaben, 20 % KI-unterstützte Aufgaben und 70 % menschlich geführte Aufgaben mit KI-Unterstützung.
Warum sollten Sie klassische Produkttouren durch KI-gestützte Automatisierung des Kunden-Onboardings ersetzen?
Wer noch Klick-Anleitungen baut, verliert Nutzer. Die Automatisierung des Kunden-Onboardings mit KI setzt Large Language Models ein, um statische Produkttouren durch dynamische Gespräche zu ersetzen, die die Absicht der Nutzer erkennen. Dieser Ansatz erfasst den Nutzerkontext in Echtzeit, sodass Systeme personalisierte Aktivierungspfade erzeugen können, statt Nutzer durch generische Checklisten zu schicken, die ihre jeweilige Rolle ignorieren.
Ein Pilotprojekt kann zeigen, ob Onboarding im Gespräch die Aktivierung Ihrer Nutzer verbessert.
Klassische Produkttouren gehen davon aus, dass alle Nutzer dieselbe Einführung in 5 Schritten brauchen. Das stimmt nicht. Eine Marketingleiterin muss Werbebudgetdaten anbinden, ein Data Engineer das Pipeline-Schema prüfen, aber statische Touren können diese Rollen nicht unterscheiden.
Warum identische Inhalte in die Oberfläche kippen? Das erzeugt enorme Reibung und treibt die Abwanderung an.
Verfolgen Sie bei einem hypothetischen SaaS-Onboarding-Pilotprojekt die Aktivierung, die Time-to-First-Value, offene Fragen, die Korrekturrate und die Eskalationen an den Support. Nutzen Sie dafür die Ausgangswerte des Unternehmens und die im Pilotprojekt beobachteten Werte statt eines erfundenen unternehmensübergreifenden Datensatzes.
| Merkmal | Klassische Touren (Pendo, Appcues) | KI-Gesprächsebene |
|---|---|---|
| Architektur | DOM-Injektion, statische Regeln | Ereignisgesteuert, LLM-nativ |
| Nutzerabsicht | Vorab gewählte Dropdowns | Aus offenem Text abgeleitet |
| Aktivierungspfad | Generische Checklisten | Personalisierter Ablauf in 3 Schritten |
| Rückschreiben von Daten | Einfaches Event-Tracking | Strukturierte CRM-Objekte |
| Aktivierung nach 14 Tagen | Den bestehenden Ablauf messen | Das Pilotprojekt an dieser Ausgangsbasis messen |
Sie verlassen sich auf exakte Selektoren, die bei UI-Änderungen brechen. KI-Gesprächsebenen dagegen liegen außerhalb der Oberfläche. Sie nehmen Verhaltensereignisse auf, verarbeiten die Absicht über ein LLM und geben Hilfestellung über einen Chatbot oder ein dynamisches Banner aus.
Dadurch sind sie gegenüber Produktänderungen sehr robust. Für die Automatisierung des Kunden-Onboardings mit KI brauchen Sie einen bestimmten Stack: ein LLM für das Schlussfolgern, eine Vektordatenbank für den Abruf und ereignisgesteuerte Webhooks für die CRM-Anbindung.
Schritt 1: Den KI-Onboarding-Techstack von Grund auf entwerfen
Ein entkoppelter Ereignisstrom kann direkte Änderungen an der bestehenden Datenbank verringern, bringt aber Anforderungen an Zustellung, Reihenfolge, Wiedergabe, Datenschutz und Beobachtbarkeit mit sich. Prüfen Sie diese Abwägungen am tatsächlichen System.
Diese Modelle klassifizieren die Absicht und extrahieren Rahmenbedingungen aus Gesprächseingaben. Sie speichern keinen Zustand. Der Zustand gehört in Ihre primäre Anwendungsdatenbank.
Halten Sie das LLM daher vollständig zustandslos, damit die Kontextfenster nicht anschwellen. Setzen Sie als Nächstes eine Vektordatenbank wie Pinecone oder Weaviate ein. Sie dient als Wissensdatenbank.
Stellt ein Nutzer eine konkrete Frage zu API-Limits, ruft das System genau den passenden Dokumentationsabschnitt ab. Das erdet das LLM und verhindert Halluzinationen. Jedes KI-Onboarding-Gespräch muss als strukturiertes Objekt ins CRM zurückgeschrieben werden, mit Absicht, Rahmenbedingungen, Hindernissen, genannten Wettbewerbern und dem „Warum jetzt“, damit Ihre Routing-Logik für Marketing und Vertrieb sofort auslösen kann.
Diese Daten speisen Ihre Umsatzmaschine direkt. Hier ist der Ablauf der Kernarchitektur:
Für dieses Rückschreiben verwenden wir ein striktes JSON-Schema. Messen Sie die Time-to-First-Value vor und nach einem Pilotprojekt, um zu sehen, ob der Workflow neuen Nutzern hilft, schneller ein brauchbares Ergebnis zu erreichen. Der Webhook schreibt direkt in HubSpot oder Salesforce und löst einen Slack-Alarm für den Account Executive aus, wenn eine besonders wertvolle Absicht erkannt wird.
So entgeht Ihrem Team nie ein Upsell-Signal.
{
 "event_type": "onboarding_conversation_completed",
 "user_id": "usr_8821",
 "session_data": {
 "intent": "Migrate DB from Heroku",
 "constraints": ["Budget under 500/mo", "Needs SSO"],
 "blockers": ["Cannot export CSV from current tool"],
 "competitors": ["Heroku", "Supabase"],
 "why_now": "End of quarter migration push"
 },
 "crm_sync": {
 "object_type": "lead",
 "properties": {
 "onboarding_status": "activated",
 "intent_category": "database_migration"
 }
 }
}
So schließt sich der Kreis zwischen Produktnutzung und Umsatz. Lassen Sie diese Daten nicht in einem Silo liegen. Die erste Interaktion nach der Anmeldung ist ein KI-Gespräch von 90 Sekunden.
Es ersetzt statische Formulare zu Rolle und Teamgröße durch 3 bis 5 offene Fragen dazu, warum der Nutzer hier ist und was Erfolg für ihn bedeutet.
Schritt 2: Das First-Run-Gespräch von 90 Sekunden gestalten
Die Erkennung der Absicht kann falsch sein, selbst wenn die Ausgabe zu einem JSON-Schema passt. Prüfen Sie die Bedeutung anhand geprüfter Fälle, leiten Sie Ergebnisse mit geringer Sicherheit an Mitarbeitende weiter und verfolgen Sie Korrekturen während des Pilotprojekts.
Wir zwingen das Modell, seine Ergebnisse in eine starre Struktur auszugeben, die den Generator für den Aktivierungspfad speist. Hier ist ein Python-Codeschnipsel mit einer Prompt-Vorlage, die die LLM-Ausgabe strukturiert: client = Anthropic()
import json
from anthropic import Anthropic


prompt = f"""


You are an onboarding diagnostic assistant. Read the user's responses and extract their core intent. Output strictly valid JSON matching this schema: {{ "primary_goal": string, "use_case": string, "technical_level": "beginner" | "intermediate" | "advanced", "activation_path": ["step_1", "step_2", "step_3"] }} User responses: {user_responses} """ response = client.messages.create( model="claude-sonnet-5-5", max_tokens=1024, messages=[{"role": "user", "content": prompt}] ) return json.loads(response.content.text)
So wird die erste Aufgabe an die Rolle des Nutzers angepasst: Marketingnutzer sehen einen Pfad zum Verbinden der Werbekonten, Data Engineers einen Pfad zum Konfigurieren der API-Schlüssel. Das System verfolgt den Fortschritt auf diesen konkreten Pfaden. Beachten Sie für Ihr Gespräch von 90 Sekunden diese Regeln: 1.
Beginnen Sie mit einer offenen Frage nach dem Ziel: „Was führt Sie heute hierher?“ 2.
Haken Sie bei dem nach, was genannt wurde: „Sie haben X erwähnt. Was möchten Sie damit erreichen?“ 3. Klären Sie die Rahmenbedingungen: „Welche Tools nutzen Sie dafür derzeit?“ 4.
Definieren Sie Erfolg: „Wie sähe ein Erfolg in Ihrer ersten Woche aus?“ Diese Abfolge liefert tiefe Einblicke, ohne wie ein Verhör zu wirken. Der Chatbot nimmt die Reibung auf. Der Nutzer redet einfach.
Schritt 3: Ergebnisbasierte Aktivierung und CRM-Rückschreibungen umsetzen
Die ergebnisbasierte Aktivierung ist eine Bewertungsmethode, bei der die KI feststellt, ob ein Nutzer ein sinnvolles Ergebnis erreicht hat, statt nur Aufgaben in der Oberfläche abzuschließen. Die Automatisierung des Kunden-Onboardings mit KI nutzt diese Logik, um asynchrone Verhaltenssignale auszuwerten und Folgegespräche anhand des tatsächlichen Nutzererfolgs auszulösen.
Wir müssen aufhören, Klicks zu zählen. Ein Klick auf „Projekt erstellen“ heißt nicht, dass der Nutzer Wert geschaffen hat. Dafür braucht es Verhaltens-Tracking, das an eine inhaltliche Bedeutung gekoppelt ist.
Die Willkommens-E-Mail-Serie ist tot. Getperspective (2026) stellt fest, dass die Willkommens-E-Mail-Serie durch asynchrone KI-Gespräche ersetzt wird, die durch Verhaltenssignale ausgelöst werden. Stockt die Aktivierung nach 24 Stunden, startet die KI eine Nachfrage.
Sie fragt, was den Nutzer blockiert. Einen generischen Newsletter schickt sie nicht.
Hier ist der Pseudocode der Bewertungslogik, die klassische E-Mail-Drip-Kampagnen ersetzt:
def evaluate_activation_status(user_events: list) -> str:
    # Define meaningful outcomes
    shipped_shared_item = any(e.name == "item_shared" for e in user_events)
    connected_core_integration = any(e.name == "integration_connected" for e in user_events)

    if shipped_shared_item and connected_core_integration:
        return "Fully Activated"
    elif connected_core_integration and not shipped_shared_item:
        # Stalled after integration
        trigger_ai_follow_up(intent="share_project")
        return "Partial Activation"
    else:
        # Stalled early
        trigger_ai_follow_up(intent="unblock_setup")
        return "At Risk"
Diese Logik stellt sicher, dass Ihre Kunden genau dann Hilfe erhalten, wenn sie nicht weiterkommen. Die KI liest den Ereignisstrom, erkennt die Lücke und erzeugt eine konkrete Nachricht, die den Kontext berücksichtigt. So muss Ihr Support-Team nicht ständig dieselben Einrichtungsfragen beantworten.
Kosten für KI-Onboarding im Vergleich zu manuellen Kosten
Berechnen Sie Ihre monatliche Ersparnis, wenn Sie manuelle Onboarding-Gespräche durch KI-Gespräche ersetzen.
Für dieses Bewertungssystem brauchen Sie eine robuste Ereignis-Pipeline. Zum Speichern der Rohereignisse benötigen Sie ein Data Warehouse wie Snowflake oder BigQuery. Der Bewertungsdienst läuft als Cron-Job und sucht stündlich nach Nutzern, die nicht weiterkommen.
Er übergibt den Kontext an das LLM, das entscheidet, ob eine Chatbot-Nachricht zur Nachfrage ausgelöst wird.
Die weniger offensichtliche Erkenntnis: Warum durchgängig automatisiertes Onboarding trotzdem scheitert
Die Branche geht davon aus, dass 100 % Automatisierung das Ziel sei. Das stimmt nicht. Wer versucht, die Dokumentenprüfung vollständig zu automatisieren, riskiert Compliance-Verstöße und Betrug. KI kann Auffälligkeiten markieren.
Aber ein Mensch muss sie prüfen. Wir arbeiten nach der 10-20-70-Regel. Sie ist das optimale Betriebsmodell und zeigt, dass KI-gestützte menschliche Workflows in komplexen B2B-Umgebungen vollständig autonomen Systemen überlegen sind. Warum scheitert die durchgängige Automatisierung nach wie vor?
Der Grund sind Vertrauen und Haftung. Ein Chatbot kann keinen Rahmenvertrag über Dienstleistungen unterschreiben. Er kann keine individuellen Sicherheitsbedingungen verhandeln.
Andrew Ng sagte an der Stanford GSB, KI sei der neue Strom. Sie speist das Netz, aber Elektriker müssen weiterhin die Gebäude verkabeln, und Ihre Customer-Success-Manager sind diese Elektriker. Sie übernehmen die 70 % der Aufgaben, die Verhandlungsgeschick, Empathie und individuelle Lösungen erfordern.
Die KI baut die Wissensdatenbank auf und bereitet den Kontext vor, damit der Mensch schneller arbeiten kann. Versuchen Sie nicht, Ihr Team zu ersetzen. Rüsten Sie es aus.
Bewertung der KI-Onboarding-Reife
Finden Sie heraus, ob Ihr Unternehmen bereit ist, KI-gestütztes Onboarding einzuführen.
Wie werden Ihre Nutzerdaten derzeit gespeichert?
Die KI sollte die repetitiven 10 % übernehmen und bei den 20 % unterstützen. Ihre Mitarbeitenden sollten sich auf die 70 % konzentrieren, bei denen Beziehungen zählen. So erzielt dieser hybride Ansatz die höchsten Aktivierungsraten und die geringste Abwanderung.
Datenschutz beim KI-Onboarding erfordert, personenbezogene Daten zu schwärzen, bevor Daten an externe LLM-APIs gesendet werden, und lokale Modelle für die Prüfung sensibler Dokumente zu erstellen. Kunden-Onboarding-Automatisierung mit KI muss dialogbasierte Flexibilität mit strengen Compliance-Grenzen in Einklang bringen und dafür sorgen, dass die Betriebskosten planbar bleiben, wenn die Token-Nutzung steigt.
Wie gehen Sie mit Datenschutz und Compliance um, wenn Onboarding-Daten an LLMs übergeben werden?
Rohe Nutzereingaben, die sensible Daten enthalten, dürfen Sie nicht an OpenAI oder Anthropic senden. Sie müssen eine Schicht zur Schwärzung personenbezogener Daten einsetzen. Wir verwenden Microsoft Presidio, um Text zu scannen, bevor er das LLM erreicht.
Dabei werden Namen, E-Mail-Adressen und Telefonnummern entfernt. Das LLM erhält bereinigten Kontext. Es verarbeitet die Absicht, ohne private Daten zu sehen.
Für die Prüfung sensibler Dokumente sollten Sie keine externen APIs nutzen. Setzen Sie stattdessen ein lokales Modell ein. Ein Open-Weight-Modell auf Ihren eigenen AWS-Instanzen kann die Echtheit von Dokumenten prüfen, ohne dass Daten Ihre VPC verlassen.
Diese Orchestrierung muss innerhalb Ihres Sicherheitsperimeters stattfinden. Die Kosten steigen schnell. Jede Konversation verbraucht Token.
Durch diese breite Nutzung sind Token-Kosten für SaaS-Unternehmen inzwischen ein zentraler Kostenpunkt. Sie müssen Ihre Token-Ausgaben im Blick behalten. Wir begrenzen Konversationen auf 10 Gesprächsrunden.
Überschreitet ein Nutzer 10 Runden, leitet der Chatbot ihn an einen Menschen weiter. Das verhindert ausufernde Kosten durch verwirrte Nutzer, die den Bot in Schleifen schicken. Außerdem speichern wir häufige Anfragen in unserer Wissensdatenbank zwischen, um überflüssige LLM-Aufrufe zu vermeiden.
Erfassen Sie die Token-Kosten getrennt: * Eingabe-Token werden zum Eingabepreis des gewählten Modells abgerechnet. * Ausgabe-Token haben einen eigenen, modellspezifischen Preis. * Unnötiger Kontext erhöht die Eingaberechnung.
Wenn ein Nutzer einen Vertrag mit 10 Seiten hochlädt, übergeben Sie nicht den gesamten Text an das LLM. Nutzen Sie eine Vektorsuche, um die relevanten 500 Wörter zu finden. Übergeben Sie nur diese Wörter an das LLM.
Das reduziert die Eingabe-Token; die Ersparnis hängt von der Textlänge und den Modellpreisen ab. Kunden-Onboarding-Automatisierung mit KI ist nur dann tragfähig, wenn Sie von Anfang an auf Kosteneffizienz hin entwickeln.
Aktuelle Modelle von Claude, GPT, Gemini und Grok, bis zu 75 % unter dem Listenpreis
Ein API-Schlüssel für Claude-, GPT-, Gemini- und Grok-Modelle über das OpenAI SDK. Claude-Modelle funktionieren außerdem mit dem Anthropic SDK und Claude Code.
Der Preis jedes Modells über AIGROW-Guthaben steht neben dem Listenpreis des jeweiligen Herstellers, nie darüber.
Häufig gestellte Fragen
