Automatisering av kundeonboarding med KI erstatter statiske produktomvisninger med samtaler som forstår intensjonen og tilpasser seg det hver bruker prøver å få til. Denne guiden forklarer hvorfor gamle omvisninger svikter, hvordan du bygger onboarding-stakken fra grunnen av, hvordan du utformer de første 90 sekundene av samtalen, og hvilken vurderingslogikk du trenger for å drifte slike systemer i stor skala.
Bygger du med KI-modeller? AIGROW API-kreditt kjører modeller fra Claude, GPT, Gemini og Grok opptil 75 % under listepris.
- Mål aktivering etter 14 dager mot den eksisterende onboarding-flyten før du utvider samtalebasert KI til flere brukere.
- Statiske skjemaer og gamle omvisningsoverlegg gir alle brukere samme løype. KI-nativ onboarding erstatter dem med en samtale på 90 sekunder som avdekker hva brukeren vil.
- En solid arkitektur for KI-onboarding krever en LLM, en vektordatabase for ruting av intensjoner og en CRM-webhook for å skrive strukturerte data tilbake.
- Resultatbasert aktivering flytter fokuset fra å telle klikk på funksjoner til å vurdere om brukeren faktisk oppnådde et meningsfullt forretningsresultat.
- Til tross for hypen rundt full autonomi viser 10-20-70-regelen at de mest effektive løsningene kombinerer 10 % helt autonome oppgaver, 20 % KI-assisterte og 70 % menneskestyrte oppgaver med KI-støtte.
Hvorfor bør du erstatte gamle produktomvisninger med automatisering av kundeonboarding med KI?
Hvis du fortsatt bygger klikkguider, mister du brukere. Automatisering av kundeonboarding med KI bruker store språkmodeller til å erstatte statiske produktomvisninger med dynamiske samtaler som forstår intensjonen. Slik fanger systemet opp brukerens kontekst i sanntid og kan lage personlige aktiveringsløp, i stedet for å tvinge brukerne gjennom generiske sjekklister som overser rollen deres.
Et pilotprosjekt kan vise om samtalebasert onboarding gir bedre aktivering for brukerne dine.
Gamle produktomvisninger forutsetter at alle brukere trenger den samme gjennomgangen i 5 trinn. Det gjør de ikke. En markedssjef må koble til annonsebudsjettdata, mens en dataingeniør må verifisere pipeline-skjemaet, men statiske omvisninger kan ikke skille mellom disse rollene.
Hvorfor vise identisk innhold til alle? Det skaper stor friksjon og driver frafall.
For en hypotetisk onboarding-pilot i en SaaS-løsning bør du følge med på aktivering, tid til første verdi, ubesvarte spørsmål, korrigeringsrate og eskalering til support. Bruk selskapets egen basislinje og de observerte verdiene fra piloten, ikke et oppdiktet datasett på tvers av selskaper.
| Egenskap | Gamle omvisninger (Pendo, Appcues) | Samtalelag med KI |
|---|---|---|
| Arkitektur | DOM-injeksjon, statiske regler | Hendelsesdrevet, LLM-nativ |
| Brukerens intensjon | Forhåndsvalgte nedtrekkslister | Utledet fra fritekst |
| Aktiveringsløp | Generiske sjekklister | Personlig flyt i 3 trinn |
| Tilbakeskriving av data | Enkel hendelsessporing | Strukturerte CRM-objekter |
| Aktivering etter 14 dager | Mål den eksisterende flyten | Mål piloten mot denne basislinjen |
De er avhengige av nøyaktige selektorer som slutter å fungere når brukergrensesnittet oppdateres. Samtalelag med KI ligger derimot utenfor brukergrensesnittet. De tar inn atferdshendelser, tolker intensjonen med en LLM og gir veiledning via en chatbot eller et dynamisk banner, noe som gjør dem svært robuste mot endringer i produktet.
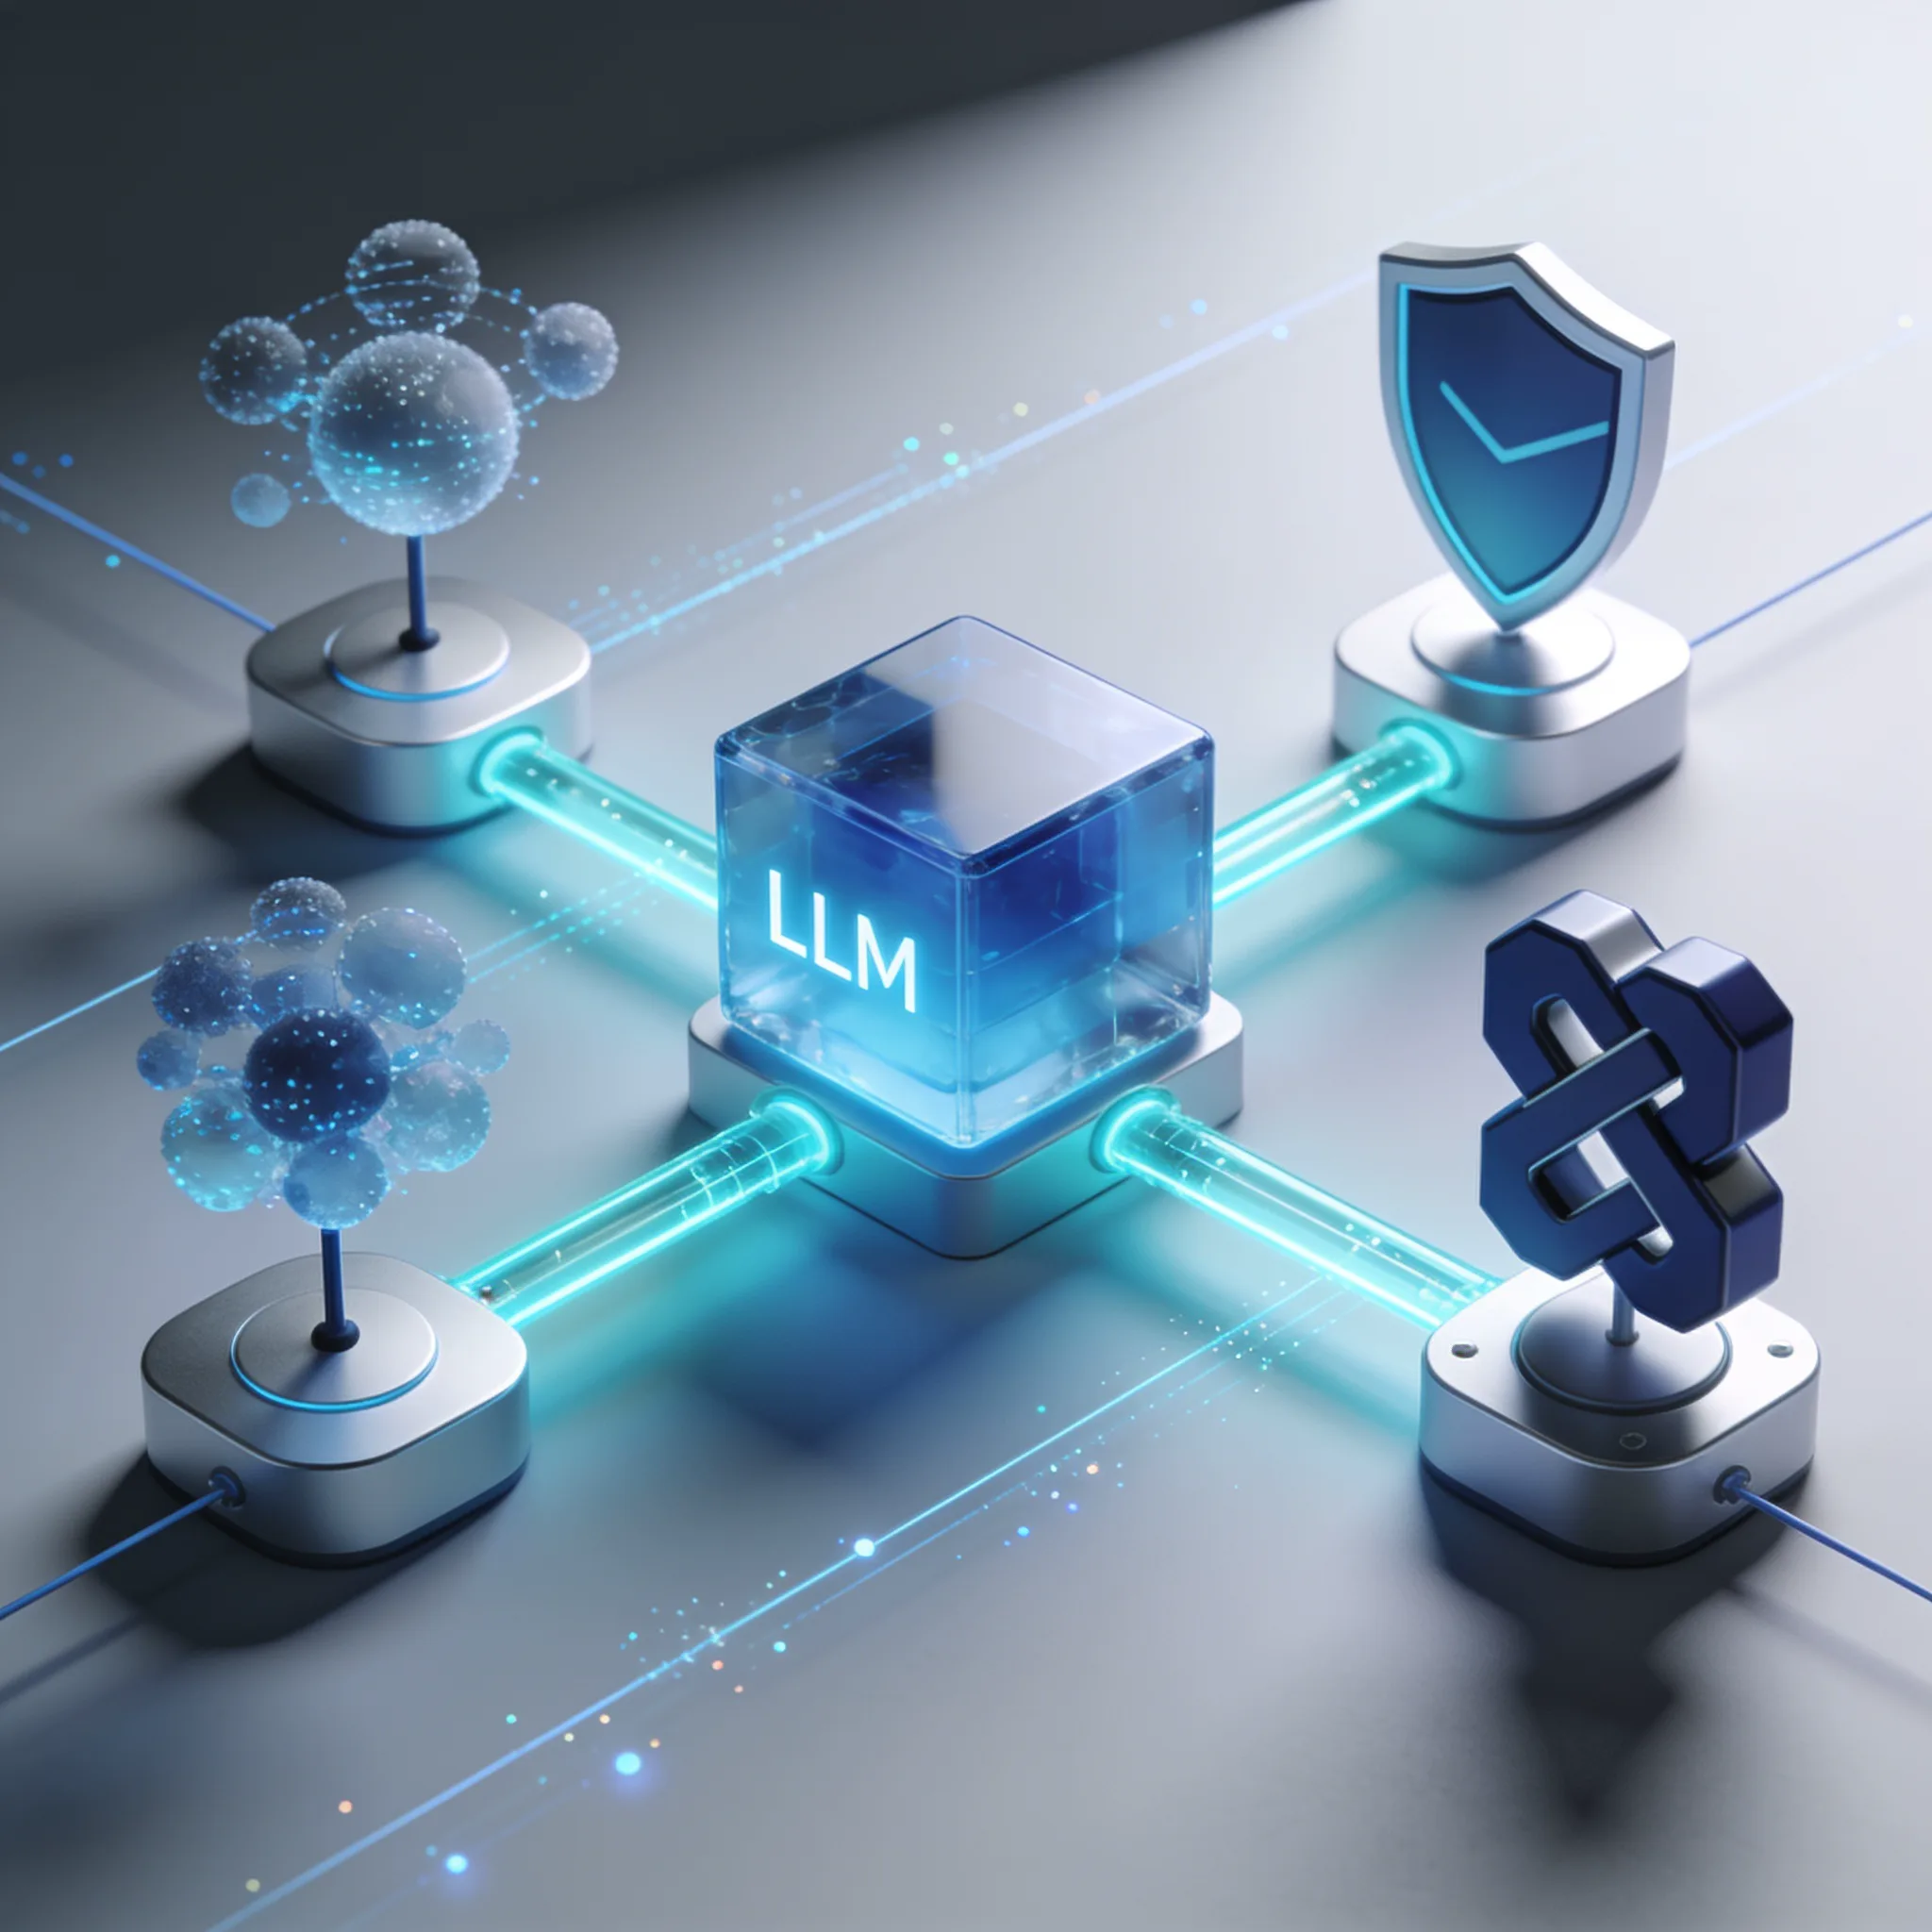
For å bygge automatisering av kundeonboarding med KI trenger du en bestemt stakk: en LLM til resonnering, en vektordatabase til gjenfinning og hendelsesdrevne webhooks til CRM-integrasjon.
Trinn 1: Bygg teknologistakken for KI-onboarding fra grunnen av
En frikoblet hendelsesstrøm kan redusere behovet for direkte endringer i den eksisterende databasen, men den stiller nye krav til levering, rekkefølge, avspilling, personvern og observerbarhet. Vurder disse avveiningene opp mot det faktiske systemet.
Disse modellene klassifiserer intensjon og trekker ut begrensninger fra samtaleinndata. De lagrer ikke tilstand. Tilstanden hører hjemme i applikasjonens primære database, så hold LLM-en helt tilstandsløs for å unngå oppblåste kontekstvinduer.
Sett deretter opp en vektordatabase som Pinecone eller Weaviate. Den fungerer som kunnskapsbasen din.
Når en bruker stiller et konkret spørsmål om API-grenser, henter systemet akkurat den delen av dokumentasjonen som gjelder. Det forankrer LLM-en og hindrer hallusinasjoner. Hver onboarding-samtale med KI må skrives tilbake til CRM-et som et strukturert objekt som inneholder intensjon, begrensninger, hindringer, navngitte konkurrenter og «hvorfor nå», slik at rutingslogikken for markedsføring og salg kan utløses umiddelbart.
Disse dataene mater inntektsmotoren din direkte. Her er den sentrale arkitekturflyten:
Vi bruker et strengt JSON-skjema for denne tilbakeskrivingen. Mål tiden til første verdi før og etter en pilot for å se om arbeidsflyten hjelper nye brukere raskere frem til et nyttig resultat. Webhooken skriver direkte til HubSpot eller Salesforce og utløser et Slack-varsel til kundeansvarlig hvis den oppdager en intensjon med høy verdi, slik at teamet ditt aldri går glipp av et signal om mersalg.
{
 "event_type": "onboarding_conversation_completed",
 "user_id": "usr_8821",
 "session_data": {
 "intent": "Migrate DB from Heroku",
 "constraints": ["Budget under 500/mo", "Needs SSO"],
 "blockers": ["Cannot export CSV from current tool"],
 "competitors": ["Heroku", "Supabase"],
 "why_now": "End of quarter migration push"
 },
 "crm_sync": {
 "object_type": "lead",
 "properties": {
 "onboarding_status": "activated",
 "intent_category": "database_migration"
 }
 }
}
Dette lukker sirkelen mellom produktbruk og inntektsskaping. Ikke la disse dataene bli liggende i en silo. Den første interaksjonen etter registrering er en KI-samtale på 90 sekunder som erstatter statiske skjemaer om rolle og teamstørrelse med 3 til 5 åpne spørsmål om hvorfor brukeren er her, og hva som er en vellykket start.
Trinn 2: Utform samtalen de første 90 sekundene
Uttrekk av intensjon kan bli feil selv når resultatet følger et JSON-skjema. Valider betydningen mot gjennomgåtte tilfeller, send resultater med lav sikkerhet til ansatte, og følg med på korrigeringer under piloten.
Vi tvinger modellen til å legge funnene sine inn i en fast struktur som mater generatoren for aktiveringsløp. Her er et Python-utdrag som viser en promptmal som strukturerer LLM-svaret: client = Anthropic()
import json
from anthropic import Anthropic


prompt = f"""


You are an onboarding diagnostic assistant. Read the user's responses and extract their core intent. Output strictly valid JSON matching this schema: {{ "primary_goal": string, "use_case": string, "technical_level": "beginner" | "intermediate" | "advanced", "activation_path": ["step_1", "step_2", "step_3"] }} User responses: {user_responses} """ response = client.messages.create( model="claude-sonnet-5-5", max_tokens=1024, messages=[{"role": "user", "content": prompt}] ) return json.loads(response.content.text)
Dette tilpasser den første oppgaven til brukerens rolle: en markedsføringsbruker får en løype for å koble til annonsekontoer, mens en dataingeniør får en løype for å konfigurere API-nøkler. Systemet følger fremdriften på disse konkrete løypene. Følg disse reglene når du utformer samtalen på 90 sekunder: 1.
Start med et bredt spørsmål om mål: «Hva bringer deg hit i dag?» 2.
Følg opp det brukeren nevnte: «Du nevnte X. Hva prøver du å få til med det?» 3. Kartlegg begrensninger: «Hvilke verktøy bruker du i dag til dette?» 4.
Definer suksess: «Hvordan ville en seier sett ut den første uken?» Denne rekkefølgen gir dype innsikter uten at det føles som et forhør. Chatboten tar seg av friksjonen. Brukeren trenger bare å snakke.
Trinn 3: Innfør resultatbasert aktivering og tilbakeskriving til CRM
Resultatbasert aktivering er en vurderingsmetode der KI avgjør om en bruker har nådd et meningsfullt underliggende resultat, i stedet for bare å ha fullført oppgaver i brukergrensesnittet. Automatisering av kundeonboarding med KI bruker denne logikken til å vurdere asynkrone atferdssignaler og utløse oppfølgingssamtaler basert på brukerens faktiske suksess.
Vi må slutte å telle klikk. Å klikke på «opprett prosjekt» betyr ikke at brukeren skapte verdi. Dette krever sporing av atferdshendelser knyttet til semantisk mening.
Serien med velkomst-e-poster er død. Getperspective (2026) skriver at velkomstserien på e-post erstattes av asynkrone KI-samtaler som utløses av atferdssignaler. Hvis aktiveringen stopper opp etter 24 timer, tar KI-en kontakt. Den spør hva som står i veien. Den sender ikke et generisk nyhetsbrev.
Her er pseudokode for vurderingslogikken som erstatter vanlige e-postkampanjer med drypp:
def evaluate_activation_status(user_events: list) -> str:
    # Define meaningful outcomes
    shipped_shared_item = any(e.name == "item_shared" for e in user_events)
    connected_core_integration = any(e.name == "integration_connected" for e in user_events)

    if shipped_shared_item and connected_core_integration:
        return "Fully Activated"
    elif connected_core_integration and not shipped_shared_item:
        # Stalled after integration
        trigger_ai_follow_up(intent="share_project")
        return "Partial Activation"
    else:
        # Stalled early
        trigger_ai_follow_up(intent="unblock_setup")
        return "At Risk"
Denne logikken sørger for at kundene dine får hjelp akkurat når de står fast. KI-en leser hendelsesstrømmen, finner hullet og lager en konkret, kontekstbevisst melding. Det sparer supportteamet ditt for å svare på de samme spørsmålene om oppsett om og om igjen.
Kostnad for KI-onboarding mot manuell kostnad
Beregn din månedlige besparelse ved å erstatte manuelle onboarding-samtaler med KI-samtaler.
For å innføre dette vurderingssystemet trenger du en robust hendelsespipeline. Du trenger et datavarehus som Snowflake eller BigQuery for å lagre rå hendelsesdata. Vurderingstjenesten kjører som en cron-jobb og skanner etter brukere som har stoppet opp, hver time.
Den sender konteksten videre til LLM-en, som avgjør om en oppfølgingsmelding fra chatboten skal utløses.
Den uvanlige innsikten: hvorfor ende-til-ende automatisert onboarding fortsatt svikter
Bransjen antar at 100 % automatisering er målet. Det er det ikke. Hvis du prøver å automatisere dokumentverifisering fullstendig, risikerer du brudd på regelverk og svindel. KI kan flagge avvik.
Men et menneske må kontrollere dem. Vi bruker 10-20-70-regelen. Dette er den optimale driftsmodellen, og den viser at KI-assisterte arbeidsflyter med mennesker i løkken gir bedre resultater enn fullt autonome systemer i komplekse B2B-miljøer.
Hvorfor feiler automatisering fra start til slutt fortsatt?
Grunnen er tillit og ansvar. En chatbot kan ikke signere en rammeavtale om tjenester. Den kan ikke forhandle om skreddersydde sikkerhetsvilkår.
Som Andrew Ng sa ved Stanford GSB, er KI den nye elektrisiteten. Den driver strømnettet, men du trenger fortsatt elektrikere som drar ledningene i byggene, og kundelojalitetsteamet ditt er disse elektrikerne. De tar seg av de 70 % av oppgavene som krever forhandling, empati og skreddersydde løsninger.
KI-en bygger kunnskapsbasen og klargjør konteksten, slik at mennesket kan jobbe raskere. Ikke prøv å erstatte teamet ditt. Gi det bedre verktøy.
Vurdering av beredskap for KI-onboarding
Finn ut om organisasjonen din er klar til å ta i bruk KI-assistert onboarding.
Hvordan lagres brukerdataene dine i dag?
KI-en bør håndtere de repetitive 10 % og bistå med de 20 %. Menneskene dine bør konsentrere seg om de 70 % der relasjoner betyr noe. Denne hybridmodellen gir de høyeste aktiveringsratene og lavest frafall.
Personvern i KI-onboarding krever at personidentifiserbar informasjon fjernes før data sendes til eksterne LLM-API-er, og at du setter opp lokale modeller for verifisering av sensitive dokumenter. Automatisering av kundeonboarding med KI må balansere samtalefleksibilitet mot strenge rammer for etterlevelse, slik at driftskostnadene forblir forutsigbare når tokenbruken vokser.
Hvordan ivaretar du personvern og etterlevelse når du mater LLM-er med onboarding-data?
Du kan ikke sende rå brukerinput til OpenAI eller Anthropic hvis den inneholder sensitive data. Du må ha et lag som fjerner personopplysninger. Vi bruker Microsoft Presidio til å skanne tekst før den når LLM-en.
Dette fjerner navn, e-postadresser og telefonnumre. LLM-en får renset kontekst. Den behandler intensjonen uten å røre private data.
For verifisering av sensitive dokumenter bør du ikke bruke eksterne API-er. Ta heller i bruk en lokal modell. En åpen modell (open-weight) som kjører på dine egne AWS-instanser, kan verifisere om dokumenter er ekte uten at data forlater VPC-en din.
Denne orkestreringen må skje innenfor sikkerhetsperimeteret ditt. Kostnadene vokser raskt. Hver samtale koster tokens. Med så bred bruk er tokenkostnader nå en hovedpost for SaaS-selskaper. Du må følge med på tokenforbruket. Vi begrenser samtaler til 10 runder.
Hvis en bruker overskrider 10 runder, sender chatboten vedkommende videre til et menneske. Dette hindrer skyhøye kostnader når forvirrede brukere går i ring med boten. Vi bufrer også vanlige spørsmål i kunnskapsbasen vår for å unngå overflødige LLM-kall.
Følg tokenkostnadene hver for seg: * Input-tokens faktureres etter inputprisen til den valgte modellen. * Output-tokens har sin egen modellspesifikke pris. * Unødvendig kontekst øker input-regningen.
Hvis en bruker laster opp en kontrakt på 10 sider, må du ikke sende hele teksten til LLM-en. Bruk vektorsøk for å finne de relevante 500 ordene. Send bare disse ordene til LLM-en.
Det reduserer antall input-tokens, og besparelsen avhenger av tekstlengden og modellprisene. Automatisering av kundeonboarding med KI er bare bærekraftig hvis du designer for kostnadseffektivitet fra dag én.
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller, opptil 75 % under listepris
Én API-nøkkel til modellene fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellene fungerer også med Anthropic SDK og Claude Code.
Prisen for hver modell via AIGROW-kreditt ligger ved siden av utviklerens listepris, aldri over den.
Ofte stilte spørsmål
