
AI-automatiserad kundintroduktion ersätter statiska produktguider med samtal som tar hänsyn till användarens avsikt och kortar tiden till första värde från dagar till timmar. Guiden förklarar varför äldre produktguider inte fungerar, hur du bygger arkitekturen för kundintroduktion från grunden, hur du utformar det första samtalet på 90 sekunder och vilken bedömningslogik som krävs för att driva systemen i stor skala.
- 67 % av SaaS-företagen i den högst presterande fjärdedelen har infört samtalsbaserad AI i sina aktiveringsflöden, med en medianökning på 3.4x i aktiveringsgraden inom 14 dagar.
- Statiska formulär för insamling av användaruppgifter och äldre produktguider som läggs ovanpå gränssnittet ger sämst resultat. AI-baserad kundintroduktion ersätter dem med ett samtal på 90 sekunder som fångar upp användarens avsikt.
- En robust arkitektur för AI-baserad kundintroduktion kräver en LLM, en vektordatabas för att styra flödet utifrån användarens avsikt och en CRM-webhook som återför strukturerade data.
- Resultatbaserad aktivering flyttar fokus från att räkna klick på funktioner till att bedöma om användaren har uppnått ett meningsfullt affärsresultat.
- Trots uppmärksamheten kring fullständig autonomi visar 10-20-70-regeln att de mest effektiva lösningarna kombinerar 10 % helt autonoma uppgifter, 20 % uppgifter med AI-assistans och 70 % uppgifter som leds av människor med stöd av AI.
Varför bör du ersätta äldre produktguider med AI-automatiserad kundintroduktion?
Om du fortfarande bygger guider som användarna måste klicka sig igenom förlorar du användare. AI-automatiserad kundintroduktion använder stora språkmodeller för att ersätta statiska produktguider med dynamiska samtal som tar hänsyn till användarens avsikt. Då kan systemet fånga upp användarens situation i realtid och skapa personliga vägar till aktivering, i stället för att tvinga alla genom generiska checklistor som inte tar hänsyn till deras roller.
AI-baserad kundintroduktion fick brett genomslag under Q1 2026.
Det här är nu upplägget som ger sämst resultat i gruppen. Äldre produktguider utgår från att varje användare behöver samma genomgång i 5 steg. Så är det inte.
En marknadschef behöver koppla in data om annonsutgifter, medan en dataingenjör behöver kontrollera schemat för en datapipeline. Statiska guider kan inte skilja mellan rollerna. Varför visa alla samma innehåll i gränssnittet?
Det skapar onödig friktion och får användare att lämna tjänsten.
För ett hypotetiskt pilotprojekt för kundintroduktion i en SaaS-tjänst bör du följa upp aktivering, tid till första värde, obesvarade frågor, korrigeringsfrekvens och ärenden som eskaleras till supporten. Använd företagets utgångsvärden och de värden som faktiskt uppmäts i pilotprojektet, inte påhittade data från flera företag.
| Funktion | Äldre produktguider (Pendo, Appcues) | Samtalsbaserat AI-lager |
|---|---|---|
| Arkitektur | DOM-injektion, statiska regler | Händelsestyrd, byggd kring LLM |
| Användarens avsikt | Förvalda alternativ i rullgardinsmenyer | Härleds ur fritext |
| Väg till aktivering | Generiska checklistor | Personligt flöde i 3 steg |
| Återföring av data | Grundläggande händelsespårning | Strukturerade CRM-objekt |
| Aktivering inom 14 dagar | ~11.8 % i median | ~40.1 % i median |
De bygger på exakta selektorer som slutar fungera när gränssnittet uppdateras. Samtalsbaserade AI-lager ligger däremot utanför gränssnittet. De tar in beteendehändelser, tolkar avsikten med en LLM och ger vägledning via en chattbot eller en dynamisk informationsruta.
Därför påverkas de betydligt mindre av produktändringar. För att bygga AI-automatiserad kundintroduktion behöver du en bestämd teknisk uppsättning: en LLM för resonemang, en vektordatabas för informationshämtning och händelsestyrda webhooks för CRM-integration.
Steg 1: Bygg din tekniska arkitektur för AI-baserad kundintroduktion från grunden
En frikopplad händelseström kan minska behovet av direkta ändringar i den befintliga databasen, men ställer också krav på leverans, ordningsföljd, återuppspelning, integritet och observerbarhet. Pröva de avvägningarna mot det faktiska systemet.
Modellerna klassificerar avsikt och identifierar begränsningar i det som sägs under samtalet. De lagrar inte tillstånd. Tillståndet hör hemma i din primära applikationsdatabas, så låt din LLM vara helt tillståndslös för att undvika onödigt stora kontextfönster.
Sätt sedan upp en vektordatabas som Pinecone eller Weaviate. Den fungerar som din kunskapsbas.
När en användare ställer en specifik fråga om API-begränsningar hämtar systemet exakt rätt avsnitt ur dokumentationen. Det ger modellen ett faktaunderlag och motverkar hallucinationer. Varje samtal under den AI-baserade kundintroduktionen måste återföras till CRM som ett strukturerat objekt med avsikt, begränsningar, hinder, namngivna konkurrenter och skälet till att användaren agerar just nu.
Då kan logiken som fördelar kontakter till marknad och sälj aktiveras direkt. Uppgifterna går rakt in i ditt intäktsarbete. Så här ser arkitekturens grundflöde ut:
Vi använder ett strikt JSON-schema för återföringen. Efter att vi införde det här hos en B2B SaaS-kund i företagssegmentet minskade tiden till första värde från 4.7 dagar till 22 timmar. Webhooken skriver direkt till HubSpot eller Salesforce och skickar en Slack-avisering till den ansvariga säljaren om den upptäcker en avsikt med högt värde.
På så sätt missar teamet inga signaler om merförsäljning.
{
 "event_type": "onboarding_conversation_completed",
 "user_id": "usr_8821",
 "session_data": {
 "intent": "Migrate DB from Heroku",
 "constraints": ["Budget under 500/mo", "Needs SSO"],
 "blockers": ["Cannot export CSV from current tool"],
 "competitors": ["Heroku", "Supabase"],
 "why_now": "End of quarter migration push"
 },
 "crm_sync": {
 "object_type": "lead",
 "properties": {
 "onboarding_status": "activated",
 "intent_category": "database_migration"
 }
 }
}
Det knyter ihop produktanvändning med intäkter. Låt inte uppgifterna bli kvar i en isolerad datakälla. Den första interaktionen efter registrering är ett AI-samtal på 90 sekunder.
Det ersätter statiska formulär om roll och teamstorlek med 3 till 5 öppna frågor om varför användaren är här och vad ett lyckat resultat innebär.
Steg 2: Utforma det första samtalet på 90 sekunder
Tolkningen av användarens avsikt kan vara fel även när svaret följer ett JSON-schema. Kontrollera innebörden mot granskade fall, låt personal ta hand om resultat med låg säkerhet och följ upp korrigeringar under pilotprojektet.
Vi kräver att modellen redovisar sina slutsatser i en strikt struktur som används för att skapa vägen till aktivering. Här är ett Python-exempel med en promptmall som strukturerar modellens svar: client = Anthropic()
import json
from anthropic import Anthropic


prompt = f"""


You are an onboarding diagnostic assistant. Read the user's responses and extract their core intent. Output strictly valid JSON matching this schema: {{ "primary_goal": string, "use_case": string, "technical_level": "beginner" | "intermediate" | "advanced", "activation_path": ["step_1", "step_2", "step_3"] }} User responses: {user_responses} """ response = client.messages.create( model="claude-3-5-sonnet-20241022", max_tokens=1024, messages=[{"role": "user", "content": prompt}] ) return json.loads(response.content.text)
På så sätt anpassas den första uppgiften efter användarens roll. En marknadsförare får hjälp att koppla in annonskonton, medan en dataingenjör får hjälp att konfigurera API-nycklar. Systemet följer framstegen längs de olika vägarna.
Utforma ditt samtal på 90 sekunder så här: 1. Börja med en bred fråga om målet: "Vad vill du åstadkomma här i dag?" 2.
Följ upp något specifikt som användaren nämner: "Du nämnde X. Vad vill du uppnå med det?" 3.
Ta reda på vilka begränsningar som finns: "Vilka verktyg använder du för det här i dag?" 4. Definiera framgång: "Vad skulle vara ett bra resultat under din första vecka?"
Frågorna ger värdefull insikt utan att samtalet känns som ett förhör. Chattboten hanterar friktionen. Användaren behöver bara berätta.
Steg 3: Inför resultatbaserad aktivering och återföring av data till CRM
Resultatbaserad aktivering är en utvärderingsmetod där AI bedömer om en användare har uppnått ett meningsfullt resultat, i stället för att bara kontrollera om uppgifter i gränssnittet har slutförts. AI-automatiserad kundintroduktion använder den logiken för att utvärdera asynkrona beteendesignaler och inleda uppföljande samtal utifrån användarens faktiska framsteg.
Vi måste sluta räkna klick. Ett klick på "skapa projekt" betyder inte att användaren har fått något värde. Därför behövs spårning av beteendehändelser som kopplas till vad handlingarna faktiskt betyder.
Välkomstmejl i serie har spelat ut sin roll. Getperspective (2026) konstaterar att de ersätts av asynkrona AI-samtal som utlöses av beteendesignaler. Om aktiveringen stannar av efter 24 timmar tar AI kontakt och frågar vad som hindrar användaren. Den skickar inte ett generiskt nyhetsbrev.
Här är pseudokod för bedömningslogiken som ersätter vanliga automatiserade mejlserier:
def evaluate_activation_status(user_events: list) -> str:
    # Define meaningful outcomes
    shipped_shared_item = any(e.name == "item_shared" for e in user_events)
    connected_core_integration = any(e.name == "integration_connected" for e in user_events)

    if shipped_shared_item and connected_core_integration:
        return "Fully Activated"
    elif connected_core_integration and not shipped_shared_item:
        # Stalled after integration
        trigger_ai_follow_up(intent="share_project")
        return "Partial Activation"
    else:
        # Stalled early
        trigger_ai_follow_up(intent="unblock_setup")
        return "At Risk"
Logiken gör att dina kunder får hjälp precis när de kör fast. AI läser händelseströmmen, identifierar vad som saknas och skriver ett specifikt meddelande utifrån situationen. Det besparar supportteamet upprepade frågor om hur tjänsten kommer igång.
Kostnad för AI-baserad kundintroduktion jämfört med manuell
Beräkna din månatliga besparing när du ersätter manuella introduktionssamtal med AI-samtal.
För att införa det här bedömningssystemet behöver du en robust händelsepipeline. Råa händelser lagras i ett datalager som Snowflake eller BigQuery. Bedömningstjänsten körs som ett cronjobb och söker varje timme efter användare som har kört fast.
Den skickar sammanhanget till modellen, som avgör om ett uppföljande chattmeddelande ska skickas.
Vill du se vad AI kan göra för din verksamhet?
Levereras inom 3-5 arbetsdagar. Inga förpliktelser.
En mindre uppenbar insikt: varför helt automatiserad kundintroduktion fortfarande misslyckas
Branschen utgår från att målet är 100 % automatisering. Det stämmer inte. Om du försöker automatisera dokumentverifieringen helt riskerar du brister i regelefterlevnaden och bedrägerier. AI kan flagga avvikelser.
Men en människa måste kontrollera dem. Vi använder 10-20-70-regeln. Det är den bästa modellen för det praktiska arbetet och visar varför arbetsflöden där AI stödjer människor fungerar bättre än helt autonoma system i komplexa B2B-miljöer. Varför fungerar då inte automatisering av hela processen?
Det handlar om förtroende och ansvar. En chatbot kan inte underteckna ett ramavtal. Den kan inte förhandla om anpassade säkerhetsvillkor.
Som Andrew Ng uttryckte det vid Stanford GSB är AI den nya elektriciteten. Den driver elnätet, men det behövs fortfarande elektriker som drar ledningarna i byggnaderna. Dina kundansvariga är de elektrikerna.
De tar hand om de 70 % av uppgifterna som kräver förhandling, empati och anpassade lösningar. AI bygger upp kunskapsbasen och tar fram rätt sammanhang så att människor kan arbeta snabbare. Försök inte ersätta ditt team.
Ge dem bättre verktyg.
Bedömning av beredskap för AI-stödd onboarding
Ta reda på om din organisation är redo för AI-stödd onboarding.
Hur lagras era användardata i dag?
AI bör sköta de 10 % som är repetitiva och hjälpa till med ytterligare 20 %. Låt medarbetarna fokusera på de 70 % där relationer spelar roll. Det är så den här kombinationen ger högst aktiveringsgrad och lägst kundbortfall.
För att skydda personuppgifter vid AI-stödd onboarding måste du maskera identifierande uppgifter innan data skickas till externa API:er för stora språkmodeller och använda lokala modeller för verifiering av känsliga dokument. AI-automatiserad kundonboarding måste förena flexibla samtal med strikta krav på regelefterlevnad och samtidigt hålla driftskostnaderna förutsägbara när tokenanvändningen ökar.
Hur skyddar du personuppgifter och uppfyller regelkraven när onboardingdata skickas till stora språkmodeller?
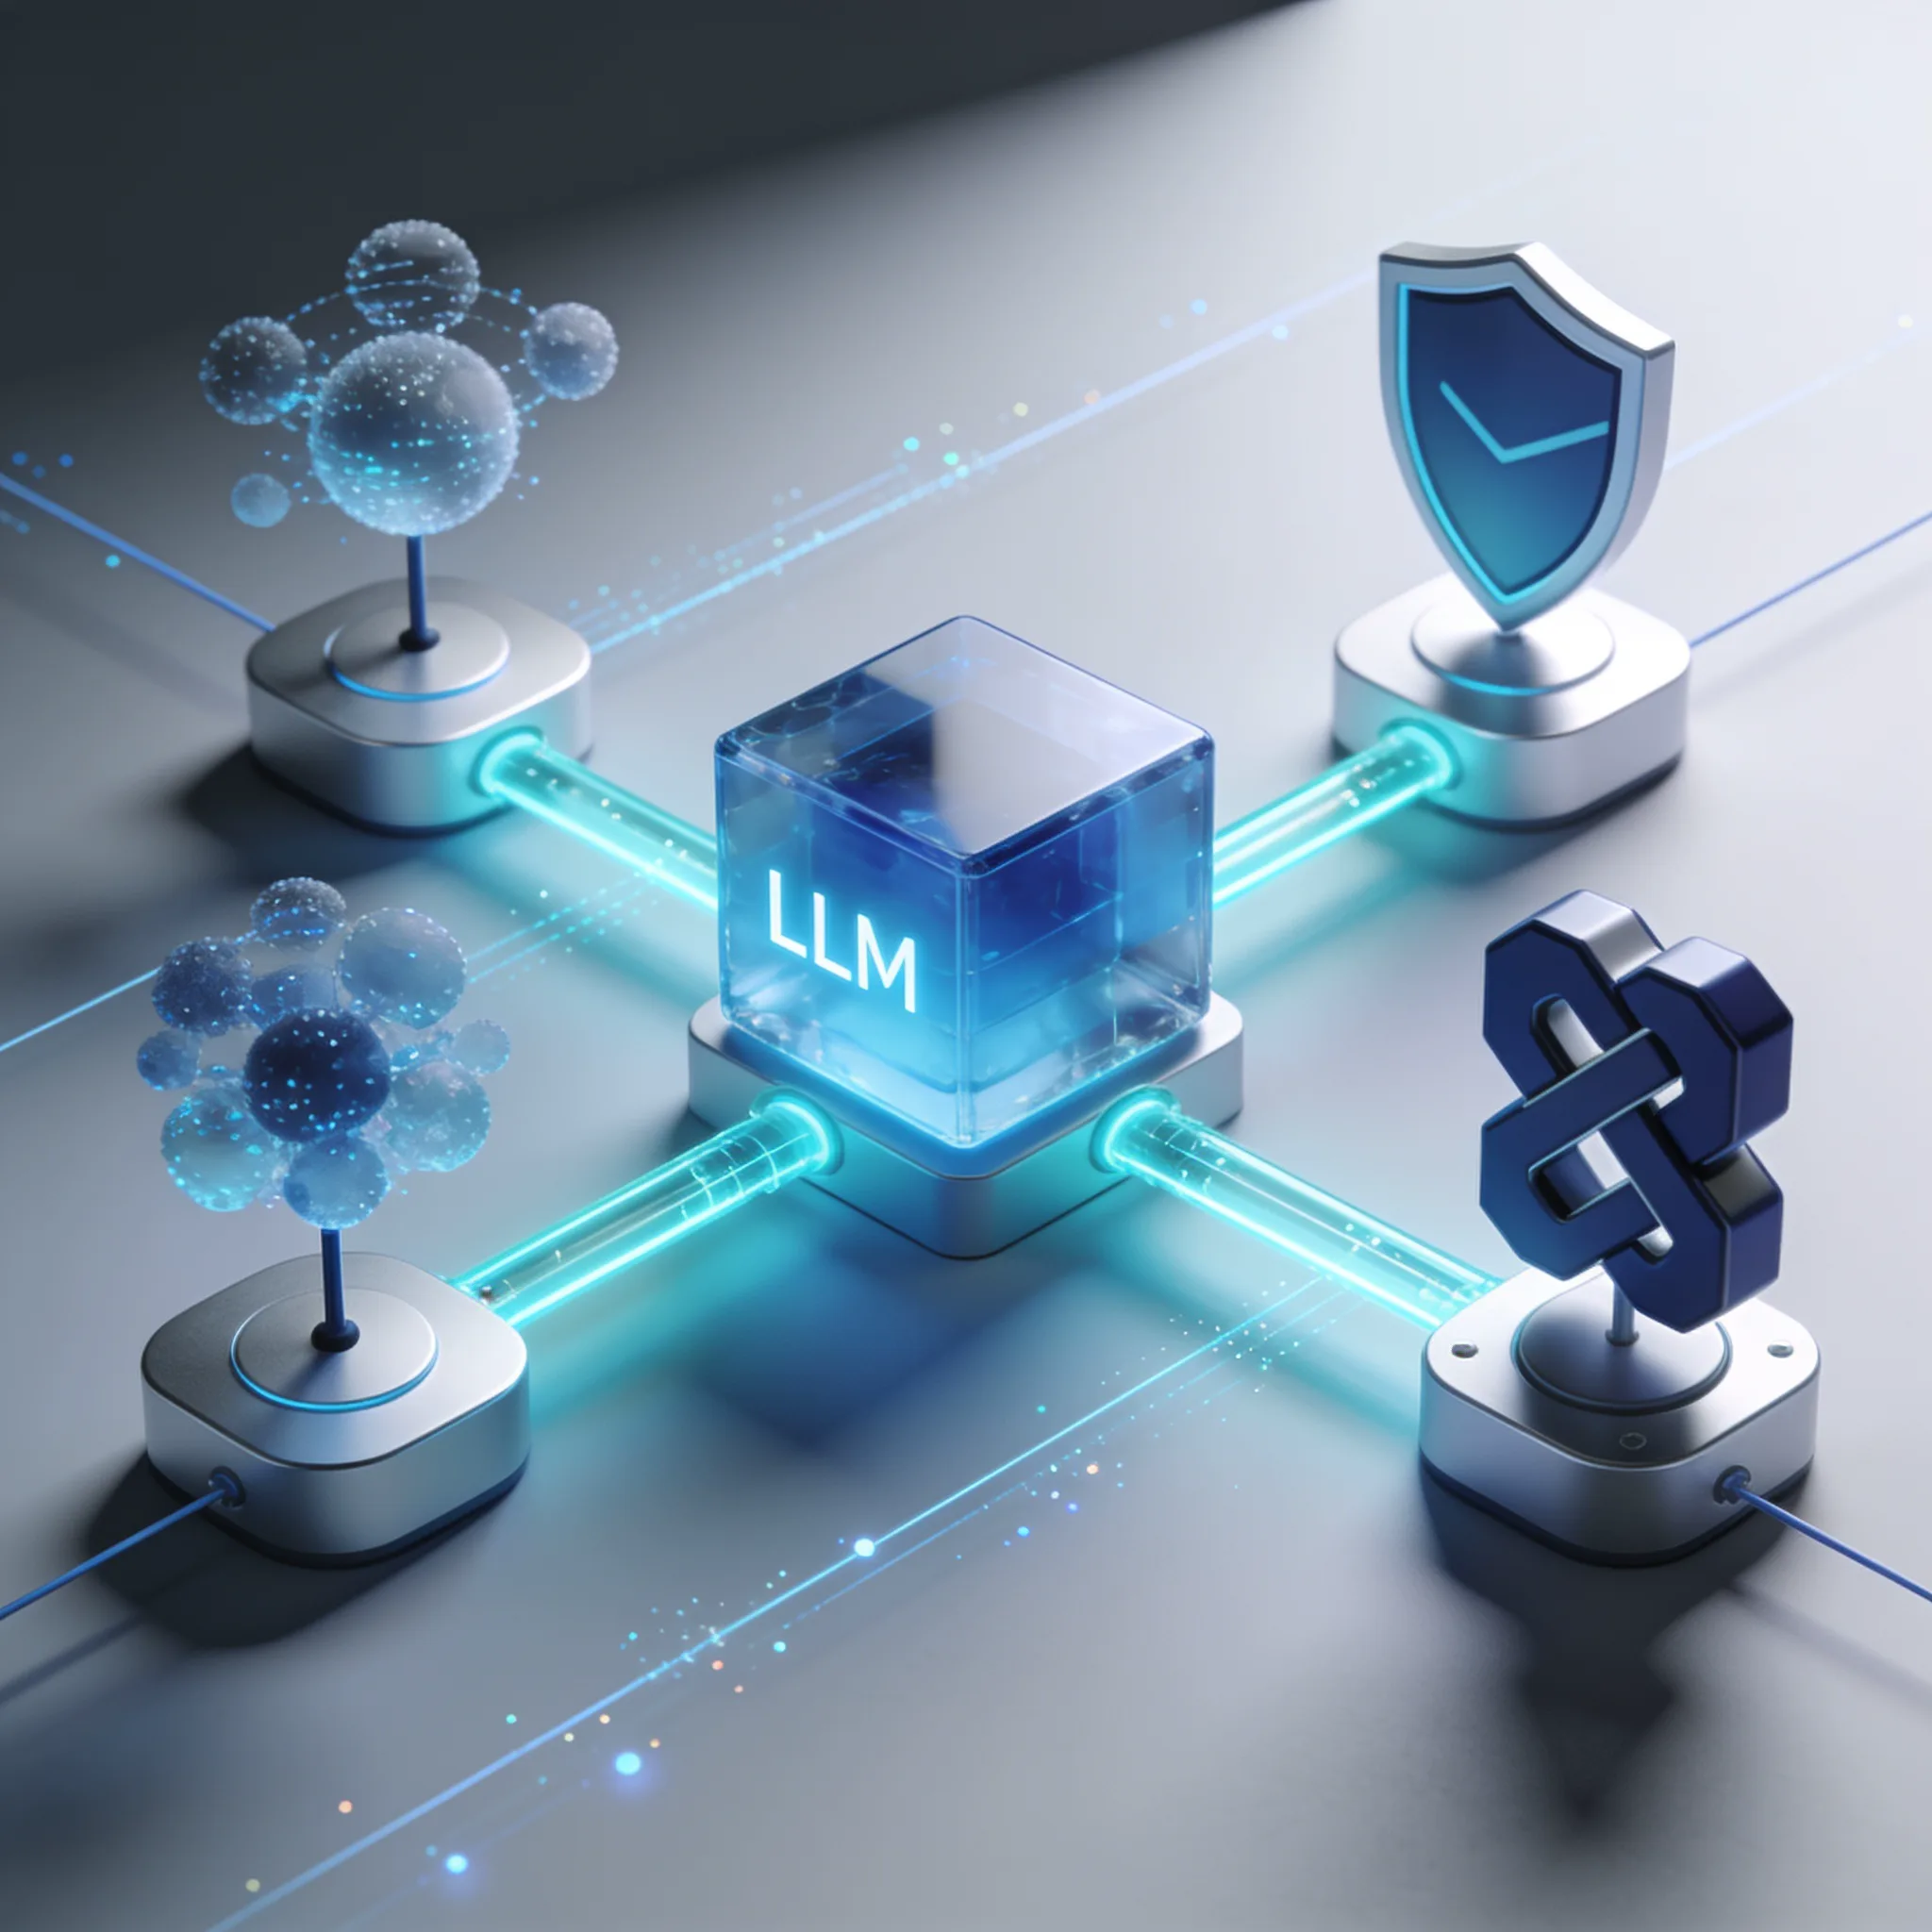
Du kan inte skicka obearbetade användaruppgifter till OpenAI eller Anthropic om de innehåller känsliga uppgifter. Du måste ha ett lager som maskerar personligt identifierande information. Vi använder Microsoft Presidio för att skanna texten innan den når språkmodellen.
Det tar bort namn, e-postadresser och telefonnummer. Språkmodellen får ett rensat sammanhang. Den kan tolka avsikten utan att hantera privata uppgifter.
Använd inte externa API:er för verifiering av känsliga dokument. Kör en lokal modell i stället. Llama 3 eller Mistral på era egna AWS-instanser kan kontrollera att dokument är äkta utan att data lämnar ert VPC.
Allt detta måste samordnas inom er säkerhetsperimeter. Kostnaderna stiger snabbt. Varje samtal förbrukar token. När användningen blir så omfattande är tokenkostnader en betydande kostnadspost för SaaS-företag. Du måste följa upp tokenförbrukningen. Vi begränsar samtalen till 10 turer.
Om en användare passerar 10 turer lämnar chatboten över till en människa. Det hindrar kostnaderna från att skena när en förvirrad användare fastnar i en loop med boten. Vi sparar också vanliga frågor i vår kunskapsbas så att vi slipper onödiga anrop till språkmodellen.
Så här ser tokenkostnaderna ut: * Indatatoken är billiga. * Utdatatoken kostar 3x mer. * Utfyllnad i kontextfönstret tömmer snabbt budgeten.
Om en användare laddar upp ett avtal på 10 sidor ska du inte skicka hela texten till språkmodellen. Använd vektorsökning för att hitta de relevanta 500 orden. Skicka bara de orden till språkmodellen.
Det minskar dina tokenkostnader med 95 %. AI-automatiserad kundonboarding är hållbar bara om du bygger in kostnadseffektivitet från första dagen.
Sluta gissa. Börja bygga med en tydlig plan.
Snabb leverans. Mätbara resultat. Säkerheten först.
Vanliga frågor
