Klantonboarding automatiseren met AI vervangt statische producttours door gesprekken die de intentie van de gebruiker begrijpen en zich aanpassen aan wat elke gebruiker wil bereiken. Deze gids laat zien waarom verouderde tours falen, hoe je de onboardingstack from scratch opzet, hoe je de eerste 90 seconden van het gesprek ontwerpt en welke beoordelingslogica je nodig hebt om deze systemen op schaal te laten draaien.
Bouw je met AI-modellen? Met AIGROW API-tegoed gebruik je Claude-, GPT-, Gemini- en Grok-modellen tot 75% onder de catalogusprijs.
- Meet de activatie na 14 dagen en vergelijk die met je huidige onboardingflow voordat je conversationele AI voor meer gebruikers uitrolt.
- Statische intakeformulieren en verouderde tour-overlays geven elke gebruiker hetzelfde pad. AI-native onboarding vervangt ze door een gesprek van 90 seconden waarin de intentie van de gebruiker naar boven komt.
- Een robuuste AI-onboardingarchitectuur vraagt om een LLM, een vectordatabase voor intentieroutering en een CRM-webhook voor gestructureerde write-backs van data.
- Outcome-Graded Activation verlegt de aandacht van het tellen van klikken op functies naar de vraag of de gebruiker een betekenisvol zakelijk resultaat heeft behaald.
- Ondanks de hype rond volledige autonomie laat de 10-20-70-regel zien dat de effectiefste implementaties een mix zijn van 10% volledig autonome taken, 20% AI-ondersteunde taken en 70% door mensen geleide taken met AI-ondersteuning.
Waarom zou je verouderde producttours vervangen door onboardingautomatisering met AI?
Bouw je nog steeds klikgidsen, dan verlies je gebruikers. Klantonboarding automatiseren met AI zet grote taalmodellen in om statische producttours te vervangen door dynamische gesprekken die de intentie van de gebruiker begrijpen. Zo wordt de context van de gebruiker in realtime vastgelegd en kan het systeem persoonlijke activatiepaden genereren, in plaats van gebruikers door generieke checklists te sturen die hun specifieke rol negeren.
Met een pilot kun je testen of conversationele onboarding de activatie van jouw gebruikers verbetert.
Verouderde producttours gaan ervan uit dat elke gebruiker dezelfde rondleiding van 5 stappen nodig heeft. Dat klopt niet. Een marketingmanager moet advertentiebestedingsdata koppelen, een data-engineer moet het pipelineschema controleren, maar statische tours kunnen die rollen niet van elkaar onderscheiden.
Waarom dan overal dezelfde content neerzetten? Het zorgt voor veel frictie en leidt tot opzeggingen.
Volg bij een hypothetische onboardingpilot voor SaaS de activatie, de tijd tot de eerste waarde, onbeantwoorde vragen, het correctiepercentage en het aantal escalaties naar support. Gebruik de uitgangswaarden van het bedrijf zelf en de waarden uit de pilot, niet een verzonnen dataset van meerdere bedrijven.
| Kenmerk | Verouderde tours (Pendo, Appcues) | AI-gesprekslaag |
|---|---|---|
| Architectuur | DOM-injectie, statische regels | Eventgedreven, LLM-native |
| Gebruikersintentie | Vooraf gekozen dropdowns | Afgeleid uit vrije tekst |
| Activatiepad | Generieke checklists | Persoonlijke flow in 3 stappen |
| Data terugschrijven | Basale eventtracking | Gestructureerde CRM-objecten |
| Activatie na 14 dagen | Meet de bestaande flow | Meet de pilot ten opzichte van die nulmeting |
Ze vertrouwen op exacte selectors die breken zodra de UI wordt aangepast. AI-gesprekslagen staan daarentegen buiten de UI. Ze nemen gedragsevents op, verwerken de intentie via een LLM en geven begeleiding via een chatbot of dynamische banner, waardoor ze veel beter bestand zijn tegen productwijzigingen.
Voor klantonboarding automatiseren met AI heb je een specifieke stack nodig. Je hebt een LLM nodig voor het redeneren, een vectordatabase voor het ophalen van informatie en eventgedreven webhooks voor de CRM-integratie.
Stap 1: je AI-onboardingstack from scratch opzetten
Een ontkoppelde eventstream kan het aantal directe wijzigingen aan de bestaande database verminderen, maar brengt extra eisen met zich mee voor levering, volgorde, replay, privacy en observability. Toets die afwegingen aan het daadwerkelijke systeem.
Deze modellen classificeren de intentie en halen beperkingen uit gespreksinvoer. Ze slaan geen state op. De state hoort thuis in je primaire applicatiedatabase, dus houd de LLM volledig stateless om opgeblazen contextvensters te voorkomen.
Zet vervolgens een vectordatabase in, zoals Pinecone of Weaviate. Die fungeert als je kennisbank.
Als een gebruiker een specifieke vraag stelt over API-limieten, haalt het systeem precies het juiste stuk documentatie op. Zo blijft de LLM gegrond en voorkom je hallucinaties. Elk AI-onboardinggesprek moet als gestructureerd object naar de CRM terugschrijven, met intentie, beperkingen, blokkades, genoemde concurrenten en 'waarom nu', zodat de routeringslogica van marketing en sales direct kan afgaan.
Deze data voedt rechtstreeks je omzetmotor. Dit is de kern van de architectuur:
Voor deze write-back gebruiken we een strikt JSON-schema. Meet de time-to-first-value voor en na een pilot om te zien of de workflow nieuwe gebruikers sneller tot een bruikbaar resultaat helpt. De webhook schrijft rechtstreeks naar HubSpot of Salesforce en stuurt een Slack-melding naar de accountexecutive als een intentie met hoge waarde wordt gedetecteerd, zodat je team nooit een upsellsignaal mist.
{
 "event_type": "onboarding_conversation_completed",
 "user_id": "usr_8821",
 "session_data": {
 "intent": "Migrate DB from Heroku",
 "constraints": ["Budget under 500/mo", "Needs SSO"],
 "blockers": ["Cannot export CSV from current tool"],
 "competitors": ["Heroku", "Supabase"],
 "why_now": "End of quarter migration push"
 },
 "crm_sync": {
 "object_type": "lead",
 "properties": {
 "onboarding_status": "activated",
 "intent_category": "database_migration"
 }
 }
}
Zo sluit je de cirkel tussen productgebruik en omzetgroei. Laat deze data niet in een silo liggen. De eerste interactie na de aanmelding is een AI-gesprek van 90 seconden.
Dat vervangt statische formulieren over rol en teamgrootte door 3 tot 5 open vragen over waarom de gebruiker er is en hoe succes eruitziet.
Stap 2: het eerste gesprek van 90 seconden ontwerpen
Het extraheren van intentie kan fout zijn, ook als de output overeenkomt met een JSON-schema. Toets de betekenis aan beoordeelde gevallen, stuur resultaten met lage zekerheid door naar medewerkers en houd tijdens de pilot bij hoe vaak er wordt gecorrigeerd.
We dwingen het model om zijn bevindingen in een vaste structuur uit te voeren, die de generator van het activatiepad voedt. Hier is een Python-codefragment met een prompttemplate die de LLM-output structureert: client = Anthropic()
import json
from anthropic import Anthropic


prompt = f"""


You are an onboarding diagnostic assistant. Read the user's responses and extract their core intent. Output strictly valid JSON matching this schema: {{ "primary_goal": string, "use_case": string, "technical_level": "beginner" | "intermediate" | "advanced", "activation_path": ["step_1", "step_2", "step_3"] }} User responses: {user_responses} """ response = client.messages.create( model="claude-sonnet-5-5", max_tokens=1024, messages=[{"role": "user", "content": prompt}] ) return json.loads(response.content.text)
Zo wordt de eerste taak afgestemd op de rol van de gebruiker: een marketinggebruiker ziet een pad om advertentieaccounts te koppelen, terwijl een data-engineer een pad ziet om API-sleutels te configureren. Het systeem volgt de voortgang op deze specifieke paden. Hanteer deze regels om je gesprek van 90 seconden te ontwerpen: 1.
Begin met een brede doelvraag: "What brings you here today?" 2.
Vraag door op wat de gebruiker noemt: "You mentioned X. What are you trying to achieve with that?" 3.
Breng beperkingen in kaart: "What tools are you currently using for this?" 4. Definieer succes: "What would a win look like in your first week?"
Met deze volgorde haal je diepe inzichten op zonder dat het een verhoor lijkt. De chatbot vangt de frictie op. De gebruiker praat gewoon.
Stap 3: resultaatgerichte activatie en CRM-write-backs implementeren
Outcome-Graded Activation is een evaluatiemethode waarbij AI bepaalt of een gebruiker een betekenisvol onderliggend resultaat heeft bereikt, in plaats van alleen UI-taken af te ronden. Klantonboarding automatiseren met AI gebruikt deze logica om asynchrone gedragssignalen te beoordelen en vervolggesprekken te starten op basis van het werkelijke succes van de gebruiker.
We moeten stoppen met het tellen van klikken. Klikken op "create project" betekent niet dat de gebruiker waarde heeft gecreëerd. Daarvoor is het tracken van gedragsevents nodig, gekoppeld aan semantische betekenis.
De welkomstmailreeks is dood. Getperspective (2026) meldt dat de welkomstmailreeks wordt vervangen door asynchrone AI-gesprekken die door gedragssignalen worden getriggerd. Stokt de activatie na 24 uur, dan start de AI een check-in.
Die vraagt wat de gebruiker tegenhoudt. Er gaat geen generieke nieuwsbrief uit.
Hier is pseudocode voor de beoordelingslogica die standaard e-maildripcampagnes vervangt:
def evaluate_activation_status(user_events: list) -> str:
    # Define meaningful outcomes
    shipped_shared_item = any(e.name == "item_shared" for e in user_events)
    connected_core_integration = any(e.name == "integration_connected" for e in user_events)

    if shipped_shared_item and connected_core_integration:
        return "Fully Activated"
    elif connected_core_integration and not shipped_shared_item:
        # Stalled after integration
        trigger_ai_follow_up(intent="share_project")
        return "Partial Activation"
    else:
        # Stalled early
        trigger_ai_follow_up(intent="unblock_setup")
        return "At Risk"
Deze logica zorgt ervoor dat je klanten precies hulp krijgen op het moment dat ze vastlopen. De AI leest de eventstream, ziet waar het ontbreekt en genereert een specifiek bericht dat bij de context past. Zo hoeft je supportteam niet steeds dezelfde setupvragen te beantwoorden.
Kosten AI-onboarding versus handmatige kosten
Bereken je maandelijkse besparing door handmatige onboardinggesprekken te vervangen door AI-gesprekken.
Voor dit beoordelingssysteem is een robuuste eventpipeline nodig. Je hebt een datawarehouse zoals Snowflake of BigQuery nodig om ruwe events op te slaan. De beoordelingsservice draait als cronjob en zoekt elk uur naar gebruikers die zijn vastgelopen.
Hij geeft de context door aan de LLM, die beslist of er een vervolgbericht van de chatbot moet worden getriggerd.
Het ongemakkelijke inzicht: waarom volledig geautomatiseerde onboarding nog steeds faalt
De sector gaat ervan uit dat 100% automatisering het doel is. Dat klopt niet. Als je documentverificatie volledig probeert te automatiseren, riskeer je compliancefouten en fraude. AI kan afwijkingen signaleren.
Maar een mens moet ze controleren. Wij hanteren de 10-20-70-regel. Dit is het optimale operationele model en het bewijst dat door AI ondersteunde menselijke workflows beter presteren dan volledig autonome systemen in complexe B2B-omgevingen. Waarom faalt end-to-end automatisering nog steeds?
De reden is vertrouwen en aansprakelijkheid. Een chatbot kan geen raamovereenkomst voor dienstverlening ondertekenen. Hij kan geen maatwerkafspraken over beveiliging onderhandelen.
Zoals Andrew Ng het bij Stanford GSB zei: AI is de nieuwe elektriciteit. Het voedt het net, maar je hebt nog steeds elektriciens nodig om de gebouwen aan te sluiten, en jouw customer success managers zijn die elektriciens. Zij handelen de 70% van de taken af waarvoor onderhandeling, empathie en oplossingen op maat nodig zijn.
De AI bouwt de kennisbank op en bereidt de context voor, zodat de mens sneller kan werken. Probeer je team niet te vervangen. Rust het uit.
Beoordeling van gereedheid voor AI-onboarding
Ontdek of jouw organisatie klaar is om door AI ondersteunde onboarding in te zetten.
Hoe worden je gebruikersgegevens nu opgeslagen?
De AI moet de repetitieve 10% afhandelen en helpen bij de 20%. Je medewerkers richten zich op de 70% waarbij relaties ertoe doen. Juist deze hybride aanpak levert de hoogste activatiepercentages en de laagste churn op.
Voor dataprivacy bij AI-onboarding moet je persoonsgegevens verwijderen voordat je data naar externe LLM-API's stuurt, en lokale modellen inrichten voor de verificatie van gevoelige documenten. Klantonboarding met AI moet conversationele flexibiliteit in balans brengen met strikte compliancegrenzen, zodat de operationele kosten voorspelbaar blijven naarmate het tokengebruik groeit.
Hoe ga je om met dataprivacy en compliance als je onboardingdata aan LLM's voedt?
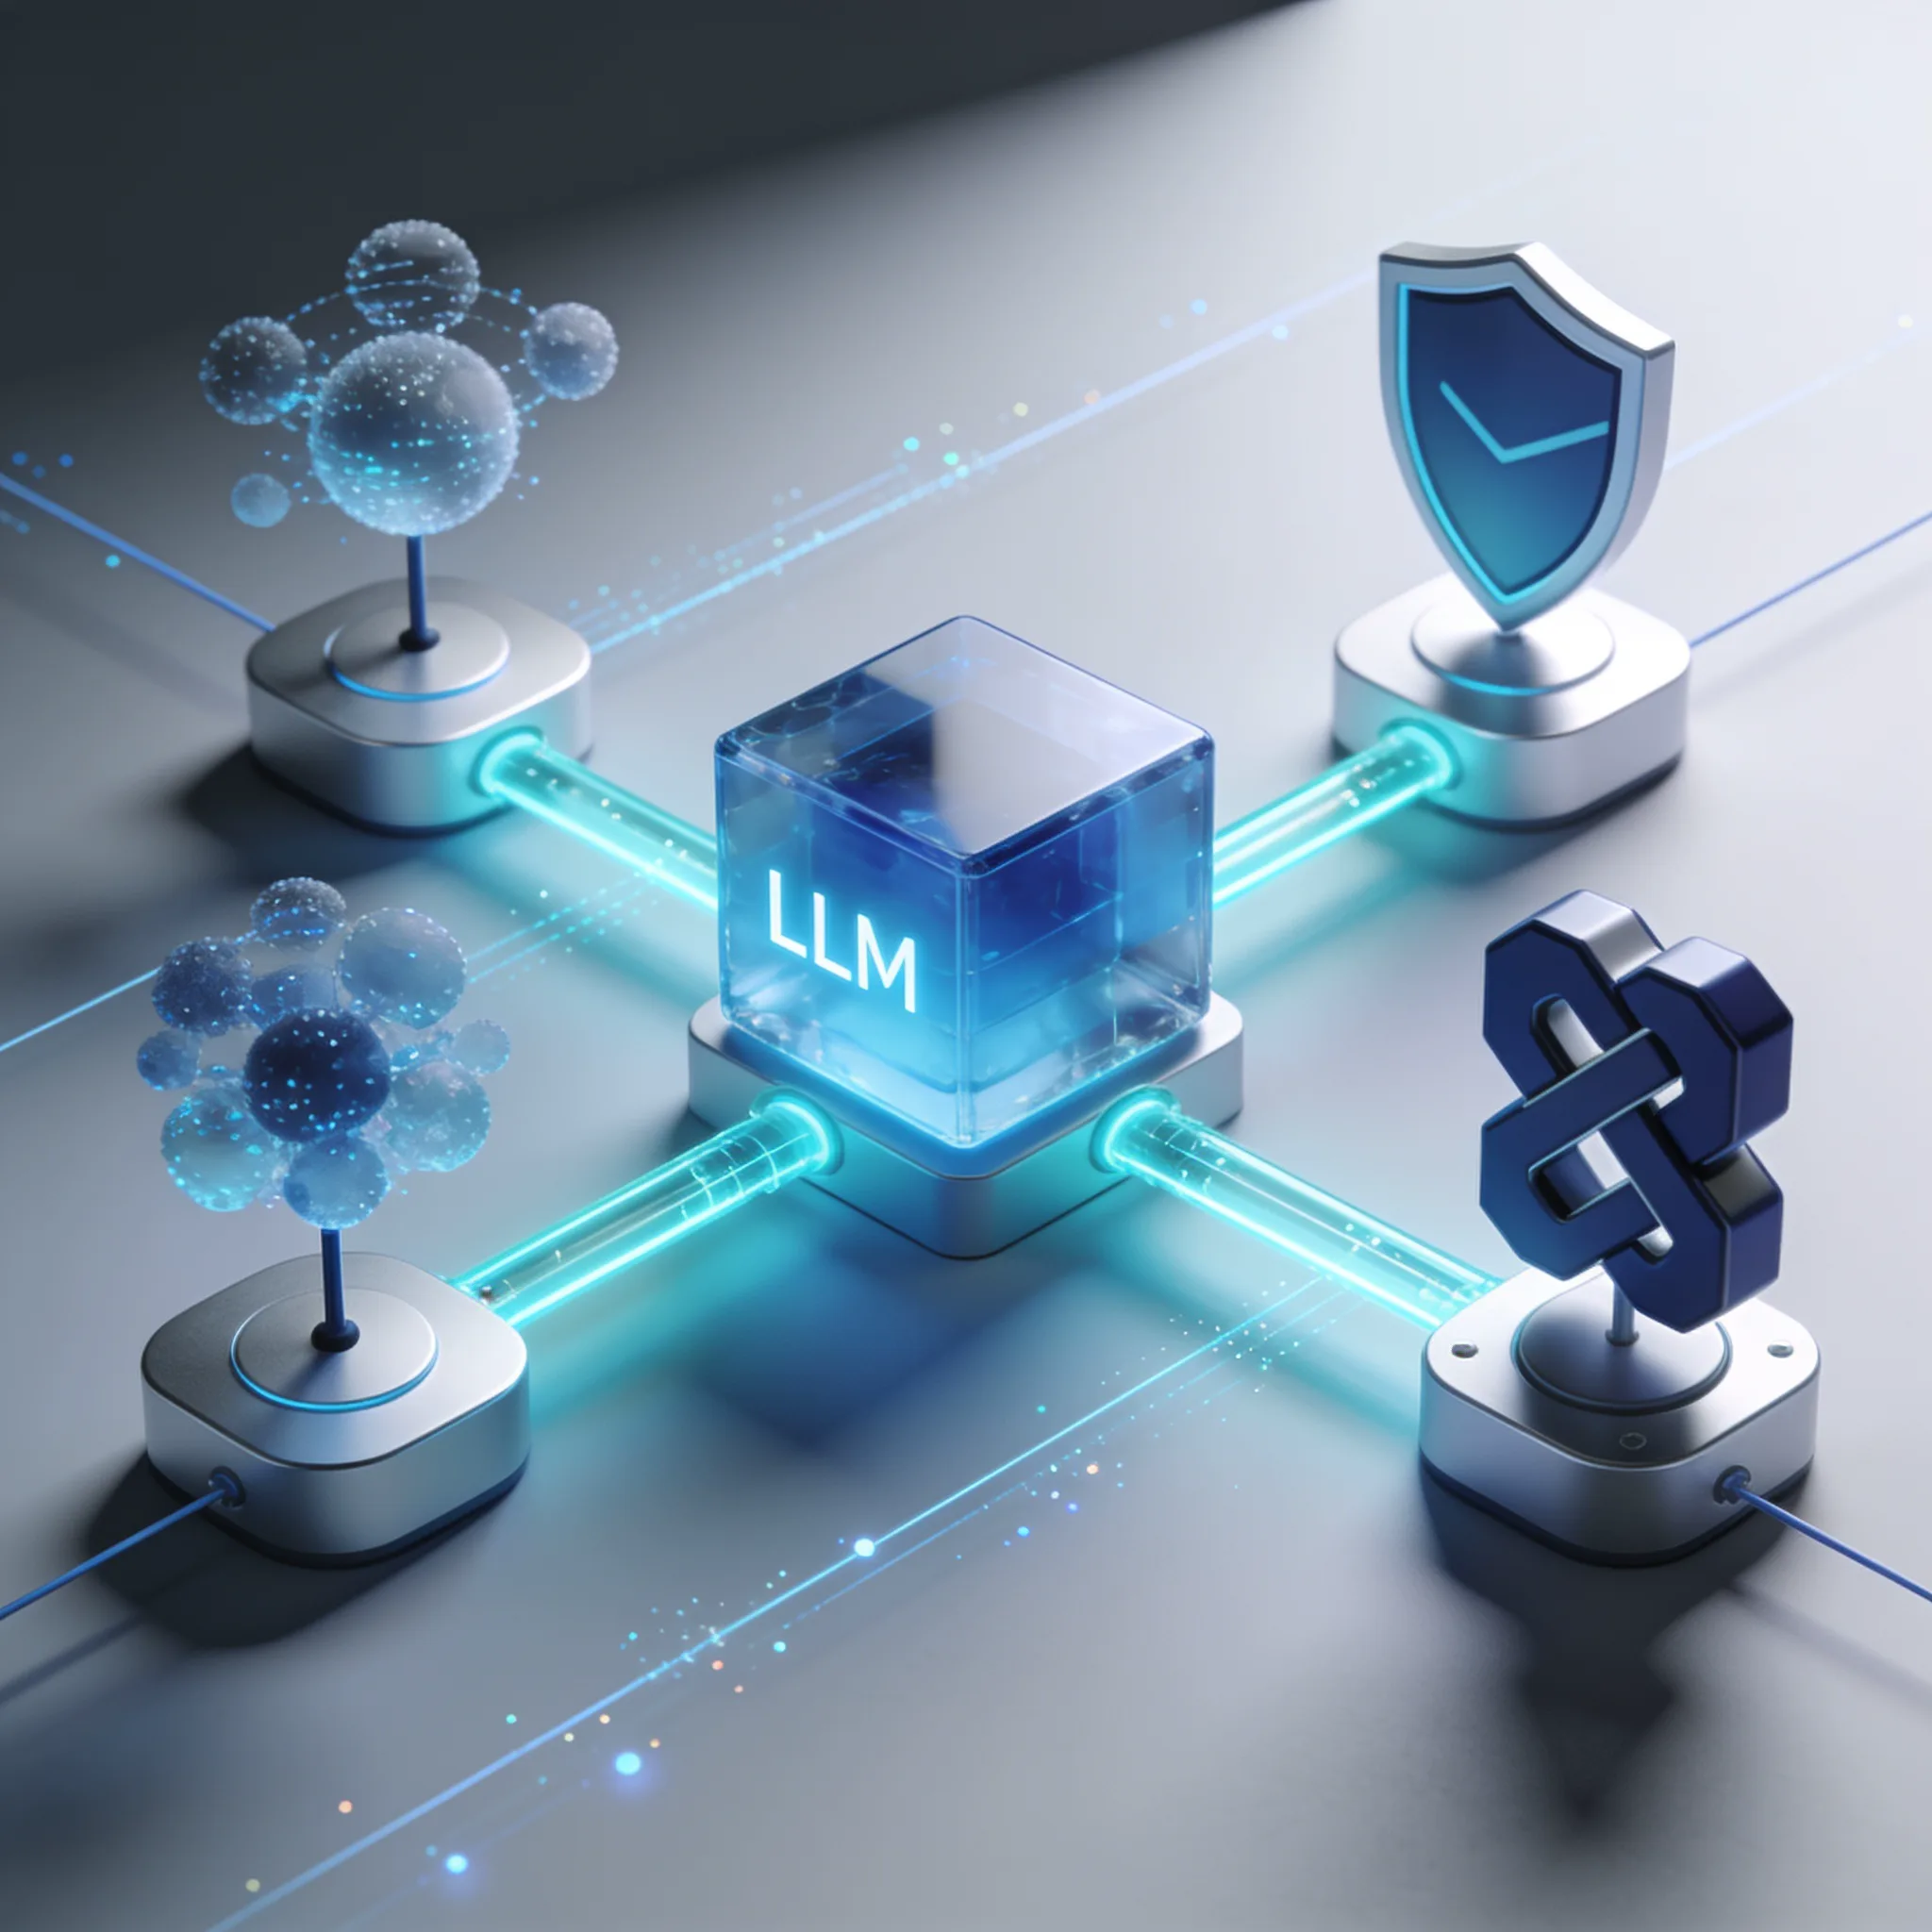
Je kunt ongefilterde gebruikersinvoer niet naar OpenAI of Anthropic sturen als die gevoelige gegevens bevat. Je moet een laag voor het verwijderen van persoonsgegevens implementeren. Wij gebruiken Microsoft Presidio om tekst te scannen voordat die bij de LLM terechtkomt.
Dit haalt namen, e-mailadressen en telefoonnummers eruit. De LLM ontvangt gesaneerde context. Hij verwerkt de intentie zonder privégegevens aan te raken.
Gebruik voor de verificatie van gevoelige documenten geen externe API's. Zet in plaats daarvan een lokaal model in. Een open-weight model op je eigen AWS-instances kan de echtheid van documenten verifiëren zonder dat data je VPC verlaat.
Deze orkestratie moet binnen je beveiligingsperimeter plaatsvinden. Kosten lopen snel op. Elk gesprek kost tokens. Door deze massale adoptie zijn tokenkosten nu een belangrijke kostenpost voor SaaS-bedrijven. Je moet je tokenverbruik bijhouden. Wij beperken gesprekken tot 10 beurten.
Als een gebruiker meer dan 10 beurten nodig heeft, stuurt de chatbot hem door naar een mens. Zo voorkom je dat kosten uit de hand lopen doordat verwarde gebruikers de bot in een lus houden. Daarnaast cachen we veelgestelde vragen in onze kennisbank om overbodige LLM-aanroepen te vermijden.
Houd tokenkosten apart bij: * Inputtokens worden gefactureerd tegen het inputtarief van het gekozen model. * Outputtokens hebben een eigen, modelspecifiek tarief. * Overbodige context verhoogt de inputrekening.
Als een gebruiker een contract van 10 pagina's uploadt, geef dan niet de volledige tekst door aan de LLM. Gebruik vectorzoeken om de relevante 500 woorden te vinden. Geef alleen die woorden door aan de LLM.
Dit verlaagt het aantal inputtokens; de besparing hangt af van de tekstlengte en de modelprijzen. Klantonboarding met AI is alleen houdbaar als je vanaf dag één ontwerpt met kostenefficiëntie in gedachten.
Actuele Claude-, GPT-, Gemini- en Grok-modellen, tot 75% onder de catalogusprijs
Eén API-sleutel voor Claude-, GPT-, Gemini- en Grok-modellen via de OpenAI SDK. Claude-modellen werken ook met de Anthropic SDK en Claude Code.
Het tarief van elk model via AIGROW-tegoed staat naast de catalogusprijs van de maker en komt daar nooit boven.
Veelgestelde vragen
