Un stack de automatización escalable necesita más que un orquestador y un modelo. Define colas, reintentos, idempotencia, permisos, monitorización, controles de costes, copias de seguridad, responsables y procedimientos de recuperación para un primer flujo de trabajo. El autoalojamiento puede reducir las licencias y aumentar el trabajo de ingeniería, así que compara el coste operativo total y la fiabilidad antes de añadir más componentes.
¿Desarrollas con modelos de IA? El crédito de API de AIGROW ejecuta modelos de Claude, GPT, Gemini, Grok, Qwen y Kimi hasta un 75 % por debajo del precio de lista.
- Un stack escalable necesita responsables definidos, colas, reintentos, idempotencia, monitorización, controles de costes y procedimientos de recuperación.
- El software autoalojado traslada los costes a la infraestructura, las actualizaciones, la seguridad, las copias de seguridad y las guardias. Incluye ese trabajo en tus comparaciones.
- Empieza con un solo flujo de trabajo y añade componentes únicamente cuando eliminen una limitación medida o mejoren la fiabilidad.
Paso 1: ¿Cómo diseñar un stack de automatización para las operaciones empresariales?
La orquestación autoalojada exige ocuparse de la disponibilidad, la seguridad, las actualizaciones y la recuperación. Antes de elegirla, prueba una carga de trabajo representativa y registra los eventos perdidos, las incidencias y el tiempo dedicado al mantenimiento.
Un stack con n8n, Claude Code y DataForSEO puede ejecutar auditorías SEO programadas, procesos de seguimiento de posiciones, publicación de contenido y comprobaciones del estado de un sitio sin que tengas que pulsar un botón. La misma arquitectura sirve para otras operaciones. Capturas un nuevo lead desde tu web, se lo pasas a Claude para que lo evalúe y envías los datos enriquecidos directamente a Salesforce.
Este es el flujo del sistema que utilizamos para dirigir los datos operativos. Atiende ventas, incorporación de clientes e informes internos sin supervisión constante. El servidor de n8n actúa como centro de operaciones.
Recibe activadores desde tu frontend o CRM.
Después llama a un agente de Claude para procesar o dar formato a los datos recibidos antes de enviar el resultado a la API correspondiente. Para montarlo, debes seguir una secuencia de configuración estricta. El código abierto no sale gratis.
Tiene otros costes, y quien te diga lo contrario está intentando venderte algo.
A la competencia le encanta destacar las cifras de ahorro, pero suele pasar por alto la complejidad de la configuración y el mantenimiento de las instancias autoalojadas (justo donde muchos equipos acaban abandonando).
- [ ] Contrata un VPS de $5/mes con el proveedor de nube que prefieras
- [ ] Instala n8n con Docker Compose para aislar la orquestación
- [ ] Conecta tu base de datos principal como credencial de n8n
- [ ] Crea el primer activador webhook para captar leads entrantes
- [ ] Añade un nodo de Claude Code para evaluar los datos del lead
- [ ] Envía los leads cualificados a la API de tu CRM
- [ ] Configura flujos de respaldo para las llamadas a la API que fallen
- [ ] Monitoriza los registros de ejecución durante las primeras 48 horas
Por qué el stack de automatización de código abierto «gratis» cuesta más de lo que crees
Lo presentan como software sin coste que funciona perfectamente por arte de magia. Sabemos lo que ocurre en realidad, y no tiene ninguna gracia cuando un conflicto entre módulos de Node rompe todo el proceso a las 2 de la madrugada.
Los números quedan muy bien en una hoja de cálculo. Pero esa hoja no cuenta las horas que tu ingeniero trabaja el fin de semana, los problemas de control de versiones ni los certificados SSL que, por alguna razón, siempre caducan en el peor momento. Si autoalojas un stack de automatización, te haces cargo de la infraestructura.
No desaconsejamos el autoalojamiento, pero sí hacerlo sin prever sus costes. Debes presupuestar el tiempo de desarrollo o el mantenimiento invisible acabará saliéndote muy caro.
Si tu ingeniero principal dedica 4 horas semanales a gestionar el servidor, tu stack de $52 cuesta en realidad $452 (a $100/hora, una tarifa conservadora para un ingeniero DevOps competente). Calcula el coste total de propiedad antes de dejar una solución SaaS. Lo que más pesa es la complejidad de depurar los fallos.
Una plataforma SaaS se ocupa de los cambios en los límites de solicitudes de las API. Cuando Google modifica el esquema de su API, Zapier publica una actualización que ni siquiera llegas a notar.
En un stack autoalojado, el flujo de trabajo falla a las 2 de la madrugada y el desarrollador de guardia tiene que levantarse para arreglarlo. Sopesa la flexibilidad del código abierto frente a esa carga de mantenimiento. Si tu equipo no tiene conocimientos básicos de DevOps, no montes este stack.
Paga la suscripción SaaS y duerme tranquilo.
La reducción de costes de 19 veces solo es real si tu infraestructura se mantiene estable, y la estabilidad no llega por desearla. Model Context Protocol es un estándar abierto de Anthropic que define cómo un asistente de IA accede a herramientas y fuentes de datos externas. Así, tus LLM pueden consultar datos en tiempo real en lugar de inventar respuestas.
Esto ataja las alucinaciones. Creamos servidores MCP para que nuestros agentes accedan directamente a bases de datos empresariales y API externas.
Paso 2: usar Model Context Protocol para obtener datos en tiempo real
Model Context Protocol es un estándar abierto presentado por Anthropic que define cómo un asistente de IA accede a herramientas y fuentes de datos externas. Permite que los LLM consulten datos en tiempo real en lugar de inventar respuestas. Implementamos servidores MCP para dar a nuestros agentes de IA acceso directo a bases de datos empresariales y API externas.
Esto ataja las alucinaciones.
Plataformas SEO como Ahrefs y SEMrush ya ofrecen servidores MCP. Así, los desarrolladores pueden incorporar fuentes de datos intercambiables a sus stacks de automatización. Tu agente puede consultar directamente datos actuales de las páginas de resultados, volúmenes de búsqueda de palabras clave y enlaces entrantes de la competencia.
Ya no depende de datos de entrenamiento desactualizados de 2024.
Un proceso completo de automatización SEO con IA y MCP consta de 7 pasos:
- Evaluar palabras clave mediante API de volumen de búsqueda en tiempo real
- Clasificar las consultas por intención de búsqueda con Claude
- Extraer el contenido de la competencia de las páginas mejor posicionadas
- Analizar las oportunidades de contenido comparando tu sitio con los de la competencia
- Generar un esquema a partir de las entidades semánticas que faltan
- Redactar siguiendo el esquema con el agente de Claude Code
- Comprobar la exactitud de los datos y la fluidez del texto
Este protocolo cambia la forma de crear plantillas. Ya no necesitas programar las llamadas a la API directamente en tu flujo de trabajo de n8n. Expones la API mediante un servidor MCP y le indicas a Claude Code qué servidores están disponibles.
El modelo decide cuándo usar cada herramienta según la tarea que le pidas.
Esta arquitectura ofrece mucha flexibilidad. Si cambias Ahrefs por SEMrush, solo tienes que sustituir el endpoint del servidor MCP. La lógica de tu flujo de trabajo no cambia.
El agente de IA adapta automáticamente sus llamadas a las herramientas. Así consigues un stack de automatización modular que resiste los cambios de proveedor.
Paso 3: comparar el coste total de propiedad de los stacks SaaS y autoalojados
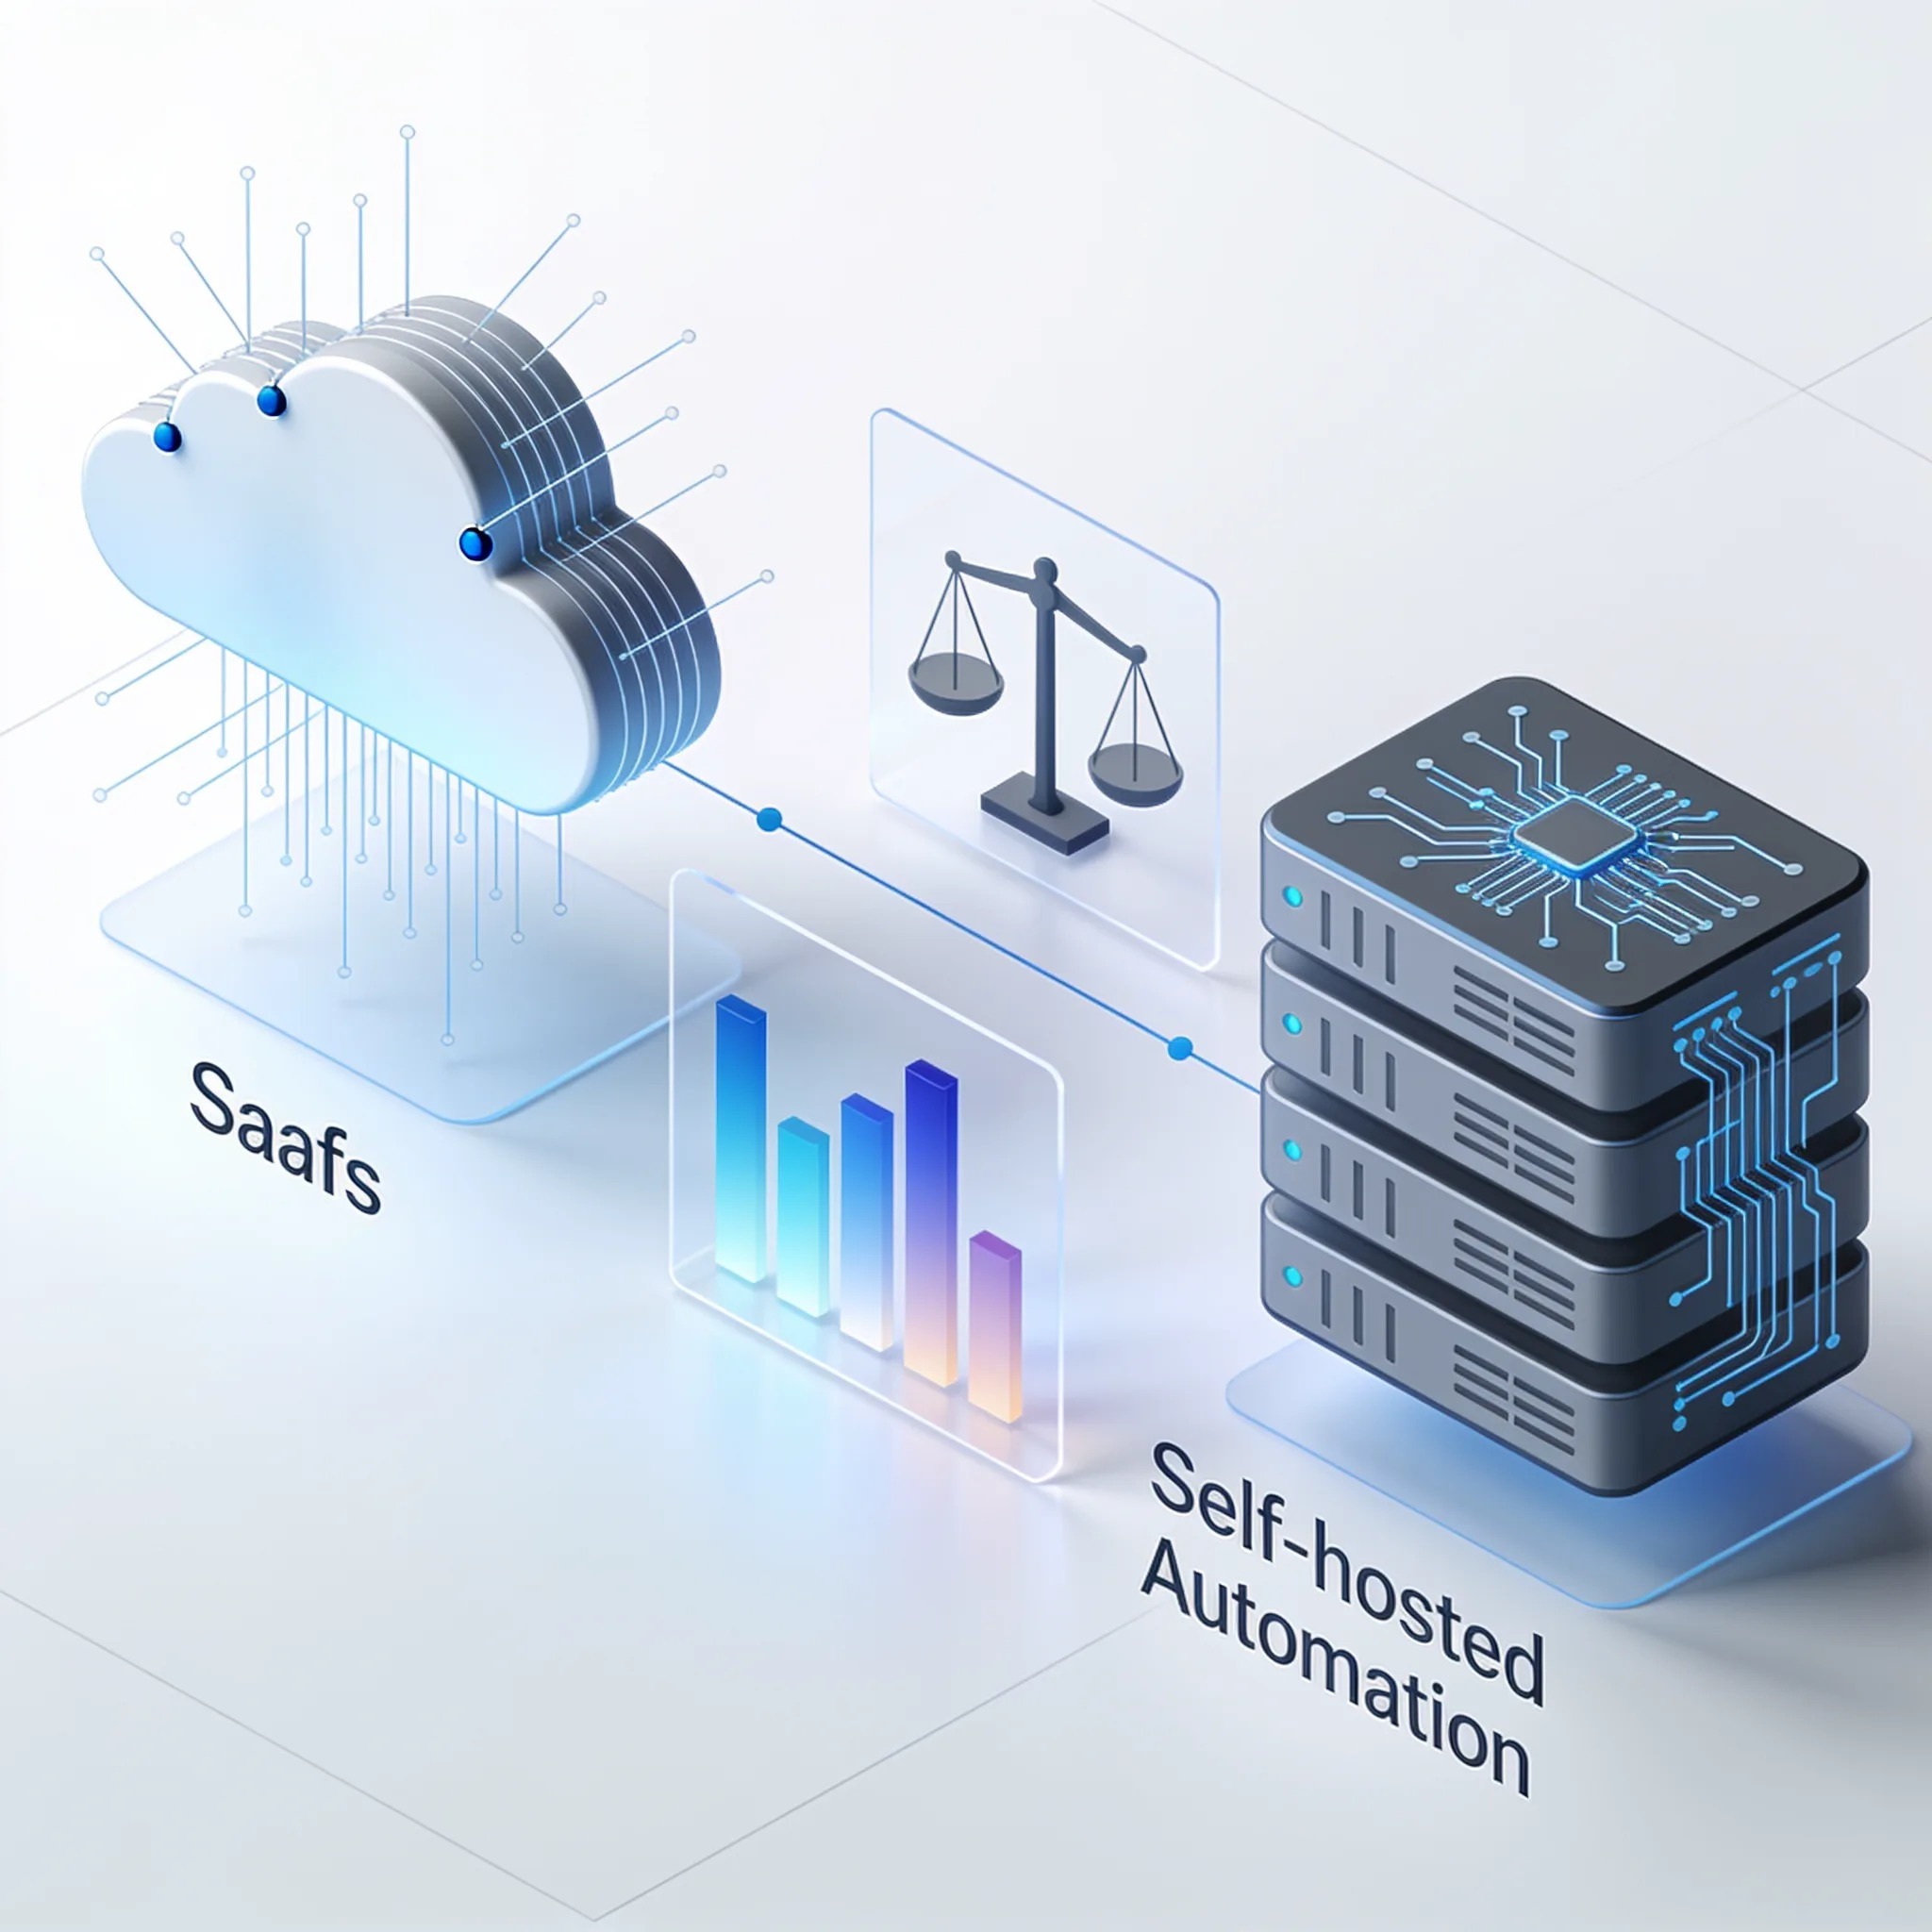
El código abierto destaca por su capacidad de escalar y admitir lógica personalizada. Obtenemos datos de las páginas de resultados y auditorías de sitios mediante la API de DataForSEO (unos $30/mes con pago por uso). La API de Google Search Console nos proporciona gratis datos propios sobre posiciones y clics para validar los resultados de nuestro stack de automatización.
Así se compara un stack SaaS estándar con nuestra arquitectura autoalojada:
Para entender el retorno de la inversión, fíjate en los datos JSON concretos que enviamos a DataForSEO desde nuestro flujo de trabajo de n8n. Son la base de todo nuestro proceso de investigación de palabras clave.
Al escalarlo, el ahorro es considerable.
| Característica | Stack SaaS estándar | Stack de n8n autoalojado |
|---|---|---|
| Coste base | $980 / mes | $52 / mes |
| Límites de llamadas a la API | Límites estrictos según el plan | Dependen de tu proveedor |
| Lógica personalizada | Limitada a filtros básicos | JavaScript / Python completos |
| Mantenimiento | A cargo del proveedor | Requiere DevOps interno |
| Privacidad de los datos | Alojados en servidores del proveedor | Almacenados en tu propio VPS |
Gestionar un stack de automatización a escala exige protocolos estrictos para los límites de solicitudes de las API, la privacidad de los datos y la recuperación automática.
{
 "version": "v3",
 "method": "KeywordsData/KnowledgeGraph/Search",
 "params": {
 "keyword": "automation stack",
 "depth": 10,
 "limit": 50
 }
}
Los límites de solicitudes no gestionados y los tiempos de espera de API que pasan inadvertidos pueden romper los flujos de trabajo sin que nadie se entere de inmediato. Incorpora reintentos, idempotencia, alertas, gestión de mensajes no procesados y un procedimiento de recuperación documentado a la orquestación.
Calculadora del coste total del stack de automatización
Compara el coste actual de tus operaciones con SaaS con el de un stack de automatización autoalojado.
Paso 4: ¿Cómo gestionar los límites de las API, la seguridad y la recuperación a escala?
El control de calidad de los sistemas de automatización con IA debe incluir instrucciones que revisen los borradores generados para detectar estadísticas inventadas o citas falsas. Toda afirmación basada en datos debe citar una cifra real obtenida de una fuente. No puedes confiar en que el modelo detecte sus propios errores, porque no lo hará.
Para detectar estos problemas, añade un nodo de validación independiente al flujo de trabajo. La Indexing API de Google solo acepta notificaciones de páginas que incluyan JobPosting o BroadcastEvent dentro de un VideoObject. Para las páginas normales, utiliza enlaces internos y un sitemap; ninguno garantiza cuándo se rastrearán.
Los sistemas de automatización también pueden ejecutar tareas en el navegador con herramientas como Claude Code y Playwright MCP Server. Así, tu agente puede interactuar incluso con sitios web que no tienen API públicas.
Para proteger tu sistema, sigue estos pasos operativos. No omitas la cola de mensajes fallidos (Dead Letter Queue). Si un flujo de trabajo falla a las 2 de la madrugada, sus datos deben quedar en una tabla de la base de datos para que otro flujo los procese cada mañana.
- Guarda todas las claves de API en el almacén cifrado de credenciales de n8n, nunca como texto sin cifrar en los nodos
- Configura reintentos con espera exponencial para todos los nodos de solicitudes HTTP
- Envía los datos sensibles de clientes solo a través de subredes privadas
- Configura colas de mensajes fallidos para las ejecuciones de flujos de trabajo que fallen
- Revisa mensualmente las instrucciones de los agentes para prevenir ataques de inyección de instrucciones
- Limita los agentes de navegador Playwright a los dominios autorizados
Si no implementas estas medidas, puedes perder datos definitivamente. ¿Está tu infraestructura preparada para soportar este volumen de trabajo? Averigua en qué punto estás. Para ampliar la producción de contenido, hay que pasar de la redacción manual a la coordinación de agentes mediante plantillas.
Antes de cambiar, un equipo puede comparar las herramientas de investigación de código abierto con el uso que hace de Ahrefs, sus necesidades de calidad de datos y soporte, y el coste operativo total.
Implementar n8n y Claude Code para crear flujos de producción de contenido a gran escala
Usamos claude-seo, una herramienta de auditoría SEO de código abierto que funciona como skill de Claude Code y realiza 186 comprobaciones SEO en una sola auditoría. Ha acumulado 2974 estrellas en GitHub. Nada mal para un proyecto comunitario.
Sustituye suscripciones mensuales costosas y nos permite controlar cada comprobación mediante código con mayor precisión. Rankenstein es un sistema de automatización SEO basado en n8n que automatiza los procesos SEO de principio a fin. Lo implementamos junto con claude-seo para gestionar el flujo de contenido, desde la palabra clave hasta la publicación.
El servidor de n8n activa el agente de Claude Code, que consulta la base de datos RAG para encontrar oportunidades de enlaces internos, redacta el artículo, ejecuta la auditoría de claude-seo y publica la página. Ese es el proceso completo.
Esta es la secuencia de implementación que seguimos. Como dijo Andrew Ng en Stanford GSB, «La IA es la nueva electricidad». Pero la electricidad necesita una red. Tu flujo de trabajo de n8n es esa red: lleva la capacidad del modelo de IA a las operaciones de tu empresa.
- Carga la documentación existente de la empresa en la base de datos vectorial RAG
- Configura la plantilla de n8n de Rankenstein con las credenciales de tu CMS
- Instala la skill claude-seo en tu entorno de Claude Code
- Activa el primer flujo de trabajo de generación de contenido mediante un webhook
- Revisa el informe de auditoría SEO de 186 puntos generado por el agente
- Aprueba el borrador para que se publique automáticamente en tu CMS
- Notifica a Google mediante su Indexing API solo si se trata de páginas aptas sobre ofertas de empleo o emisiones en directo; para las páginas normales, utiliza un sitemap
Modelos actuales de Claude, GPT, Gemini, Grok, Qwen y Kimi, hasta un 75 % por debajo del precio de lista
Una sola clave de API para los modelos de Claude, GPT, Gemini, Grok, Qwen y Kimi con el SDK de OpenAI. Los modelos de Claude también funcionan con el SDK de Anthropic y con Claude Code.
La tarifa de cada modelo con el crédito de AIGROW figura junto al precio de lista de su fabricante, nunca por encima.
Preguntas frecuentes
