En skalbar automationsstack kräver mer än ett orkestreringsverktyg och en modell. Börja med ett arbetsflöde och fastställ köer, nya försök, idempotens, behörigheter, övervakning, kostnadskontroll, säkerhetskopiering, ansvar och återställning. Egen drift kan sänka licensavgifterna men öka arbetsinsatsen för utvecklarna. Jämför därför den totala driftskostnaden och driftsäkerheten innan du lägger till fler komponenter.
Bygger du med AI-modeller? API-kredit från AIGROW kör modellerna Claude, GPT, Gemini och Grok upp till 75 % under listpris.
- En skalbar stack behöver tydligt ansvar, köer, nya försök, idempotens, övervakning, kostnadskontroll och rutiner för återställning.
- Med egen drift flyttas kostnaderna till infrastruktur, uppgraderingar, säkerhet, säkerhetskopiering och jourarbete. Räkna med den arbetstiden när du jämför alternativen.
- Börja med ett arbetsflöde och lägg bara till komponenter när de löser ett uppmätt problem eller ökar driftsäkerheten.
Steg 1: Hur utformar du en automationsstack för den löpande verksamheten?
Egen drift av orkestreringen innebär arbete med drifttid, säkerhet, uppgraderingar och återställning. Kör en representativ arbetsbelastning och dokumentera förlorade händelser, incidenter och underhållstid innan du väljer den lösningen.
En stack med n8n, Claude Code och DataForSEO kan sköta schemalagda SEO-granskningar, uppföljning av sökplaceringar, innehållspublicering och kontroller av webbplatsens hälsa utan att du behöver trycka på en knapp. Samma arkitektur fungerar även för den övriga verksamheten. Du hämtar en ny lead från webbplatsen, låter Claude kvalificera den och skickar de kompletterade uppgifterna direkt till Salesforce.
Så här flödar verksamhetsdata genom vårt system. Lösningen hanterar försäljning, kundintroduktion och intern rapportering utan ständig tillsyn. n8n-servern fungerar som nav.
Den tar emot triggers från ditt frontend eller CRM.
Sedan anropar den en Claude-agent som bearbetar eller formaterar datan innan resultatet skickas till rätt API längre ned i kedjan. För att bygga detta behöver du följa en bestämd ordning. Öppen källkod är inte gratis. Kostnaden ser bara annorlunda ut, oavsett vad någon försöker sälja in.
Konkurrenter lyfter gärna fram besparingarna men nämner sällan hur komplicerad installationen är eller hur mycket underhåll egen drift kräver. Det är ofta där team i det tysta ger upp.
- [ ] Sätt upp en VPS för $5/månad hos den molnleverantör du föredrar
- [ ] Installera n8n med Docker Compose för separat orkestrering
- [ ] Anslut din primära databas med inloggningsuppgifter i n8n
- [ ] Skapa den första webhook-triggern för att ta emot leads
- [ ] Lägg till en Claude Code-nod som kvalificerar uppgifterna om leaden
- [ ] Skicka kvalificerade leads till ditt CRM-API
- [ ] Sätt upp arbetsflöden för felhantering när API-anrop misslyckas
- [ ] Övervaka körloggarna under de första 48 timmarna
Varför en ”gratis” automationsstack med öppen källkod kostar mer än du tror
Det låter som om programvara för noll kronor fungerar felfritt av sig själv. Vi vet hur det ser ut i verkligheten, särskilt när en konflikt mellan nodmoduler slår ut hela flödet klockan 2 på natten.
Kalkylen ser fantastisk ut i ett kalkylark. Men där syns varken utvecklarens helgarbete, besväret med versionshantering eller SSL-certifikat som verkar löpa ut vid sämsta tänkbara tillfälle. Driver du en automationsstack själv ansvarar du också för infrastrukturen.
Vi avråder inte från egen drift. Vi avråder däremot bestämt från att gå in i den utan att förstå vad den kräver. Du måste budgetera för utvecklartid, annars äts besparingarna upp av underhåll som inte syns i kalkylen.
Om din huvudansvariga utvecklare lägger 4 timmar i veckan på servern kostar din stack för $52 i själva verket $452 (räknat på $100 per timme, vilket är lågt för en kompetent DevOps-ingenjör). Räkna på den totala ägandekostnaden innan du lämnar SaaS. Det verkligt kostsamma är felsökningen.
En SaaS-plattform hanterar ändringar i API-anropsgränser åt dig. När Google ändrar strukturen i sitt API skickar Zapier ut en uppdatering som du inte ens märker.
Med egen drift går arbetsflödet i stället sönder klockan 2 på natten och utvecklaren som har jour måste gå upp och laga det. Väg flexibiliteten i öppen källkod mot den underhållsbördan. Bygg inte den här stacken om teamet saknar grundläggande DevOps-kunskaper.
Betala hellre för ett SaaS-abonnemang och sov hela natten.
Kostnadsminskningen på 19x gäller bara om infrastrukturen förblir stabil, och stabilitet uppstår inte av sig själv. Model Context Protocol är en öppen standard från Anthropic som anger hur en AI-assistent anropar externa verktyg och datakällor. Därmed kan språkmodeller hämta aktuella data i stället för att gissa, vilket motverkar påhittade svar.
Vi bygger MCP-servrar som ger våra agenter direkt åtkomst till verksamhetens databaser och externa API:er.
Steg 2: Använd Model Context Protocol för att hämta aktuella data
Model Context Protocol är en öppen standard som Anthropic har introducerat. Den anger hur en AI-assistent anropar externa verktyg och datakällor, så att språkmodeller kan hämta aktuella data i stället för att gissa. Vi bygger MCP-servrar som ger våra AI-agenter direkt åtkomst till verksamhetens databaser och externa API:er.
Det motverkar påhittade svar.
SEO-plattformar som Ahrefs och SEMrush erbjuder nu MCP-servrar. Det gör det möjligt för utvecklare att bygga automationsstackar där datakällor kan bytas ut. Din agent kan fråga efter aktuella sökresultat, sökvolymer och konkurrenters bakåtlänkar direkt.
Den behöver inte längre förlita sig på inaktuella träningsdata från 2024.
Ett komplett arbetsflöde för SEO-automatisering med AI och MCP består av 7 steg:
- Kvalificera sökord med aktuella sökvolymer från API:er
- Låt Claude klassificera sökfrågor efter sökintention
- Hämta konkurrenternas innehåll från de högst rankade sidorna
- Jämför din webbplats med konkurrenternas och hitta innehållsluckor
- Skapa en disposition utifrån de relevanta begrepp som saknas
- Låt Claude Code-agenten skriva ett utkast enligt dispositionen
- Kontrollera att fakta stämmer och att texten flyter bra
Protokollet förändrar hur du bygger mallar. Du behöver inte längre hårdkoda API-anrop i ditt n8n-arbetsflöde. I stället gör du API:et tillgängligt via en MCP-server och talar om för Claude Code vilka servrar som finns. Modellen avgör utifrån uppgiften när verktyget ska anropas.
Arkitekturen är mycket flexibel. Byter du från Ahrefs till SEMrush behöver du bara byta MCP-serverns slutpunkt. Logiken i arbetsflödet förblir densamma. AI-agenten anpassar automatiskt sina verktygsanrop. Resultatet är en modulär automationsstack som klarar leverantörsbyten.
Steg 3: Jämför den totala ägandekostnaden för SaaS och egen drift
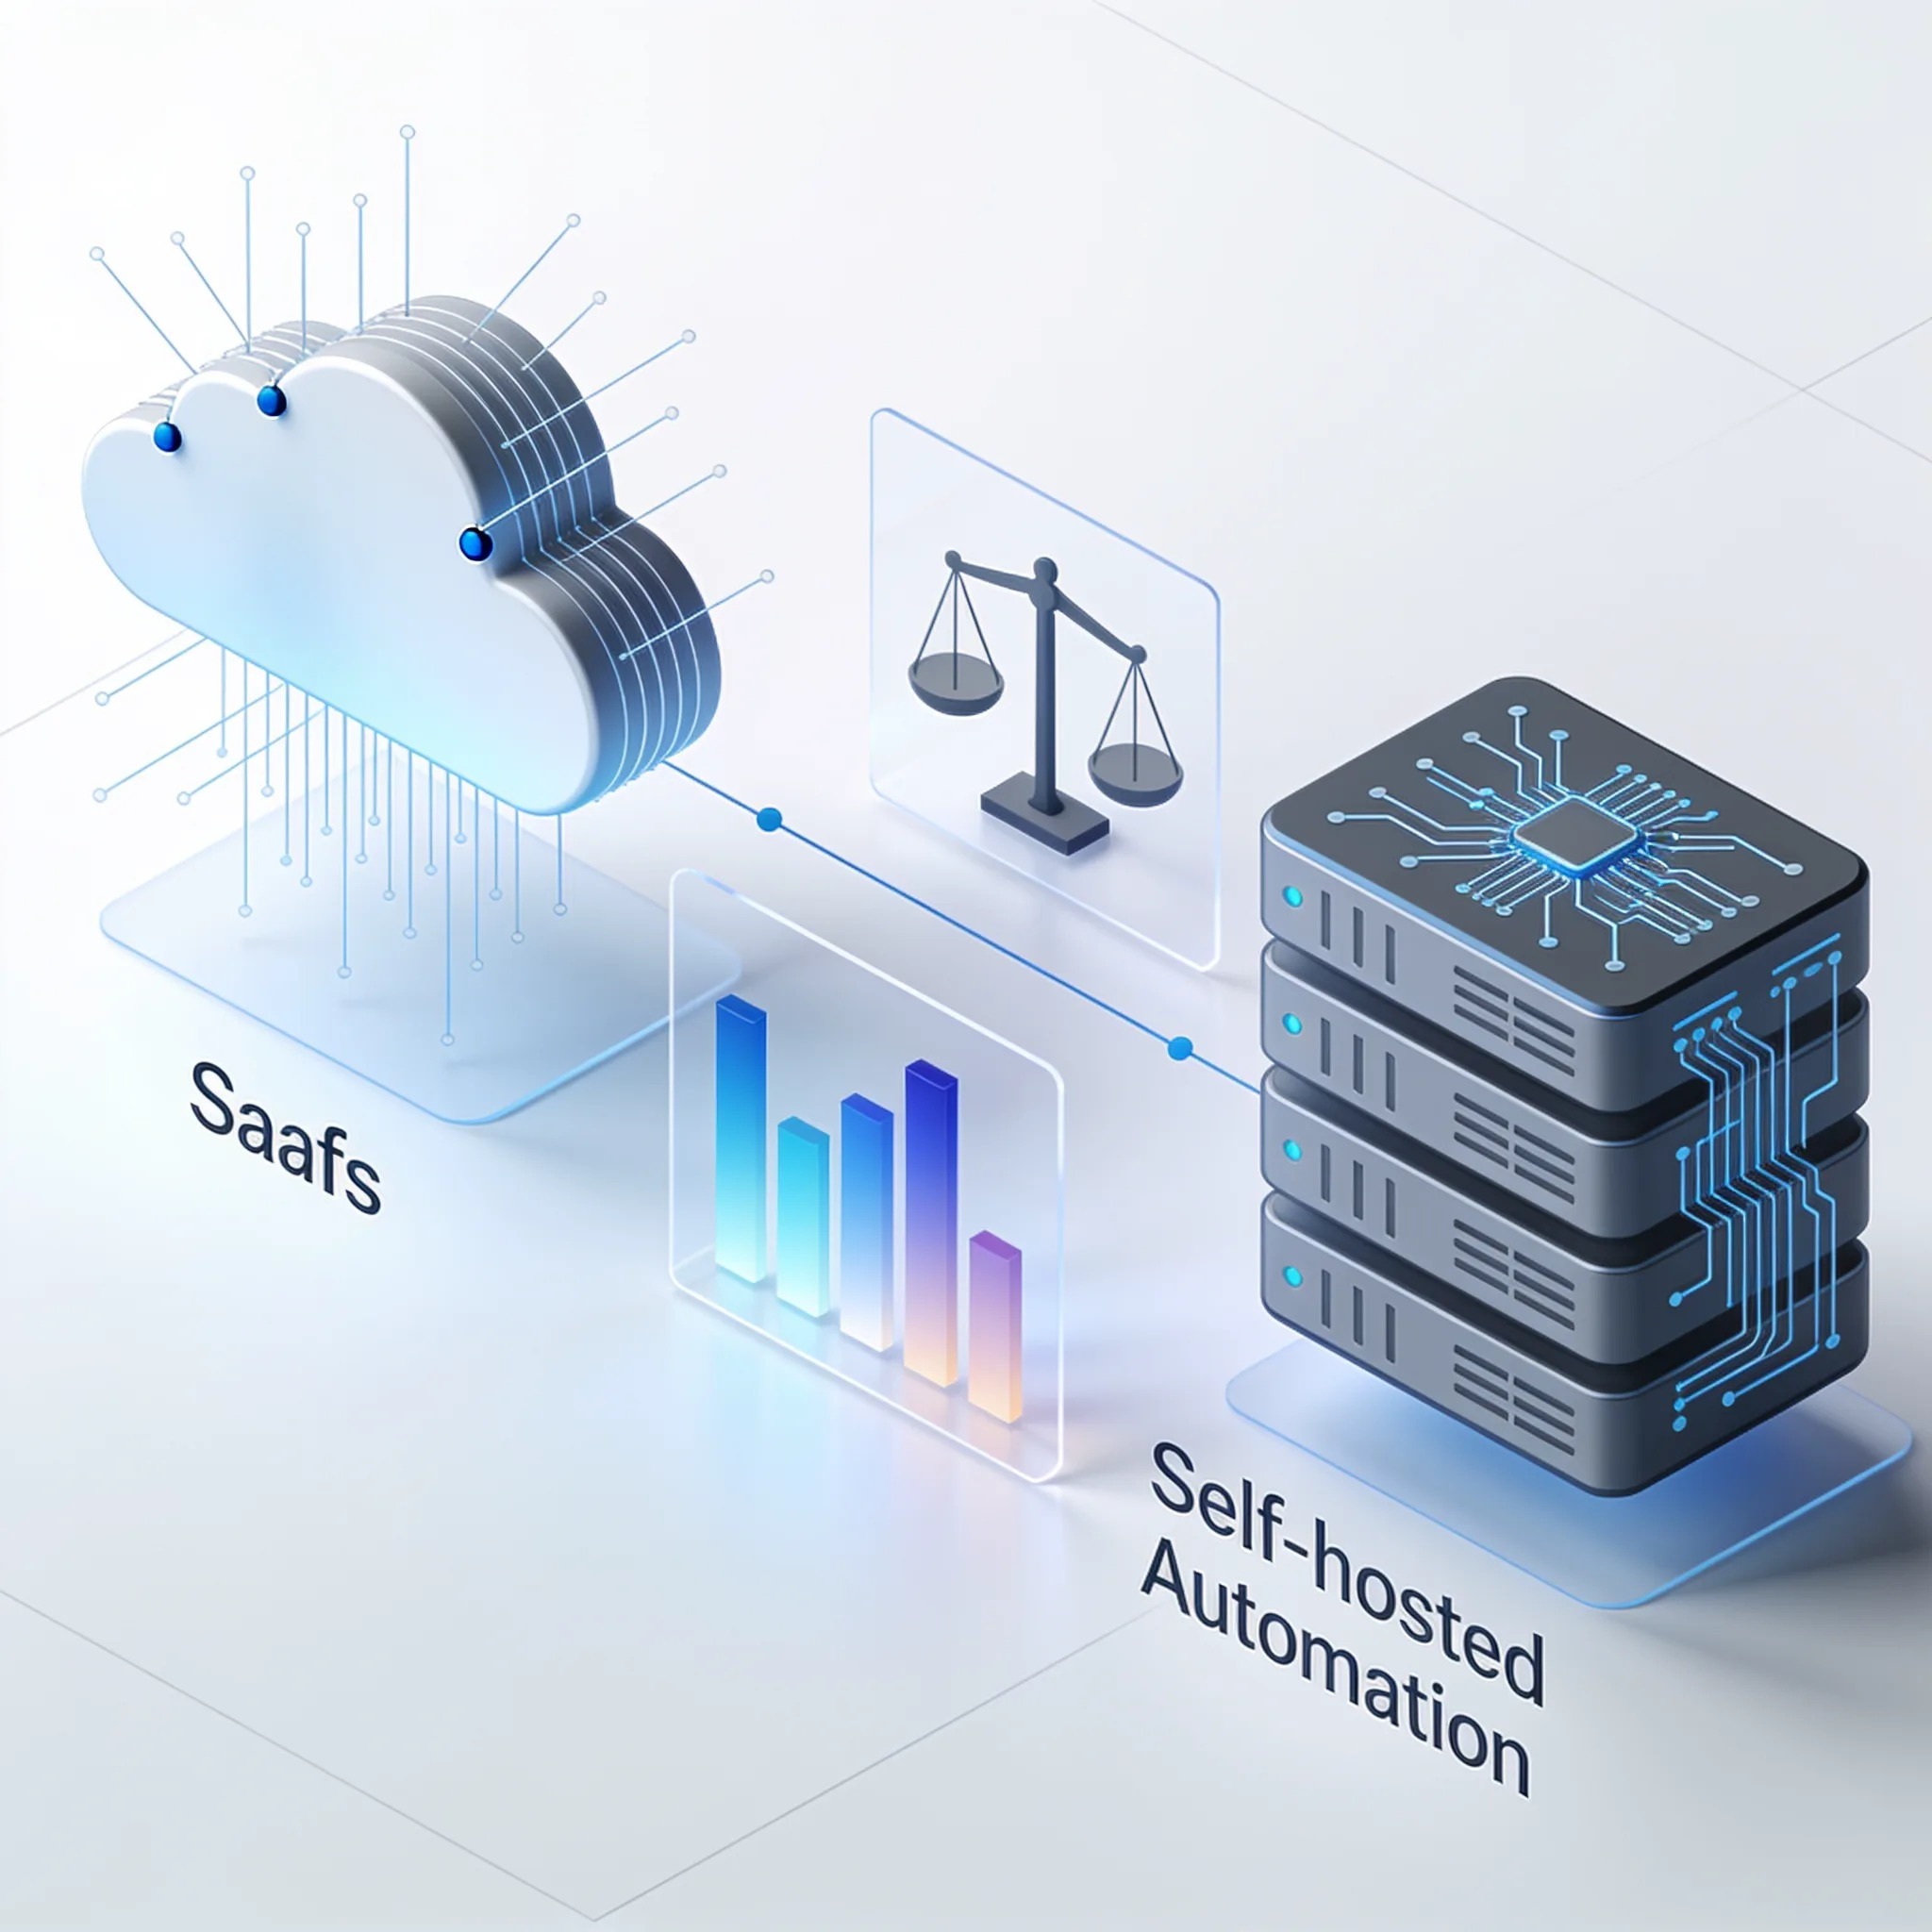
Öppen källkod har fördelar när du behöver skala upp och bygga egen logik. Vi hämtar sökresultatdata och webbplatsgranskningar via DataForSEO API (cirka $30/månad med betalning efter användning). Google Search Console API ger oss kostnadsfria förstapartsdata om sökplaceringar och klick, så att vi kan kontrollera resultaten från vår automationsstack.
Så här står sig en vanlig SaaS-stack mot vår lösning med egen drift:
För att förstå avkastningen kan du titta på den konkreta JSON-data som vårt n8n-arbetsflöde skickar till DataForSEO. Den ligger till grund för hela vårt flöde för sökordsanalys.
När du skalar upp blir besparingarna stora.
| Funktion | Vanlig SaaS-stack | n8n-stack med egen drift |
|---|---|---|
| Grundkostnad | $980 / månad | $52 / månad |
| Gränser för API-anrop | Strikta gränser per abonnemangsnivå | Styrs av din leverantör |
| Egen logik | Begränsad till enkla filter | Fullständig JavaScript / Python |
| Underhåll | Sköts av leverantören | Kräver egen DevOps-kompetens |
| Dataskydd | Data lagras på leverantörens servrar | Data lagras på din egen VPS |
För att driva en automationsstack i stor skala behöver du tydliga rutiner för API-anropsgränser, dataskydd och automatisk återställning.
{
 "version": "v3",
 "method": "KeywordsData/KnowledgeGraph/Search",
 "params": {
 "keyword": "automation stack",
 "depth": 10,
 "limit": 50
 }
}
API-anropsgränser som inte hanteras och API-anrop som löper ut utan felmeddelande kan få arbetsflöden att sluta fungera utan att någon märker det direkt. Bygg in nya försök, idempotens, varningar och hantering av meddelanden som inte kan behandlas. Dokumentera också hur systemet återställs.
Kalkylator för automationsstackens totala ägandekostnad
Jämför dina nuvarande SaaS-kostnader för verksamheten med kostnaden för en automationsstack i egen drift.
Steg 4: Hur hanterar du API-anropsgränser, säkerhet och återställning i stor skala?
Kvalitetskontroll i AI-automatisering måste omfatta kontroller där AI:n granskar genererade utkast efter påhittad statistik och citat som aldrig har uttalats. Varje påstående om data måste hänvisa till en verklig siffra som har hämtats in. Du kan inte lita på att modellen upptäcker sina egna fel, för det gör den inte.
Lägg därför in ett separat valideringssteg i arbetsflödet. Google Indexing API tar bara emot aviseringar för sidor med JobPosting eller BroadcastEvent inbäddat i ett VideoObject. Använd interna länkar och en webbplatskarta för vanliga sidor.
Inget av detta garanterar när sidorna genomsöks. Automatiseringen kan också sköta uppgifter i webbläsaren med verktyg som Claude Code och Playwright MCP Server. Då kan din agent även använda webbplatser som helt saknar publika API:er.
Säkra din lösning med följande rutiner. Hoppa inte över felkön, en så kallad Dead Letter Queue. Om ett arbetsflöde misslyckas klockan 2 på natten måste dess data sparas i en databastabell, så att ett separat arbetsflöde kan behandla dem varje morgon.
- Lagra alla API-nycklar i n8n:s krypterade lagring för autentiseringsuppgifter, aldrig som klartext i noder
- Konfigurera återförsök med exponentiell väntetid för varje nod som gör HTTP-anrop
- Låt känsliga kunduppgifter passera enbart genom privata delnät
- Skapa felköer för misslyckade körningar av arbetsflöden
- Granska agenternas instruktioner varje månad för att förebygga prompt injection-attacker
- Begränsa Playwright-agenter till godkända domäner
Utan detta riskerar du att förlora data permanent. Hur väl klarar din infrastruktur den här belastningen? Ta reda på var du står. För att skala upp innehållsproduktionen behöver du gå från manuellt skrivande till agentstyrda arbetsflöden med mallar.
Innan ett team byter till forskningsverktyg med öppen källkod bör det jämföra dem med hur teamet faktiskt använder Ahrefs, vilka krav det har på datakvalitet och support samt den totala driftskostnaden.
Driftsätt n8n och Claude Code för storskaliga innehållsflöden
Vi använder claude-seo, ett SEO-granskningsverktyg med öppen källkod som körs som en färdig funktion i Claude Code och gör 186 olika SEO-kontroller vid en enda granskning. Projektet har fått 2 974 stjärnor på GitHub. Inte illa för ett communityprojekt.
Det ersätter dyra månadsabonnemang och ger oss samtidigt mer detaljerad kontroll över varje kontroll via kod. Rankenstein är ett SEO-automatiseringssystem byggt på n8n som automatiserar SEO-arbetet hela vägen. Vi använder det tillsammans med claude-seo för att hantera innehållsflödet från sökord till publicering.
n8n-servern startar agenten i Claude Code, som söker i RAG-databasen efter möjligheter till internlänkning, skriver ett utkast, kör granskningen med claude-seo och publicerar sidan. Det är hela flödet.
Så här driftsätter vi det. Som Andrew Ng uttryckte det på Stanford GSB: ”AI är den nya elektriciteten.” Men elektricitet behöver ett elnät. Ditt arbetsflöde i n8n är det nätet: det för AI-modellens kraft vidare till verksamheten.
- Fyll RAG-vektordatabasen med företagets befintliga dokumentation
- Konfigurera Rankensteins n8n-mall med inloggningsuppgifterna till ditt CMS
- Installera claude-seo som en färdig funktion i din Claude Code-miljö
- Starta det första arbetsflödet för innehållsgenerering via en webhook
- Granska agentens SEO-rapport med 186 kontrollpunkter
- Godkänn utkastet för automatisk publicering i ditt CMS
- Avisera Google via Google Indexing API endast för berättigade jobbannonser eller sidor med livesändningar. Använd en webbplatskarta för vanliga sidor
Aktuella modeller från Claude, GPT, Gemini och Grok, upp till 75 % under listpris
En enda API-nyckel för modellerna Claude, GPT, Gemini och Grok via OpenAI SDK. Claude-modellerna fungerar även med Anthropic SDK och Claude Code.
Varje modells pris via AIGROW-kredit ligger bredvid tillverkarens listpris, aldrig över det.
Vanliga frågor
