Une stack d’automatisation évolutive ne se résume pas à un orchestrateur et à un modèle. Pour un premier workflow, définissez les files d’attente, les nouvelles tentatives, l’idempotence, les permissions, la surveillance, la maîtrise des coûts, les sauvegardes, les responsabilités et les procédures de reprise. L’auto-hébergement peut réduire les frais de licence tout en augmentant la charge d’ingénierie : comparez donc le coût total d’exploitation et la fiabilité avant d’ajouter des composants.
Vous développez avec des modèles d’IA ? Le crédit API AIGROW donne accès aux modèles Claude, GPT, Gemini, Grok, Qwen et Kimi jusqu’à 75 % sous le prix public.
- Une stack évolutive exige une attribution claire des responsabilités, des files d’attente, des nouvelles tentatives, une gestion de l’idempotence, une surveillance, une maîtrise des coûts et des procédures de reprise.
- L’auto-hébergement déplace les coûts vers l’infrastructure, les mises à jour, la sécurité, les sauvegardes et les astreintes. Intégrez ce travail à vos comparaisons.
- Commencez par un seul workflow et n’ajoutez des composants que s’ils lèvent une contrainte mesurée ou améliorent la fiabilité.
Étape 1 : comment concevoir une stack d’automatisation pour les opérations de l’entreprise ?
L’orchestration auto-hébergée impose de gérer la disponibilité, la sécurité, les mises à jour et la reprise après incident. Testez-la sur une charge représentative et relevez les événements perdus, les incidents et le temps de maintenance avant de la choisir.
Une stack associant n8n, Claude Code et DataForSEO peut gérer des audits SEO planifiés, des pipelines de suivi des positions, la publication de contenu et les contrôles de santé d’un site sans intervention manuelle. La même architecture s’applique aux opérations de l’entreprise. Vous récupérez un nouveau lead depuis votre site, le transmettez à Claude pour le qualifier, puis envoyez les données enrichies directement dans Salesforce.
Voici le flux que nous utilisons pour acheminer les données opérationnelles. Il prend en charge les ventes, l’onboarding des clients et le reporting interne sans surveillance permanente. Le serveur n8n sert de point central.
Il reçoit les déclencheurs de votre frontend ou de votre CRM.
Il appelle ensuite un agent Claude pour traiter ou mettre en forme les données reçues, puis dirige le résultat vers la bonne API. Pour construire ce système, respectez un ordre de mise en place précis. L’open source n’est pas gratuit : son coût prend une autre forme.
Méfiez-vous de ceux qui prétendent le contraire.
La concurrence met volontiers en avant les économies, mais passe sous silence la complexité de la mise en place et la maintenance des instances auto-hébergées. C’est souvent à ce stade que les équipes abandonnent discrètement.
- [ ] Mettre en place un VPS à $5/mois chez le fournisseur cloud de votre choix
- [ ] Installer n8n avec Docker Compose pour isoler l’orchestration
- [ ] Connecter votre base de données principale à n8n en tant qu’identifiant d’accès
- [ ] Créer un premier déclencheur webhook pour capter les leads entrants
- [ ] Ajouter un nœud Claude Code pour qualifier les données du lead
- [ ] Envoyer les leads qualifiés vers l’API de votre CRM
- [ ] Prévoir des workflows de secours en cas d’échec des appels API
- [ ] Surveiller les journaux d’exécution pendant les 48 premières heures
Pourquoi une stack d’automatisation open source « gratuite » coûte plus cher qu’on ne le pense
On vous présente un logiciel à zéro dollar qui tournerait sans problème, comme par magie. La réalité est moins séduisante quand, à 2 heures du matin, un conflit entre modules Node met tout votre pipeline à l’arrêt.
Sur un tableur, le calcul est impressionnant. Mais il ne tient compte ni des week-ends travaillés par votre ingénieur, ni des difficultés de gestion des versions, ni des certificats SSL qui semblent toujours expirer au pire moment. Si vous auto-hébergez une stack d’automatisation, l’infrastructure devient votre responsabilité.
Nous ne déconseillons pas l’auto-hébergement. Nous déconseillons de s’y lancer sans en mesurer les implications. Prévoyez du temps de développement dans votre budget, sous peine de voir la maintenance grignoter vos économies sans que cela apparaisse sur la facture.
Si votre ingénieur principal passe 4 heures par semaine à gérer le serveur, votre stack à $52 vous coûte en réalité $452 (sur la base de $100/heure, une estimation prudente pour un ingénieur DevOps compétent). Calculez le coût total de possession avant de quitter une solution SaaS. La complexité du débogage est le véritable piège.
Une plateforme SaaS gère pour vous les changements de limites de débit des API. Quand Google modifie le schéma de son API, Zapier déploie une mise à jour que vous ne remarquerez même pas.
Dans une stack auto-hébergée, le workflow tombe en panne à 2 heures du matin et le développeur d’astreinte doit se lever pour le réparer. Mettez la souplesse de l’open source en regard de cette charge de maintenance. Si votre équipe n’a pas les compétences DevOps de base, ne construisez pas cette stack.
Prenez plutôt un abonnement SaaS et dormez tranquille.
La réduction des coûts par 19 n’est réelle que si votre infrastructure reste stable. Et la stabilité ne tient pas aux bonnes intentions. Model Context Protocol est une norme ouverte d’Anthropic qui définit la manière dont un assistant IA appelle des outils et des sources de données externes.
Elle permet aux LLM de récupérer des données en temps réel au lieu de deviner, ce qui réduit les réponses inventées. Nous créons des serveurs MCP pour donner à nos agents un accès direct aux bases de données métier et aux API externes.
Étape 2 : utiliser Model Context Protocol pour accéder aux données en temps réel
Model Context Protocol est une norme ouverte introduite par Anthropic. Elle définit la manière dont un assistant IA appelle des outils et des sources de données externes, afin que les LLM puissent récupérer des données en temps réel au lieu de deviner. Nous mettons en place des serveurs MCP pour donner à nos agents IA un accès direct aux bases de données métier et aux API externes.
Cela réduit les réponses inventées.
Des plateformes SEO comme Ahrefs et SEMrush proposent désormais des serveurs MCP. Les développeurs peuvent ainsi intégrer à leurs stacks d’automatisation des sources de données interchangeables. Votre agent peut interroger directement les données SERP en temps réel, les volumes de recherche des mots-clés et les backlinks des concurrents.
Il n’est plus limité aux données d’entraînement de 2024.
Un pipeline complet d’automatisation SEO avec l’IA et MCP comporte 7 étapes :
- Qualifier les mots-clés à l’aide d’API de volumes de recherche en temps réel
- Classer les requêtes par intention de recherche avec Claude
- Extraire le contenu des pages concurrentes les mieux classées
- Repérer les sujets manquants en comparant votre site à ceux des concurrents
- Produire un plan à partir des entités sémantiques manquantes
- Rédiger un brouillon conforme au plan avec l’agent Claude Code
- Vérifier l’exactitude des faits et la fluidité du texte
Ce protocole change la façon de construire vos modèles de workflow. Au lieu d’inscrire les appels API directement dans votre workflow n8n, vous exposez l’API par l’intermédiaire d’un serveur MCP. Vous indiquez ensuite à Claude Code quels serveurs sont disponibles.
Le modèle décide quand appeler l’outil en fonction de la tâche demandée.
Cette architecture offre une grande souplesse. Si vous passez d’Ahrefs à SEMrush, il suffit de remplacer le point de terminaison du serveur MCP. La logique de votre workflow ne change pas.
L’agent IA adapte automatiquement ses appels aux outils. Votre stack d’automatisation reste ainsi modulaire même lorsque vous changez de fournisseur.
Étape 3 : comparer le coût total de possession des stacks SaaS et auto-hébergées
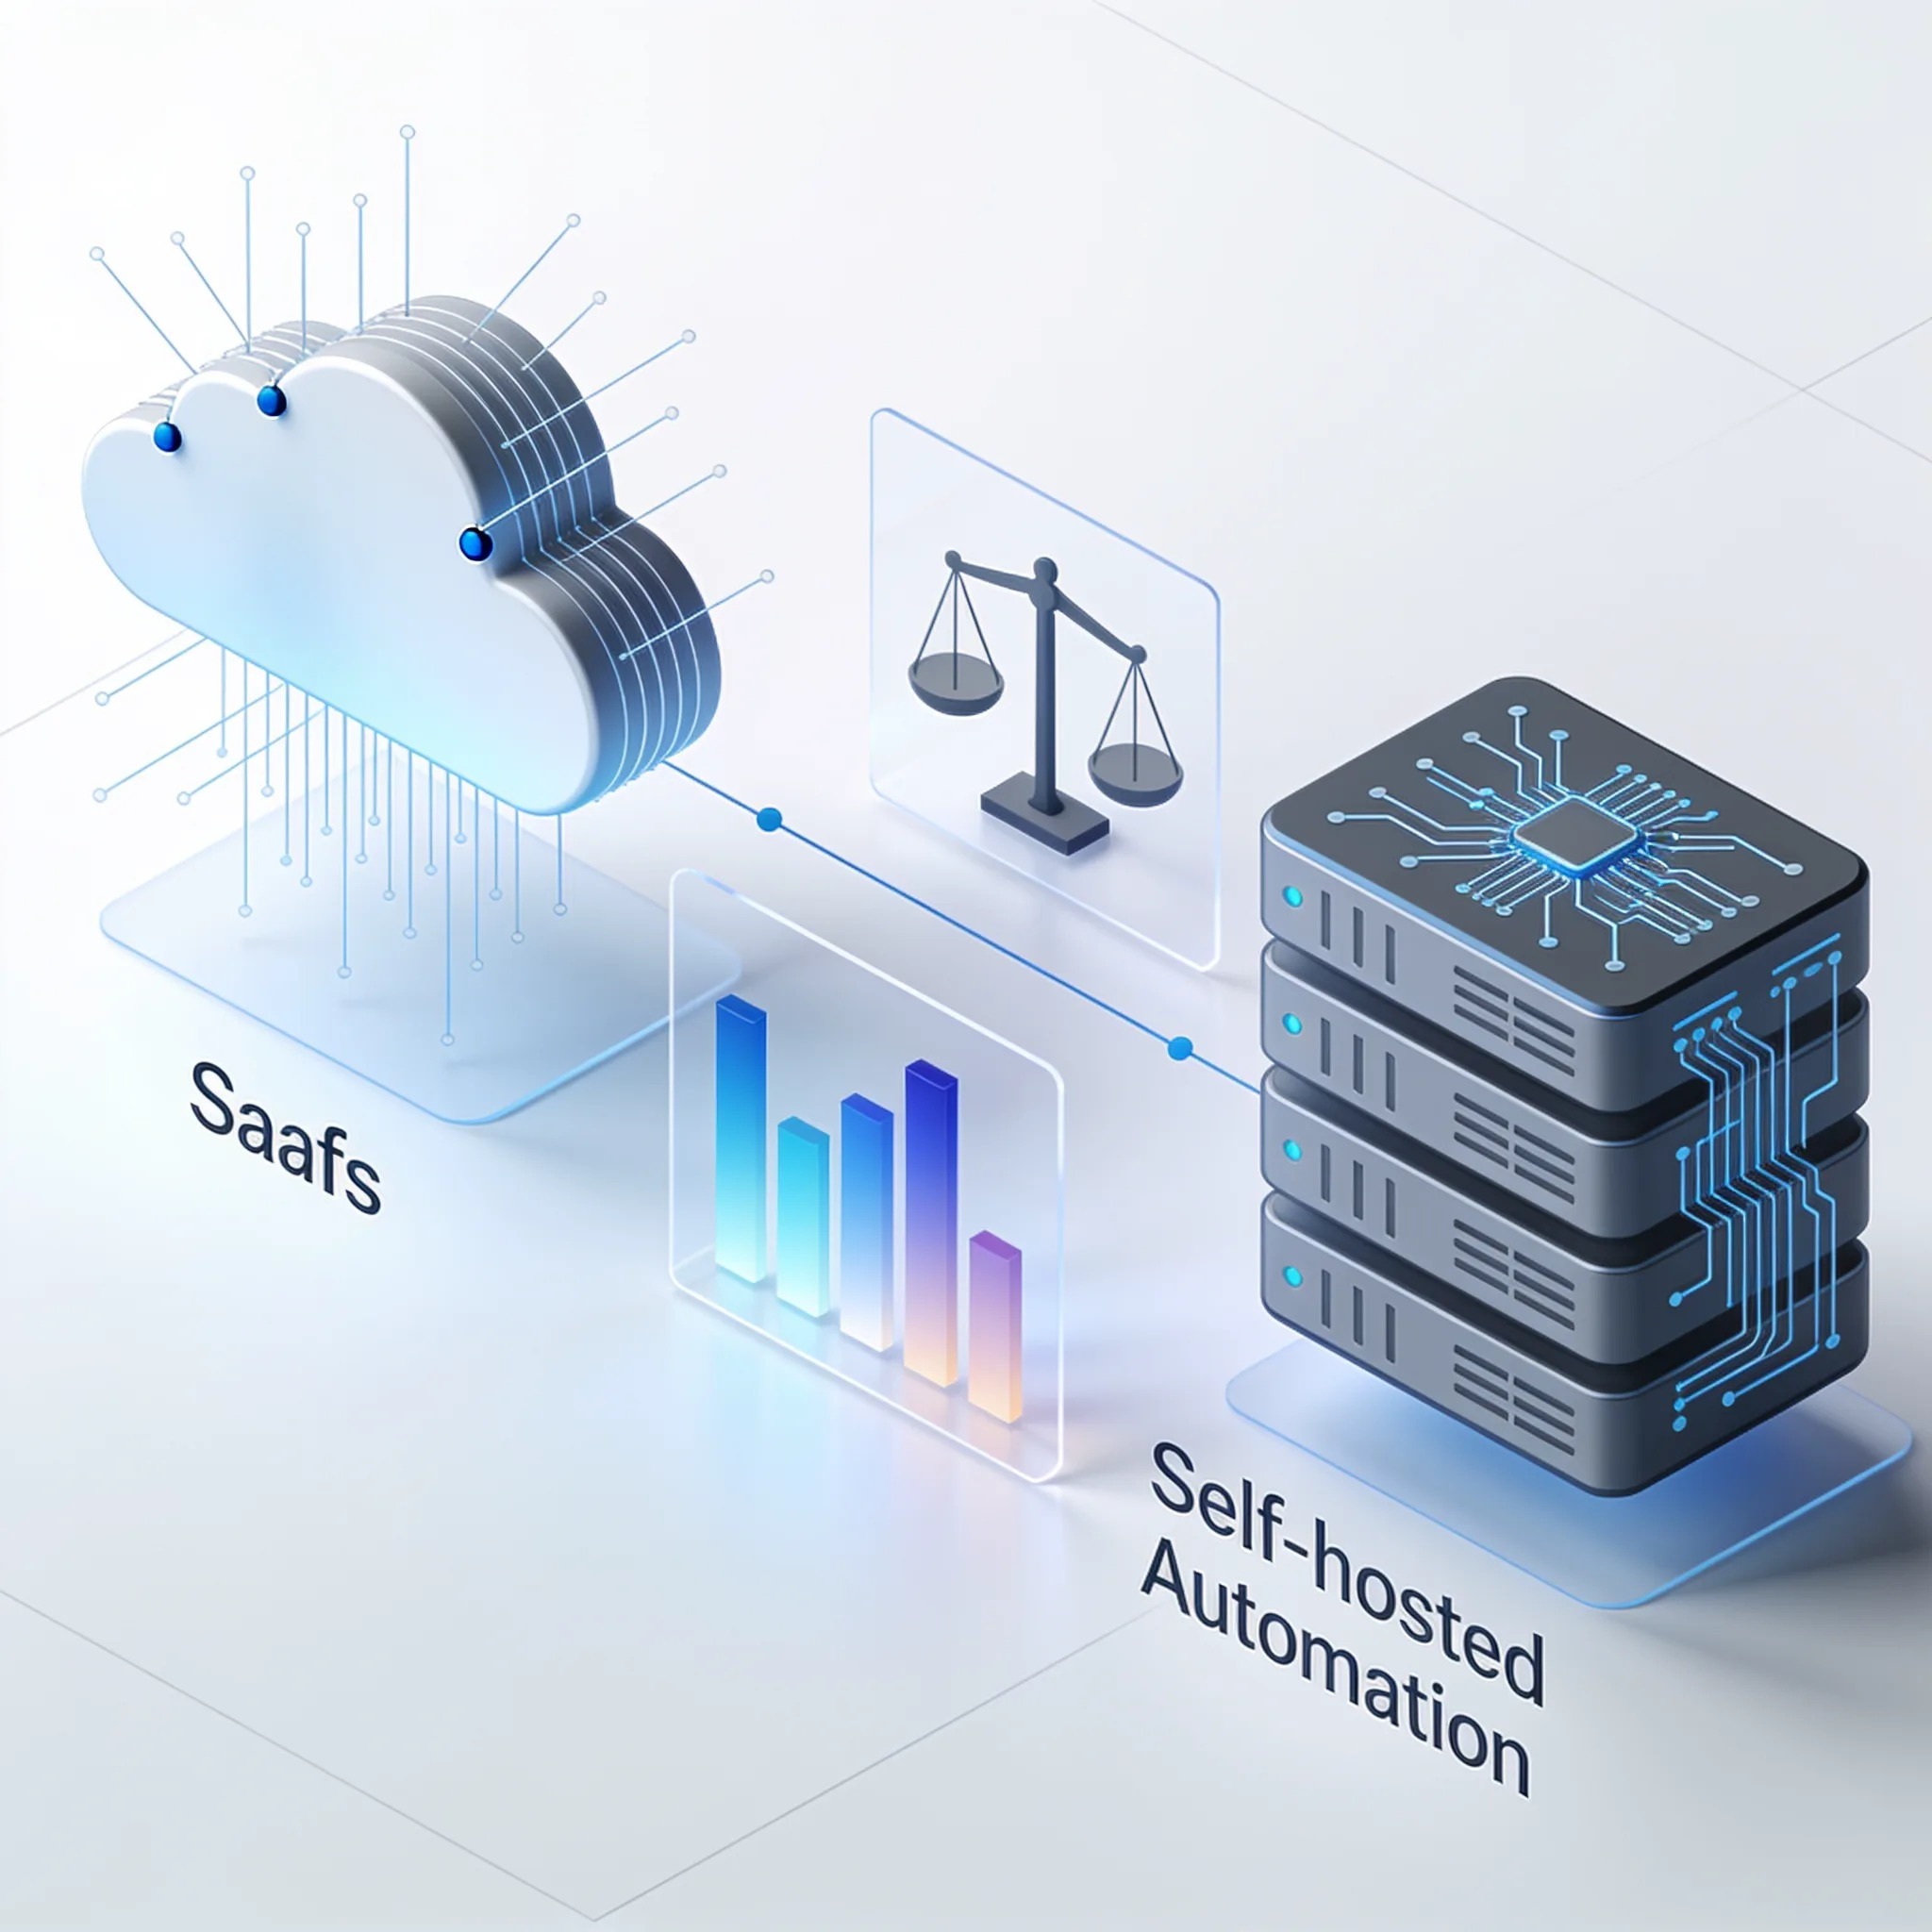
L’open source a l’avantage pour le passage à l’échelle et la logique personnalisée. Nous récupérons les données SERP et les audits de sites via l’API DataForSEO (environ $30/mois avec une facturation à l’usage). L’API Google Search Console nous fournit gratuitement des données de première main sur les positions et les clics pour valider les résultats de notre stack d’automatisation.
Voici comment une stack SaaS classique se compare à notre architecture auto-hébergée :
Pour comprendre le retour sur investissement, examinons les données JSON que notre workflow n8n envoie à DataForSEO. Elles alimentent l’ensemble de notre pipeline de recherche de mots-clés.
À grande échelle, les économies sont considérables.
| Fonctionnalité | Stack SaaS classique | Stack n8n auto-hébergée |
|---|---|---|
| Coût de base | $980 / mois | $52 / mois |
| Limites des appels API | Limites strictes selon la formule | Définies par votre fournisseur |
| Logique personnalisée | Limitée aux filtres simples | JavaScript / Python sans restriction |
| Maintenance | Assurée par le fournisseur | Nécessite des compétences DevOps en interne |
| Confidentialité des données | Hébergées sur les serveurs du fournisseur | Stockées sur votre propre VPS |
Gérer une stack d’automatisation à grande échelle exige des règles strictes pour les limites de débit des API, la confidentialité des données et la reprise automatisée.
{
 "version": "v3",
 "method": "KeywordsData/KnowledgeGraph/Search",
 "params": {
 "keyword": "automation stack",
 "depth": 10,
 "limit": 50
 }
}
Des limites de débit non gérées et des expirations silencieuses des appels API peuvent interrompre les workflows sans alerte immédiate. Prévoyez dans l’orchestration des nouvelles tentatives, l’idempotence, des alertes, une file d’attente pour les échecs définitifs et une procédure de reprise documentée.
Calculateur du coût total d’une stack d’automatisation
Comparez le coût actuel de vos opérations sur SaaS à celui d’une stack d’automatisation auto-hébergée.
Étape 4 : comment gérer les limites de débit des API, la sécurité et la reprise à grande échelle ?
Le contrôle qualité de vos systèmes d’automatisation par l’IA doit prévoir des consignes qui vérifient si les brouillons générés contiennent des statistiques inventées ou des citations fabriquées. Chaque affirmation chiffrée doit renvoyer à une donnée réelle récupérée auprès d’une source. Vous ne pouvez pas compter sur le modèle pour se contrôler lui-même : il ne le fera tout simplement pas.
Ajoutez un nœud de validation distinct à votre workflow pour détecter ces problèmes. L’Indexing API de Google n’accepte les notifications que pour les pages comportant un élément JobPosting ou BroadcastEvent intégré à un VideoObject. Pour les pages ordinaires, utilisez des liens internes et un sitemap ; aucun des deux ne garantit quand elles seront explorées.
Ces systèmes peuvent aussi automatiser des tâches dans le navigateur avec des outils comme Claude Code et Playwright MCP Server. Votre agent peut ainsi interagir avec des sites dépourvus d’API publique.
Pour sécuriser votre système, mettez en place les mesures suivantes. Ne négligez pas la Dead Letter Queue. Si un workflow échoue à 2 heures du matin, sa charge utile doit rester dans une table de base de données, où un autre workflow la traitera chaque matin.
- Stockez toutes les clés API dans le stockage chiffré des identifiants de n8n, jamais en texte brut dans les nœuds
- Configurez des tentatives avec un délai exponentiel pour chaque nœud de requête HTTP
- Faites transiter les données clients sensibles uniquement par des sous-réseaux privés
- Mettez en place des Dead Letter Queues pour les exécutions de workflows ayant échoué
- Auditez chaque mois les consignes des agents pour prévenir les attaques par injection de prompt
- Limitez les agents de navigation Playwright aux domaines autorisés
Sans ces mesures, vous risquez de perdre définitivement des données. Votre infrastructure est-elle prête à supporter une telle charge ? Évaluez sa capacité actuelle. Pour augmenter la production de contenu, il faut passer de la rédaction manuelle à une orchestration d’agents fondée sur des modèles.
Avant de changer d’outil, une équipe peut comparer les solutions de recherche open source à son utilisation réelle d’Ahrefs, à ses exigences de qualité des données et de support, ainsi qu’au coût total d’exploitation.
Déployer n8n et Claude Code pour des pipelines de production de contenu à grande échelle
Nous utilisons claude-seo, un outil open source d’audit SEO qui fonctionne comme une compétence de Claude Code et effectue 186 vérifications SEO en un seul audit. Le projet compte 2 974 étoiles sur GitHub. Pas mal pour un projet communautaire.
Il remplace des abonnements mensuels coûteux tout en nous donnant un contrôle programmatique plus poussé sur chaque vérification. Rankenstein est un système d’automatisation SEO basé sur n8n, conçu pour automatiser les processus SEO de bout en bout. Nous le déployons avec claude-seo pour gérer toute la chaîne de production de contenu, du mot-clé à la publication.
Le serveur n8n déclenche l’agent Claude Code, qui consulte la base de données RAG pour trouver des possibilités de maillage interne, rédige l’article, lance l’audit claude-seo et publie la page. Voilà l’ensemble du processus.
Voici notre séquence de déploiement. Comme l’a dit Andrew Ng à la Stanford GSB : « L’IA est la nouvelle électricité. » Mais l’électricité a besoin d’un réseau. Votre workflow n8n joue ce rôle : il met la puissance du modèle d’IA au service de vos opérations.
- Alimentez la base de données vectorielle RAG avec la documentation existante de l’entreprise
- Configurez le modèle n8n de Rankenstein avec les identifiants de votre CMS
- Installez la compétence claude-seo dans votre environnement Claude Code
- Déclenchez le premier workflow de génération de contenu par webhook
- Examinez le rapport d’audit SEO en 186 points produit par l’agent
- Approuvez le brouillon pour sa publication automatique dans votre CMS
- Notifiez Google au moyen de son Indexing API uniquement pour les pages d’offres d’emploi ou de diffusion en direct admissibles ; utilisez un sitemap pour les pages ordinaires
Les modèles actuels Claude, GPT, Gemini, Grok, Qwen et Kimi, jusqu’à 75 % sous le prix public
Une seule clé API pour les modèles Claude, GPT, Gemini, Grok, Qwen et Kimi via le SDK OpenAI. Les modèles Claude fonctionnent aussi avec le SDK Anthropic et Claude Code.
Le tarif de chaque modèle via le crédit AIGROW figure à côté du prix public de son éditeur, jamais au-dessus.
Questions fréquentes
