AI fungerer i store virksomheder, når isolerede modeller erstattes af orkestrerede arbejdsgange, hvor et menneske stadig er med i processen. Udført korrekt reducerer orkestrering procestiden med 43% og fejlprocenten med 90%. Denne guide gennemgår arkitekturen, de sikkerhedsforanstaltninger, der holder den under kontrol, og hvordan I måler, om løsningen kan skaleres.
Bygger du med AI-modeller? AIGROW API-kredit kører Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listeprisen.
- Orkestrering hjælper, når en arbejdsgang har tilstande, afhængigheder, nye forsøg og trin med klart ansvar. Den skaber også nye fejlmuligheder, som skal testes.
- Vælg det enkleste mønster til koordinering, der kan håndtere processen, og tilføj grænser for antal trin, tidsfrister, ansvarsfordeling og eskalering.
- Fastlæg grænserne for gennemgang ud fra evalueringsresultater og forretningsrisiko i stedet for at kopiere en generisk sikkerhedsscore.
- Mål fuldført arbejde, rettelsesrate, genopretningstid, samlede omkostninger og hændelser ud fra faste definitioner.
Introduktion: Skiftet til orkestrering af AI-arbejdsgange
Markedet har ændret sig fuldstændigt. Automatisering er nu det normale: 66% af organisationerne har taget en form for automatisering af arbejdsgange i brug. Udviklingen er ikke til at overse.
Moderne referencearkitekturer kombinerer AI-agenter, hændelsesstyrede pipelines og kvalitetskontrol med mennesker i processen for at håndtere komplekse driftsopgaver. Branchen har helt forladt statisk RPA. Dynamisk AI-automatisering behandler information langt hurtigere og tilpasser sig særtilfælde, som ville få ældre scripts til at bryde sammen.
Statiske regler hører fortiden til. Det kræver stor driftsmæssig disciplin at bruge de rette teknikker til optimering af AI-automatiserede arbejdsgange, så den dynamiske behandling forbliver meget præcis på tværs af store virksomheders forskelligartede og uforudsigelige datasæt.
Brug denne tjekliste til at komme i gang:
- [ ] Kortlæg udgangspunktet for den nuværende proces
- [ ] Fastlæg mål for grænserne for undtagelser
- [ ] Vælg et framework til orkestrering
- [ ] Konfigurér hændelsesstyrede triggere
- [ ] Sæt den første løsning i produktion
Orkestrering af arbejdsgange er systematisk koordinering af AI-agenter og menneskelig kvalitetskontrol
Orkestrering af arbejdsgange koordinerer agenter, hændelsestriggere, deterministiske tjenester og menneskelig gennemgang gennem en proces. Vurdér den på fuldført arbejde, rettelsesrate, genopretningstid, driftsomkostninger og hændelser ud fra definitioner, som driftsteamet kan stå inde for.
Orkestrering er nyttig, når en arbejdsgang har afhængigheder, nye forsøg, tilstande og flere trin med klart ansvar. Test uventede input og utilgængelige tjenester for at se, om koordineringen forbedrer genopretningen eller blot øger kompleksiteten.
Her er der brug for struktur. Frameworket LangChain beskriver fem fremherskende mønstre for orkestrering af flere agenter, som i dag bruges i produktionsmiljøer til at håndtere komplekse og kritiske driftsopgaver: * Router: En central agent sender opgaver videre til specialiserede underagenter ud fra hensigten. * Supervisor: En hierarkisk model, hvor en overordnet agent fordeler opgaver og validerer resultater.
* Network: Agenter kommunikerer indbyrdes og fordeler opgaver dynamisk. * Hierarchical: Fordeling i flere niveauer, hvor ledende agenter giver opgaver til udførende agenter og derefter samler resultaterne. * Custom/Graph: Arbejdsgange som tilstandsmaskiner, der fastlægger den præcise overgangslogik mellem agenter.
I et netværksmønster kan agenter ende i en løkke, hvor de sender den samme opgave frem og tilbage. Forebyg det med en grænse for antal trin, registrering af dublerede opgaver, regler for ansvar, tidsfrister og en vej til eskalering. Test sikkerhedsforanstaltningerne ved fremprovokerede fejl, før løsningen sættes i produktion.
Et hierarkisk mønster kan understøtte en kompleks arbejdsgang som kreditvurdering af låneansøgninger, hvor udførende agenter indsamler dokumentation, og en overordnet komponent samler resultaterne. I et tænkt fejlscenarie modtager den overordnede komponent modstridende oplysninger om kredit og indkomst, men har ingen deterministisk regel for afklaring eller eskalering. Test modstridende oplysninger, manglende dokumenter, tidsfrister og afviste handlinger, før mønsteret bruges til faktiske beslutninger.
Da to udførende agenter returnerede modstridende forhold mellem gæld og indkomst, brugte den overordnede komponent 45 sekunder på at gennemgå uoverensstemmelsen. Svartiden steg dermed fra de forventede 2 sekunder til et helt uacceptabelt niveau. Det kan virke oplagt at vælge det mest avancerede mønster, men den skjulte pris er, at kompleksiteten gør fejlfinding eksponentielt sværere.
Vi anbefaler kraftigt at begynde med Supervisor-mønsteret. Det giver kontrolleret opgavefordeling uden Network-mønsterets risiko for uendelige løkker.
Vi integrerer mønstrene direkte med hændelsesstyret arkitektur. Pålidelig værktøjslogik kræver, at I forbinder jeres framework til orkestrering med de webhooktriggere, som starter og overvåger hver enkelt automatiseret arbejdsgang. Her er det standardformat for payloads, vi bruger til at starte en orkestreret arbejdsgang.
Det fungerer upåklageligt. Når I standardiserer JSON-strukturen på tværs af alle jeres pipelines, mindsker I integrationsbesværet markant og gør det væsentligt lettere for jeres udviklingsteams at finde fejl.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Denne JSON-struktur sikrer, at AI-motoren modtager både opgaven og de nødvendige styringsparametre. Hvis sikkerheden falder under 0.85, sender systemet opgaven til menneskelig gennemgang. Det sikrer kvalitetskontrol uden at blokere hele pipelinen.
Dermed kan arbejdet fortsætte, mens jeres driftsmæssige rammer håndhæves strengt. De rette teknikker til optimering af AI-automatiserede arbejdsgange sikrer, at jeres dyreste medarbejderressourcer udelukkende bruges på reelle særtilfælde med stor betydning frem for rutinemæssig dataudtrækning.
Vi hører ofte indvendingen: Driftsteams mener, at orkestrering giver uacceptabel forsinkelse i deres kritiske pipelines til transaktionsbehandling. Men det er en myte. Korrekt konfigurerede hændelsesstyrede pipelines reducerer faktisk den samlede procestid ved at fjerne manuelle overdragelser og unødvendige mellemtrin i hele processen.
Trin 1: Design eskaleringslogik med menneskelig gennemgang i hændelsesstyrede pipelines
Når I designer logik for eskalering til mennesker (HITL), skal klare grænser for sikkerhed knyttes til bestemte niveauer af gennemgang. Dette trin kan ikke springes over. Den økonomiske gevinst er betydelig.
Fastlæg, hvor automatiseringen stopper, og den menneskelige gennemgang begynder. Grænserne bør afspejle handlingens risiko, muligheden for at fortryde den, sikkerheden i resultatet og lovkrav. Validér dem derefter med repræsentative fejlscenarier.
- Niveau 1: Automatisk udførelse. Sikkerhed > 95%. Ingen menneskelig gennemgang.
- Niveau 2: Stikprøvekontrol. Sikkerhed 80 til 95%. Tilfældig kontrol af 10%.
- Niveau 3: Obligatorisk gennemgang. Sikkerhed < 80%. Alle opgaver sendes til menneskelig gennemgang.
Det er en alvorlig fejl udelukkende at bruge en LLM's rå output til at fastlægge disse grænser. Modeller er dårligt kalibrerede. En LLM kan angive 99% sikkerhed for et ondsindet prompt injection-angreb skjult i en uploadet kontrakt.
Dermed kan opgaven helt omgå køen til menneskelig gennemgang og forårsage alvorlig skade. Løsningen er at indføre kontrol af svarenes indbyrdes konsistens. Generér tre svar på det samme input.
Hvis to stemmer overens, er sikkerheden høj. Hvis alle tre er forskellige, skal opgaven eskaleres til niveau 3 uanset modellens egen score.
Forestil jer en hypotetisk pipeline til behandling af erstatningskrav, hvor manipulerede input får sikkerhedsscoren til at stige. Deterministisk validering, grænser for udbetalinger, registrering af afvigelser og menneskelig godkendelse af handlinger med høj risiko bør forhindre systemet i at behandle en stor gruppe krav automatisk. Test disse sikkerhedsforanstaltninger med syntetiske tilfælde, før I behandler reelle krav.
Hvis systemet udtrækker et beløb i dollar, kontrollerer en regel, at beløbet ligger inden for historiske grænser. Antallet af sager, menneskelige kontrollører kan håndtere, er også begrænset. Vi opretter derfor et system med dynamiske grænser.
Hvis ventetiden i køen til menneskelig gennemgang overstiger 4 timer, hæver systemet midlertidigt grænsen for automatisk udførelse til 97% og sætter stikprøvekontrollen på niveau 2 på pause. Det forebygger en flaskehals, hvor kontrollørerne drukner i eskalerede sager med ringe betydning.
Integration i hændelsesstyret arkitektur bruger Apache Kafka og Google Cloud PubSub som beskedformidlere. Dem bruger vi meget. Når et dokument kommer ind i pipelinen, publicerer Kafka hændelsen.
AI-motoren til orkestrering modtager hændelsen, behandler payloaden og publicerer resultatet. Fordelingen sker automatisk. Hvis sikkerheden er lav, sender systemet payloaden direkte til PubSub, så den straks kan gennemgås af et menneske.
Forretningsbrugere starter disse AI-arbejdsgange via no-code- og low-code-platforme. Det er meget enkelt. En bruger uploader en kontrakt i en portal, og platformen sender en webhook til backend.
Orkestreringsmotoren udtrækker klausuler, sammenligner dem med standarderne og returnerer en samlet risikoscore. Teknologien bliver dermed anvendelig i praksis. Når den underliggende API-kompleksitet skjules, kan teams uden teknisk baggrund udføre avancerede risikoanalyser uden at skrive en eneste linje kode.
Trin 2: Beregn afkastet, og sammenlign omkostningsbesparelser fra pilotprojekt til produktion
Det er et markant afkast. Mål gennemløbstid, arbejdskraft, omkostninger til rettelser, modelforbrug, gennemgangstid og hændelser ud fra definitioner, som økonomi- og driftsteamene kan tilslutte sig. Beregning af ROI er en central del af god optimering af AI-automatiserede arbejdsgange.
Det er her, vellykkede implementeringer adskiller sig fra dyre eksperimenter.
Brug tabellen til at sammenligne omkostningsbesparelser:
| Anvendelse | Manuel omkostning | Omkostning ved AI-orkestrering | Besparelse | Færre fejl |
|---|---|---|---|---|
| Fakturabehandling | $3.70 / dokument | $1.20 / dokument | 67,6% | en betydelig procentdel |
| Kontraktgennemgang | $52.00 / kontrakt | $18.50 / kontrakt | 64,4% | 85% |
Se på et regneeksempel med fakturabehandling i stor skala. Antag en mængde på 50.000 fakturaer. Den manuelle omkostning er enkel: 50.000 ganget med $3.70 giver $185,000 om måneden.
De automatiserede omkostninger består af flere dele. Gang 50.000 med $1.20 for beregning og menneskelig gennemgang. Det giver $60,000.
Læg derefter $5,000 til for API-tokens og $2,000 for hosting. Det samlede regnestykke giver en automatiseret omkostning på $67,000 om måneden. Dermed sparer du $118,000 om måneden og $1,416,000 om året.
Beløbene er store, og eksemplet står ikke alene. Når du bruger disse metoder til optimering på tværs af en stor virksomhed, kan de samlede økonomiske effekter ændre driftsomkostningernes struktur markant til det bedre.
ROI-beregner til AI-arbejdsgange
Beregn din månedlige besparelse ved AI-automatiseret fakturabehandling.
Den oversete pointe: Hvorfor mislykkes 41% af virksomheders AI-orkestreringsprojekter?
AI-orkestreringsprojekter i virksomheder mislykkes, fordi organisationer forsøger at automatisere processer, der ikke fungerer, uden først at fastlægge et sammenligningsgrundlag eller ændre arbejdsgangene. Det er en grundlæggende fejl. Hele 41% af virksomheders AI-orkestreringsprojekter når ikke deres erklærede forretningsmål inden for den oprindelige tidsplan og det oprindelige budget på grund af forkert procesvalg og undervurderet integrationsarbejde.
Det ser vi igen og igen. Springer du arbejdet med at ændre processerne over, får dine dyre nye AI-værktøjer blot de eksisterende ineffektive arbejdsgange til at køre hurtigere.
AI-automatisering kan give troværdige forbedringer i den enkelte arbejdsgang. Men ROI på tværs af virksomheden afhænger af et målt udgangspunkt, ændrede arbejdsgange, ibrugtagning, styring og stram omkostningskontrol. Dårlige processer bliver ikke gode af at blive automatiseret.
Forsøger du at automatisere en proces, der ikke fungerer, får du den blot til at fejle hurtigere, mens du bruger dyre beregningsressourcer. Derfor sætter vi ikke agenter i drift på ustabile arbejdsgange, før kunden har kortlagt den nuværende proces og ændret de nødvendige driftstrin, så arbejdet faktisk bliver mere effektivt.
Hvis en proces har en undtagelsesrate på over 8%, skal du ikke automatisere den endnu. Ændr processen først. Teams vælger ofte opgaver med stor variation, så AI konstant må sende dem videre til menneskelige medarbejdere, der allerede har travlt.
Det er den forkerte tilgang. God optimering af AI-automatiserede arbejdsgange kræver, at du accepterer, at ikke alt skal i produktion med det samme, uanset hvad ledelsen kræver.
Årsagen kan forklares med enkel matematik. Når undtagelsesraten er høj, ender orkestreringssystemet med primært at sende opgaver videre til mennesker. Du betaler for det hele: API-tokens, beregningstid og køhåndtering for hver eneste transaktion i systemet.
Hvis AI forsøger at behandle en kompleks erstatningssag, mislykkes og sender den videre til et menneske, bliver den samlede behandlingstid væsentligt længere, end hvis medarbejderen havde håndteret sagen fra begyndelsen.
Vi vurderede en logistikvirksomhed på Fortune 500-listen, som forsøgte at automatisere afgørelser i sager om fragterstatning. De valgte opgaven, fordi værdien pr. transaktion var høj.
Men høj værdi hænger ofte sammen med stor variation. Den faktiske undtagelsesrate var 22%. Hvert fragtfirma brugte sine egne dokumentationsformater, og uoverskuelige indsendelser via e-mail forvirrede modellen.
AI brugte tokens på at forsøge at læse ustrukturerede e-mailtråde, mislykkedes og sendte sagerne videre. Det var dyrt. Det mislykkede AI-forsøg lagde 3 minutter til hver sag og kostede virksomheden $1.2M i ekstra driftsforsinkelser på seks måneder.
General Motors trak sig tilsvarende fra et fuldautomatisk projekt til styring af forsyningskæden i 2023. De opdagede, at variationen i leverandørernes dataformater fik undtagelserne op over 30%. Derfor gik de tilbage til et regelbaseret system med AI som hjælpelag til de uforudsigelige særtilfælde.
Teams vælger komplekse processer med høj værdi, fordi beregningerne i regnearket ser lovende ud. Modstå fristelsen. Begynd med kedelige, gentagne processer, så du kan opbygge driftserfaring og teknisk stabilitet, før du tager fat på opgaverne med stor variation.
Vi bruger denne tjekliste for at undgå de faldgruber. Kontrollér, at processens undtagelsesrate er under 8%, før du skriver en eneste linje kode. - [ ] Kontrollér, at processens undtagelsesrate er under 8% - [ ] Fastlæg udgangsniveauet for omkostninger og gennemløbstid - [ ] Kortlæg integrationspunkter med ældre systemer - [ ] Få interessenternes opbakning til at ændre arbejdsgangen Det er et ufravigeligt krav for os.
Springer du disse grundlæggende trin over, sætter du et system i drift, som bruger penge og frustrerer driftsteamet.
Lader du hypen styre din implementering? Lad være. Vælg de rigtige opgaver, mål udgangspunktet, og ændr arbejdsgangen, før du overhovedet overvejer automatisering. Først derefter automatiserer du.
Hvordan overvåger du modeldrift og integrerer AI-systemer med ældre mainframes?
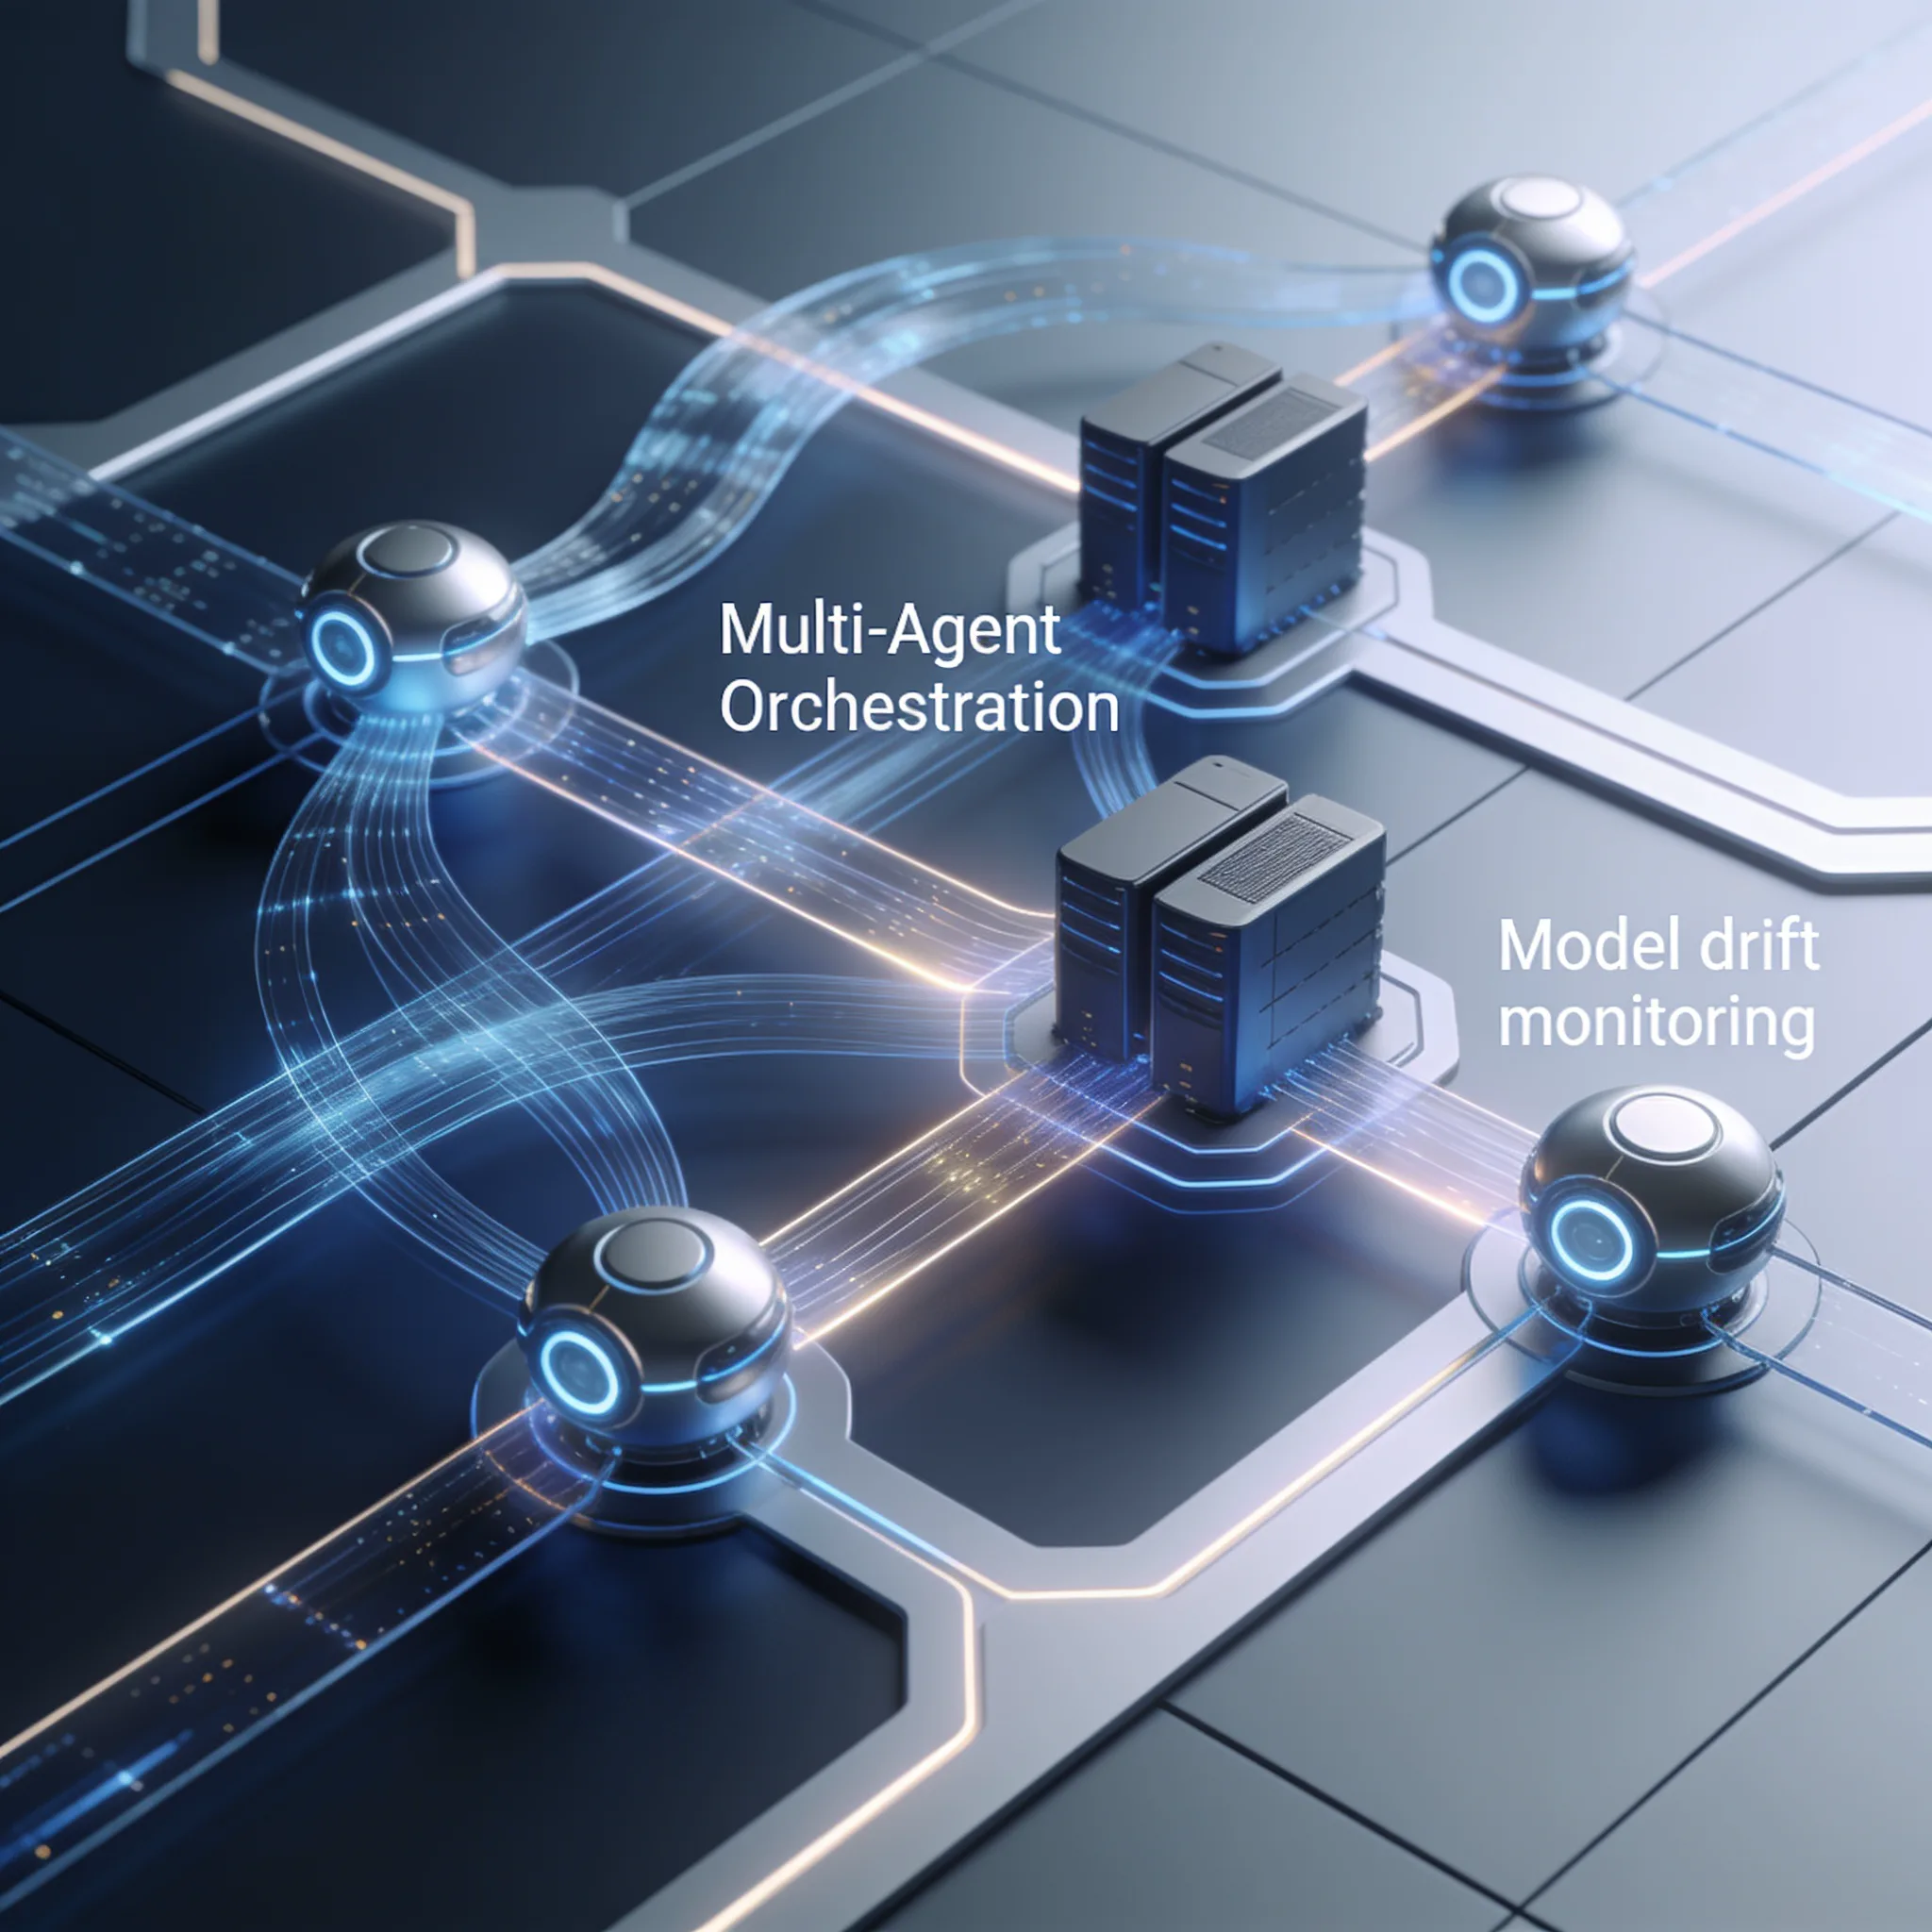
Du overvåger modeldrift ved at etablere datasæt med korrekte referenceværdier og følge fordelingen af konfidensscorer over tid. AI-systemer integreres med ældre mainframes via API-gateways og middleware, der oversætter moderne JSON-data til de formater, ældre terminaler bruger. Følg modeldrift og serviceniveauer ved hjælp af loggede modelresultater, prøver med korrekte referenceværdier og alarmer, som en navngiven ansvarlig reagerer på.
SLA-overvågning i realtid kræver, at du logger svartiden for alle modelkørsler og får besked, når grænseværdier overskrides. Avanceret optimering af AI-automatiserede arbejdsgange kræver løbende, grundig overvågning af både systemet og modellerne.
Modeldrift kan hurtigt forringe nøjagtigheden. Du skal løbende overvåge fordelingen af inputdata og konfidensintervallerne for output. Hvis en agent pludselig angiver 40% sikkerhed for en opgave, den normalt løser med 95%, skal du reagere med det samme.
Det er et tydeligt advarselssignal. Ignorerer du sådanne statistiske ændringer, risikerer din automatiserede proces gradvist at sende overbevisende, men forkerte AI-svar videre i systemet og ødelægge brugernes tillid.
Integration med ældre mainframes er en betydelig teknisk udfordring, men den kan løses. Brug et middlewarelag som bro mellem moderne AI-orkestrering og ældre systemer, der ikke kan behandle moderne JSON-data. Arkitekturen er afgørende.
Med et velfungerende oversættelseslag kan dine AI-agenter hente kontekst og skrive opdateringer uden at ændre kernen i det ældre system.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Denne YAML-konfiguration oversætter moderne API-data til formater, som mainframen kan læse. Den gør kommunikationen mellem systemerne mulig. AI-agenten kan hente kontekst og skrive opdateringer uden at ændre kernen i det ældre system.
Det er en stor driftsmæssig fordel. Du undgår risikoen og udgiften ved at røre ved skrøbelig, årtier gammel COBOL-kode, som dine vigtigste banksystemer kører på.
En ændret fakturaskabelon kan give modellen en fortsat høj score, selv om en værdi havner i det forkerte felt. Overvåg nøjagtigheden for hvert felt ved hjælp af gennemgåede stikprøver, opdag ændringer i fordelingen af inputdata, og stop behandlingen, når valideringen fejler.
Mainframe-integration indebærer særlige datarisici. Konvertering af COBOLs pakkede decimaltal til JSON-værdier med flydende komma kan indføre afrundingsfejl, som hober sig op på tværs af mange transaktioner. Bevar decimaltyperne, afstem totalerne, og kør den eksisterende beregning parallelt som kontrol, før du behandler finansielle data i drift.
Opgør eventuelle afvigelser på grundlag af gennemgåede produktionsdata frem for et opdigtet tabstal.
For at undgå dette skal du indføre et middlewarelag, der bevarer decimaltyperne strengt. Parallelle testkørsler er nødvendige. Send 5% af den faktiske trafik gennem den opdaterede model, sammenlign dens resultater med det ældre system, og log afvigelserne.
Vent derefter. Lad først modellen håndtere hovedparten af trafikken, når fejlraten er under 0,5%, og systemet har vist sig stabilt.
Følg serviceniveauer med klare definitioner, logning og en ansvarlig for forringet ydelse. Eksterne eksempler på produktivitetsgevinster siger ikke noget sikkert om, hvad en anden arbejdsgang kan opnå.
Trin 3: Hvilke arbejdsgange egner sig bedst til automatisering i produktion?
De arbejdsgange, der egner sig bedst til automatisering i produktion, har stor volumen, få undtagelser, forudsigelige trin og klare veje til at sende opgaver videre til mennesker. Det gælder for eksempel fakturabehandling, videresendelse af kundehenvendelser og kontraktanalyse. Vi vælger kun opgaver, der opfylder de kriterier.
Det giver en klar fordel. Valg af anvendelse er det sidste trin i god optimering af AI-automatiserede arbejdsgange og er med til at sikre, at platformen også fungerer i praksis.
Mål, hvor mange pilotprojekter der når i produktion, før du udruller løsningen bredere. Produktion kræver stramme sikkerhedsrammer for platformen, men det kan lade sig gøre. Med grundige testprotokoller og gennemtænkte reserveløsninger kan du blive en af de virksomheder, der faktisk får et målbart afkast af deres AI-investeringer.
Vi bruger denne beslutningsmatrix til at vælge opgaver målrettet. Den fjerner gætteriet.
| Kriterium | Fakturabehandling | Kontraktgennemgang | Visitering af e-mails |
|---|---|---|---|
| Volumen | Høj | Middel | Høj |
| Undtagelsesrate | Lav | Middel | Høj |
| Tid til afkast | 9,8 måneder | 14,2 måneder | 18+ måneder |
| Integrationskompleksitet | Lav | Høj | Middel |
Når du vælger de rigtige processer, bliver tilbagebetalingstiden markant kortere. Det frigør kapital til næste bølge af automatisering.
Et produktionssystem skal have overvågning, alarmer og en reserveløsning. Uden undtagelse. Hvis AI-systemet fejler, skal opgaven gå videre til manuel behandling, uden at hændelsen går tabt eller data bliver ødelagt.
Det er et ufravigeligt krav. Vi designer alle orkestrerede arbejdsgange med automatisk håndtering af driftsforringelser, så ingen data går tabt, selv ved alvorlige nedbrud i infrastrukturen.
Konklusion: Gør virksomheden mere effektiv med AI-automatisering i stor skala
Hvis AI skal gøre en virksomhed mere effektiv i stor skala, kræver det avancerede teknikker til optimering af AI-automatiserede arbejdsgange. Det kan man ikke foregive sig til. Organisationer skal forene ambitiøse mål for automatisering med konsekvent driftsdisciplin i hver eneste afdeling.
Ellers risikerer de at ende blandt de 41% mislykkede projekter. Det kan koste karrierer. Når du prioriterer hastighed over stabilitet, ender du med skrøbelige systemer, der bryder sammen ved spidsbelastning og undergraver ledelsens tillid til din tekniske strategi.
Det kræver disciplin: Mennesker skal kunne gribe ind i beslutningerne, arbejdsgangene skal være hændelsesstyrede, og udgangspunktet skal måles omhyggeligt, så omkostningerne ikke løber løbsk, og præcisionen ikke falder. Automatisér ikke processer, der ikke fungerer. Det er den værste fejl, du kan begå.
Ret først op på den grundlæggende arbejdsgang. Så kan dine AI-værktøjer levere det eksponentielle afkast, der retfærdiggør den store investering.
Skiftet fra regelbaseret RPA til dynamisk AI-orkestrering er gennemført. De gamle metoder er forældede. Virksomheder, der mestrer disse integrationsteknikker, vil dominere deres markeder.
De, der ser bort fra de driftsmæssige sikkerhedsforanstaltninger, vil hurtigt brænde kapital af. Det garanterer vi. Valget er dit: Opbyg en disciplineret evne til at orkestrere AI nu, eller se dine konkurrenter bruge AI til systematisk at tage markedsandele fra dig.
Sådan ser teknikker til optimering af AI-automatiserede arbejdsgange ud i praksis.
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller op til 75 % under listepris
Én API-nøgle til modellerne fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellerne fungerer også med Anthropic SDK og Claude Code.
Hver models pris via AIGROW-kredit ligger ved siden af udviklerens listepris, aldrig over den.
Ofte stillede spørgsmål
