A IA empresarial funciona quando modelos isolados dão lugar a fluxos de trabalho orquestrados, mantendo a intervenção humana. Quando bem implementada, a orquestração reduz o tempo dos processos em 43% e as taxas de erro em 90%. Este guia aborda a arquitetura, os controlos que garantem a segurança e a forma de avaliar se a solução ganhou escala.
A criar com modelos de IA? O crédito de API da AIGROW executa os modelos Claude, GPT, Gemini e Grok até 75% abaixo do preço de tabela.
- A orquestração ajuda quando um fluxo de trabalho tem estado, dependências, novas tentativas e etapas com responsáveis definidos. Também introduz falhas possíveis que precisam de ser testadas.
- Escolha o padrão de coordenação mais simples que dê conta do processo e defina limites de etapas, tempos de espera, responsáveis e regras de escalonamento.
- Defina os limiares de revisão com base nos resultados das avaliações e no risco para o negócio, em vez de copiar uma pontuação genérica de confiança.
- Meça o trabalho concluído, a taxa de correção, o tempo de recuperação, o custo total e os incidentes com critérios consistentes.
Introdução: a transição para a orquestração de fluxos de trabalho com IA
O mercado mudou por completo. A adoção já é maioritária: 66% das organizações implementaram alguma forma de automação de fluxos de trabalho. O impulso é inegável.
As arquiteturas de referência atuais combinam agentes de IA, pipelines orientados por eventos e controlos de qualidade com intervenção humana para gerir cargas de trabalho operacionais complexas. O setor abandonou por completo a RPA estática. A automação dinâmica com IA processa informação muito mais depressa e adapta-se bem a casos excecionais que fariam falhar scripts antigos.
As regras estáticas ficaram para trás. Aplicar técnicas adequadas de otimização de fluxos de trabalho com automação de IA exige um rigor operacional elevado para manter a precisão do processamento dinâmico perante conjuntos de dados empresariais diversos e imprevisíveis.
Use esta lista para começar:
- [ ] Mapear o processo atual como ponto de partida
- [ ] Definir metas para os limiares de exceção
- [ ] Escolher uma estrutura de orquestração
- [ ] Configurar gatilhos orientados por eventos
- [ ] Colocar o primeiro caso de uso em produção
A orquestração de fluxos de trabalho coordena sistematicamente agentes de IA e controlos de qualidade humanos
A orquestração coordena agentes, gatilhos de eventos, serviços determinísticos e revisão humana ao longo de um processo. Avalie-a pelo trabalho concluído, pela taxa de correção, pelo tempo de recuperação, pelo custo operacional e pelos incidentes, usando critérios aceites pela equipa de operações.
A orquestração torna-se útil quando um fluxo de trabalho tem dependências, novas tentativas, estado e várias etapas com responsáveis definidos. Teste dados inesperados e serviços indisponíveis para perceber se a coordenação melhora a recuperação ou apenas acrescenta complexidade.
É preciso definir uma estrutura. A documentação do LangChain identifica cinco padrões principais de orquestração de múltiplos agentes usados atualmente em produção para gerir cargas de trabalho operacionais complexas e de alto risco: * Router: Um agente central encaminha tarefas para agentes especializados de acordo com a intenção. * Supervisor: Um modelo hierárquico em que um agente supervisor distribui tarefas e valida os resultados.
* Network: Os agentes comunicam entre si e distribuem tarefas dinamicamente. * Hierarchical: A delegação ocorre em vários níveis: gestores atribuem tarefas a executores e depois agregam os resultados. * Custom/Graph: Fluxos de trabalho baseados em máquinas de estados que definem a lógica exata das transições entre agentes.
Num padrão em rede, os agentes podem entrar num ciclo em que passam a mesma tarefa de um para o outro. Evite-o com um limite de etapas, deteção de tarefas duplicadas, regras de responsabilidade, tempos de espera e um caminho de escalonamento. Teste esses controlos com falhas provocadas antes de entrar em produção.
Um padrão hierárquico pode sustentar um fluxo complexo, como a análise de pedidos de crédito, em que agentes executores reúnem dados e um componente gestor combina os resultados. Num cenário hipotético de falha, o gestor recebe dados contraditórios sobre crédito e rendimentos, mas não dispõe de uma regra determinística para resolver o conflito ou escalar o caso. Teste conflitos, documentos em falta, tempos de espera e ações recusadas antes de usar o padrão em decisões reais.
Quando dois agentes executores devolveram rácios contraditórios entre dívida e rendimento, o gestor demorou 45 segundos a analisar a discrepância. A latência passou dos 2 segundos esperados para um nível totalmente inaceitável. A escolha óbvia costuma ser o padrão mais avançado, mas há um custo menos visível: a complexidade aumenta exponencialmente a dificuldade de depuração.
Recomendamos vivamente começar pelo padrão Supervisor. Permite uma delegação controlada sem o risco de ciclos infinitos do padrão Network.
Integramos estes padrões diretamente numa arquitetura orientada por eventos. Para criar uma lógica de ferramentas fiável, é preciso ligar a estrutura de orquestração aos gatilhos de webhook da ferramenta, que iniciam e monitorizam cada fluxo automatizado. Este é o formato padrão da mensagem que usamos para iniciar um fluxo orquestrado.
Funciona sem problemas. Ao uniformizar a estrutura JSON em todos os pipelines, reduz significativamente as dificuldades de integração e facilita muito a depuração para as equipas de engenharia.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Esta estrutura JSON garante que o motor de IA recebe tanto a tarefa como os parâmetros de governação necessários. Se a confiança cair abaixo de 0.85, o sistema encaminha o caso para uma fila de revisão humana. Assim, garante o controlo de qualidade sem bloquear todo o pipeline, mantendo o volume de processamento e aplicando rigorosamente os limites operacionais definidos.
Aplicar técnicas adequadas de otimização de fluxos de trabalho com automação de IA garante que as pessoas com maior custo para a empresa dedicam o seu tempo apenas a casos excecionais de grande impacto, em vez de tarefas rotineiras de extração de dados.
Ouvimos esta objeção constantemente: as equipas de operações dizem que a orquestração acrescenta uma latência inaceitável aos pipelines de processamento de transações críticas. Mas isso é um mito. Pipelines orientados por eventos e devidamente configurados reduzem o tempo total dos processos ao eliminar passagens manuais entre equipas e etapas intermédias desnecessárias.
Passo 1: definir regras de escalonamento para revisão humana em pipelines orientados por eventos
Definir regras de escalonamento para revisão humana (HITL) exige associar limiares de confiança rigorosos a níveis específicos de revisão. Não pode saltar esta etapa. O potencial de retorno financeiro é enorme.
Defina onde termina a automação e começa a revisão humana. Os limiares devem refletir o risco da ação, a possibilidade de a reverter, o grau de confiança e os requisitos regulamentares. Depois, devem ser validados com casos de falha representativos.
- Nível 1: execução automática. Confiança > 95%. Sem revisão humana.
- Nível 2: verificação por amostragem. Confiança de 80 a 95%. Auditoria aleatória de 10% dos casos.
- Nível 3: revisão obrigatória. Confiança < 80%. Todos os casos seguem para a fila HITL.
Basear estes limiares apenas no resultado bruto de um LLM é um erro grave. Os modelos têm uma calibração fraca. Um LLM pode indicar 99% de confiança perante uma injeção maliciosa de instruções escondida num contrato carregado, contornando por completo a fila HITL e causando danos catastróficos.
Para corrigir isto, crie verificações de consistência entre respostas. Gere três respostas para a mesma entrada. Se duas coincidirem, a confiança é elevada.
Se as três forem diferentes, imponha o escalonamento para o Nível 3, independentemente da pontuação interna.
Considere um pipeline hipotético de processamento de sinistros em que entradas adversariais aumentam artificialmente a confiança. Validação determinística, limites de pagamento, deteção de anomalias e aprovação humana para ações de alto risco devem impedir o sistema de executar um lote grande. Teste estes controlos com casos sintéticos antes de processar sinistros reais.
Se o sistema extrair um valor em dólares, uma verificação baseada em regras garante que está dentro dos limites históricos. Além disso, a capacidade de revisão humana é limitada. Configuramos um sistema de limiares dinâmicos.
Se o tempo de espera na fila de revisão humana ultrapassar 4 horas, o sistema aumenta temporariamente o limiar de execução automática para 97% e suspende as verificações por amostragem do Nível 2. Isto evita que os revisores fiquem sobrecarregados com escalonamentos de baixo impacto.
As técnicas de integração para arquiteturas orientadas por eventos usam Apache Kafka e Google Cloud PubSub como intermediários de mensagens. Recorremos muito a ambos. Quando um documento entra no pipeline, o Kafka publica o evento; o motor de orquestração de IA recebe-o, processa os dados e publica o resultado.
O encaminhamento é automático. Se a confiança for baixa, o sistema envia os dados diretamente para o PubSub para revisão humana imediata.
Os utilizadores das áreas de negócio iniciam estes fluxos de IA através de plataformas no-code e low-code. É muito simples: alguém carrega um contrato num portal e a plataforma envia um webhook para o backend. O motor de orquestração extrai cláusulas, compara-as com os padrões e devolve uma pontuação de risco abrangente.
É assim que a tecnologia se torna realmente útil. Ao ocultar a complexidade das APIs, permite que equipas sem conhecimentos técnicos façam análises de risco sofisticadas sem escrever uma única linha de código.
Passo 2: calcular o retorno sobre o investimento e comparar a redução de custos entre o projeto-piloto e a produção
É um retorno impressionante. Acompanhe o tempo de ciclo, o custo de mão de obra e de correções, o uso dos modelos, o tempo de revisão e os incidentes, com definições aceites pelas equipas financeira e de operações. Calcular o ROI é parte essencial de uma boa otimização dos fluxos de trabalho automatizados com IA.
É o que distingue implementações bem-sucedidas de experiências dispendiosas.
Use esta tabela para comparar a redução de custos:
| Caso de uso | Custo manual | Custo da orquestração de IA | Poupança | Redução de erros |
|---|---|---|---|---|
| Processamento de faturas | $3.70 / documento | $1.20 / documento | 67,6% | um percentual significativo |
| Revisão de contratos | $52.00 / contrato | $18.50 / contrato | 64,4% | 85% |
Veja um exemplo de processamento de faturas em escala. Considere um volume de 50.000 faturas. O custo manual é simples: 50.000 multiplicado por $3.70 resulta em $185,000 por mês.
Para calcular o custo automatizado, multiplique 50.000 por $1.20, valor que inclui computação e revisão humana. O resultado é $60,000. Acrescente $5,000 para tokens de API e $2,000 para alojamento.
O custo automatizado total é de $67,000 por mês. Isso representa uma poupança mensal de $118,000 e uma poupança anual de $1,416,000.
O impacto em escala é enorme, e este não é um caso isolado. Aplicar estes métodos de otimização a uma grande empresa pode transformar a sua estrutura de custos operacionais graças ao efeito acumulado das poupanças.
Calculadora de ROI de fluxos de trabalho com IA
Calcule a sua poupança mensal com a automatização de faturas por IA.
Uma conclusão pouco óbvia: porque falham 41% dos projetos empresariais de orquestração de IA?
Os projetos empresariais de orquestração de IA falham quando as organizações tentam automatizar processos deficientes sem primeiro medir o ponto de partida ou redesenhar os fluxos de trabalho. É uma falha decisiva. Uns impressionantes 41% destes projetos não atingem os objetivos de negócio declarados dentro do prazo e do orçamento originais, devido à escolha errada dos processos e à subestimação das integrações.
Vemo-lo constantemente. Sem o trabalho prévio de redesenho, as novas ferramentas de IA, por mais caras que sejam, limitam-se a reproduzir as ineficiências existentes a um ritmo muito mais rápido.
A automação com IA pode trazer ganhos reais a cada fluxo de trabalho. Mas o ROI em toda a empresa depende de medir o ponto de partida, redesenhar os fluxos, garantir a adoção, estabelecer uma governação eficaz e controlar rigorosamente os custos. A automação não corrige um processo deficiente.
Apenas faz com que falhe mais depressa, enquanto consome recursos de computação dispendiosos. É uma realidade difícil de aceitar. Recusamo-nos a implementar agentes em fluxos de trabalho instáveis até que o cliente mapeie o estado atual e redesenhe os passos operacionais necessários para obter eficiência real.
Se um processo tiver uma taxa de exceções superior a 8%, ainda não o automatize. Redesenhe-o primeiro. Muitas equipas escolhem casos de uso muito variáveis, o que leva a IA a encaminhar constantemente tarefas para operadores humanos já sobrecarregados.
Porque o fazem? É a abordagem errada. Dominar a otimização dos fluxos de trabalho automatizados com IA implica aceitar que nem tudo deve entrar imediatamente em produção, independentemente das exigências da administração.
A razão deste fracasso é matemática. Com taxas de exceção elevadas, o orquestrador torna-se pouco mais do que um sistema de encaminhamento para pessoas. Paga por tudo: tokens de API, tempo de computação e gestão de filas para cada transação que passa pelo sistema.
Se a IA tentar processar uma reclamação complexa, falhar e a encaminhar para uma pessoa, o tempo total de processamento será significativamente maior do que se essa pessoa tivesse tratado do caso desde o início.
Avaliámos uma empresa de logística da Fortune 500 que tentou automatizar a decisão sobre reclamações relativas ao transporte de mercadorias. Escolheu este caso de uso porque o valor por transação era elevado. Mas havia um problema: valores elevados costumam vir acompanhados de grande variabilidade.
A taxa real de exceções era de 22%. Cada transportadora usava formatos próprios para os comprovativos e enviava emails desorganizados, que confundiam o modelo. A IA gastava tokens a tentar interpretar conversas de email sem estrutura, falhava e encaminhava o caso.
O fracasso teve custos. A tentativa falhada da IA acrescentou 3 minutos a cada reclamação, causando $1.2M em atrasos operacionais adicionais no espaço de seis meses.
De forma semelhante, a General Motors recuou, em 2023, num projeto de encaminhamento totalmente automatizado para a cadeia de abastecimento. Descobriu que a diversidade de formatos dos dados dos fornecedores fazia a taxa de exceções ultrapassar 30%. Teve de voltar a um sistema baseado em regras, complementado por uma camada de assistência com IA para tratar os casos imprevisíveis.
As equipas escolhem processos complexos e de alto valor porque as projeções nas folhas de cálculo parecem extraordinárias. Resista a essa tentação. Comece por processos simples e repetitivos para ganhar confiança operacional e estabilidade técnica antes de enfrentar os casos de grande variabilidade.
Usamos esta lista para evitar esses problemas. Antes de escrever uma única linha de código, confirme que a taxa de exceções do processo é inferior a 8%. - [ ] Confirmar que a taxa de exceções do processo é inferior a 8% - [ ] Estabelecer valores de referência para os custos e o tempo de ciclo - [ ] Mapear os pontos de integração com sistemas legados - [ ] Obter o apoio das partes interessadas para redesenhar o fluxo de trabalho Para nós, estes passos são indispensáveis.
Se os ignorar, implementará um sistema que consome capital e frustra a equipa de operações.
Está a deixar que o entusiasmo pela IA dite a sua estratégia de implementação? Não o faça. Escolha as tarefas certas, meça o ponto de partida e redesenhe o fluxo antes sequer de pensar em automatizá-lo. Só depois avance com a automação.
Como monitorizar as alterações no desempenho dos modelos e integrar motores de IA com mainframes legados?
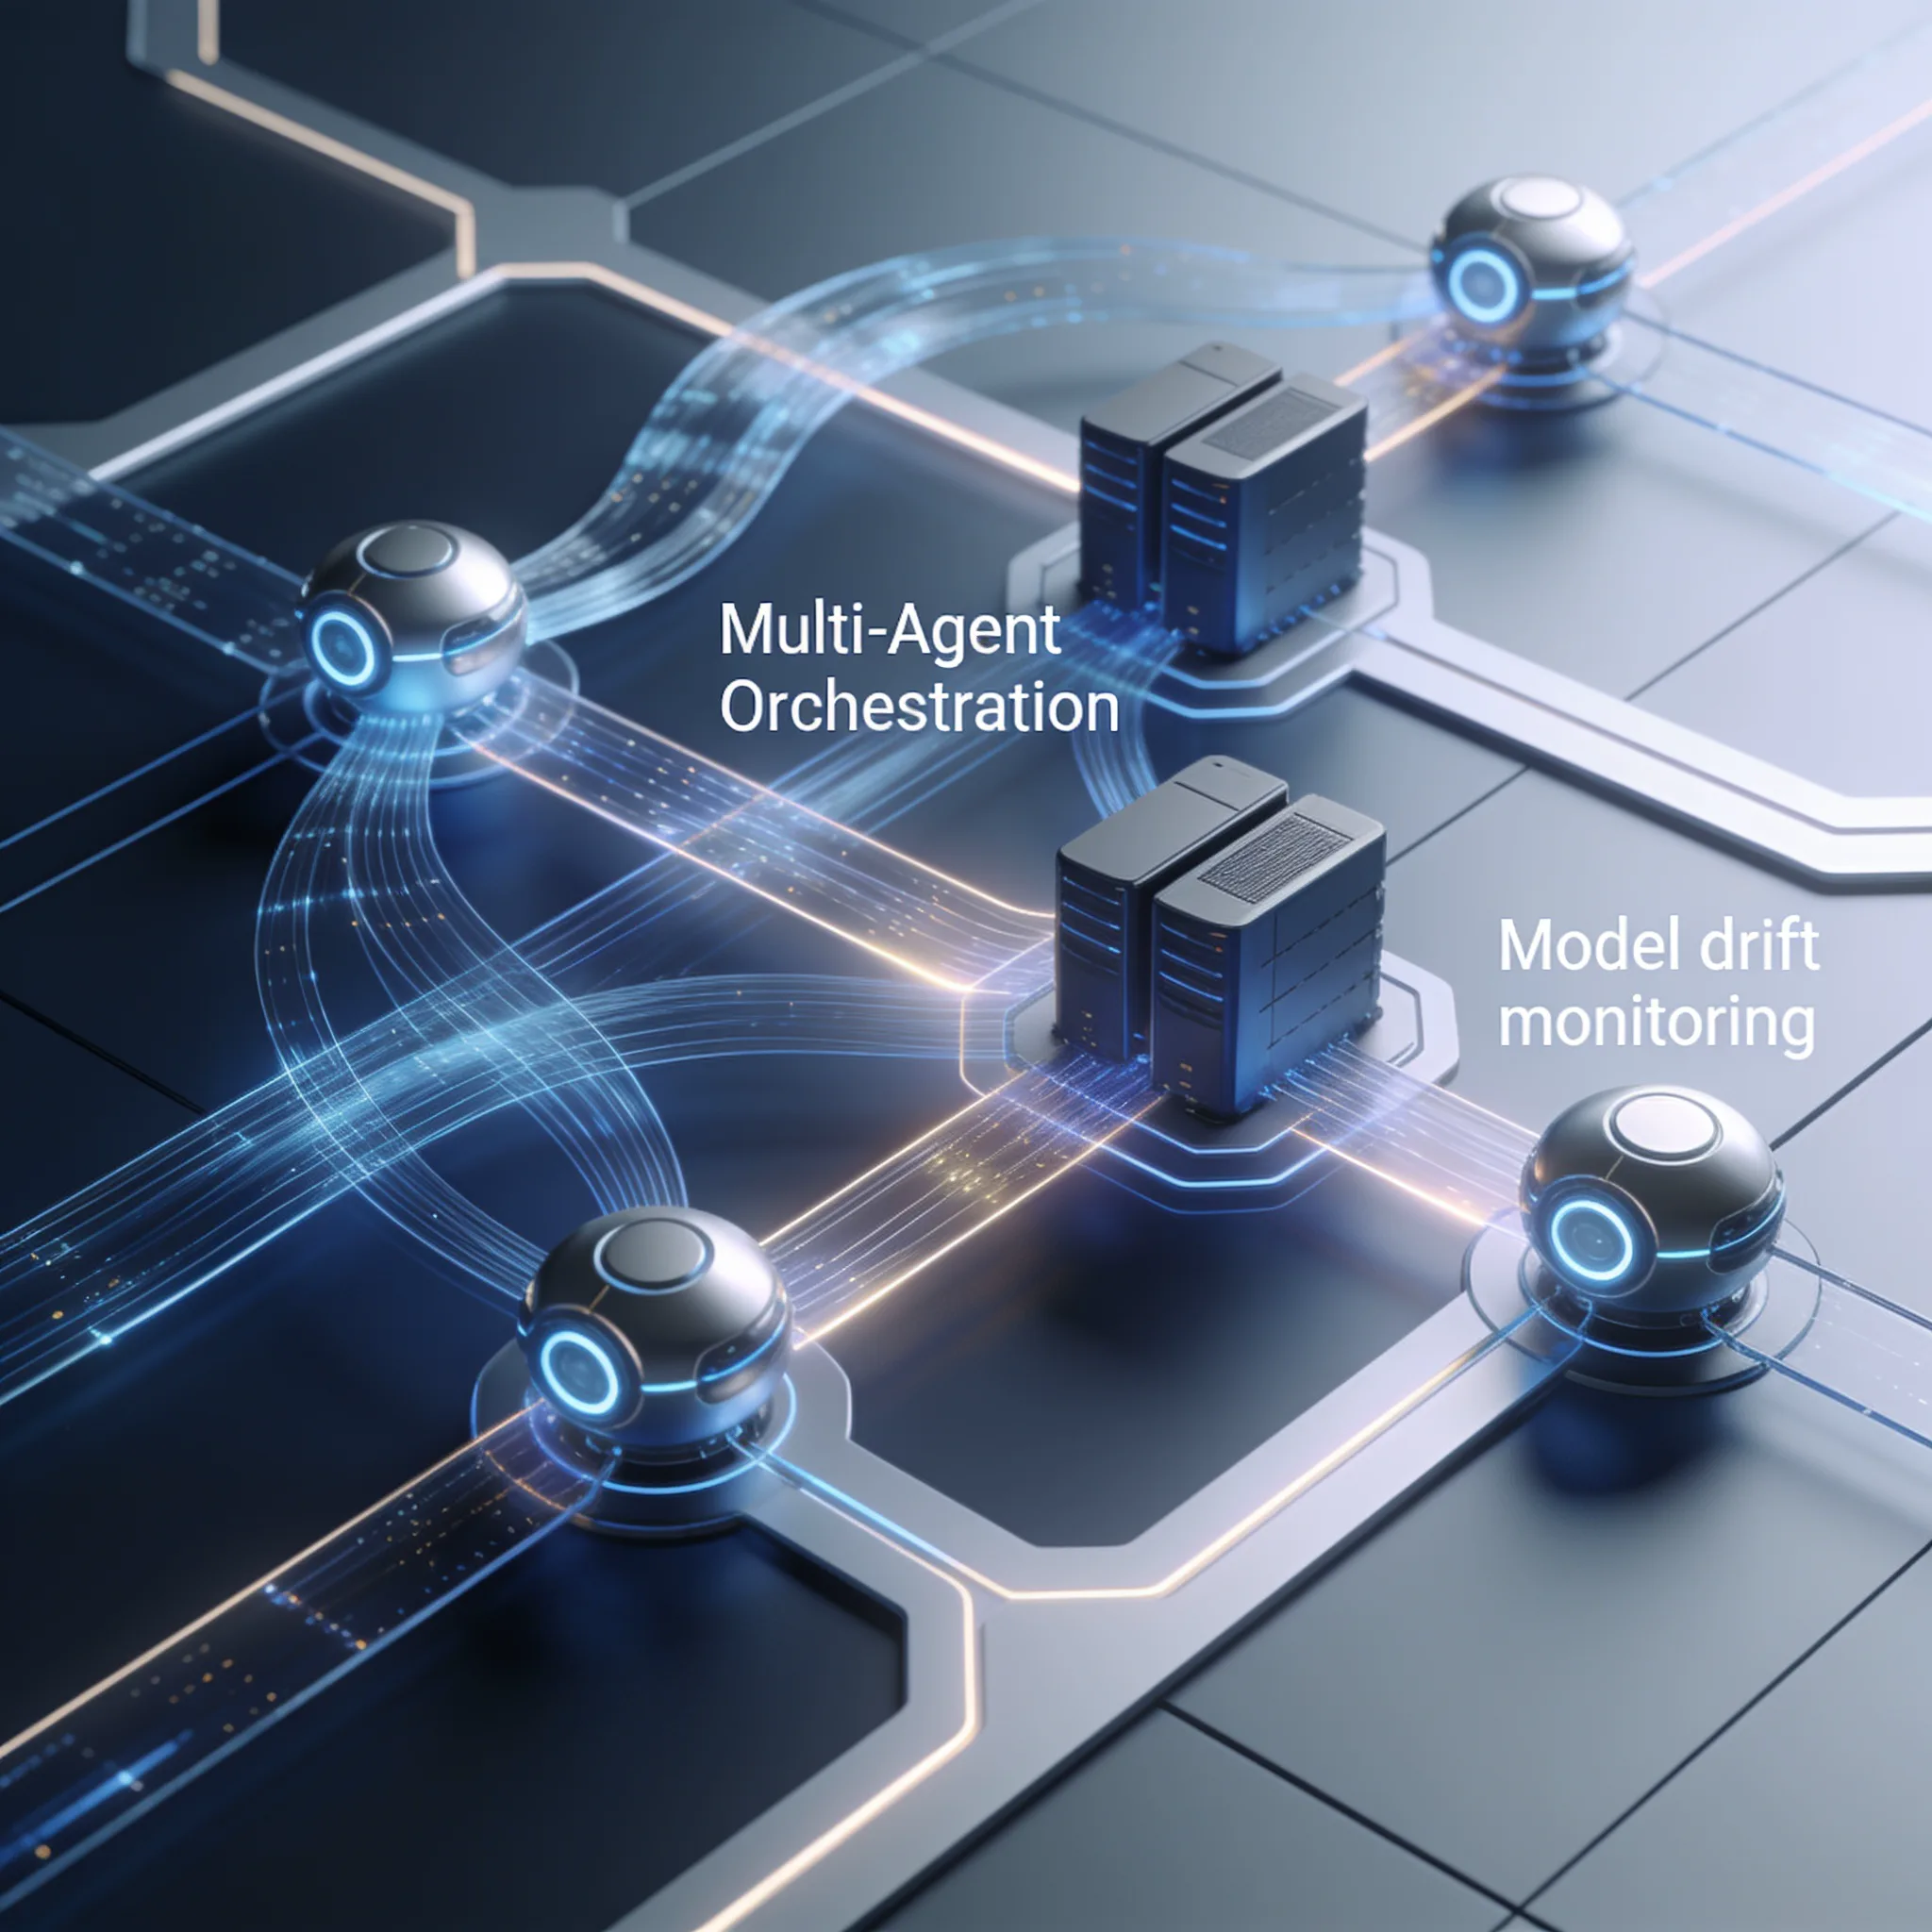
Para monitorizar as alterações no desempenho de um modelo, estabeleça conjuntos de dados com resultados de referência e acompanhe, ao longo do tempo, a distribuição das pontuações de confiança. Para integrar motores de IA com mainframes legados, use gateways de API e middleware que converta dados JSON modernos em formatos aceites pelos terminais antigos. Acompanhe o desempenho do modelo e os níveis de serviço com dados de inferência registados, amostras com resultados verificados e alertas atribuídos a uma pessoa responsável pela resposta.
Para acompanhar os SLA em tempo real, registe a latência de todas as inferências e emita alertas quando os limites forem ultrapassados. A otimização avançada dos fluxos de trabalho automatizados com IA exige uma atenção constante à saúde do modelo e de todo o sistema.
As alterações no modelo podem degradar rapidamente a precisão. Monitorize continuamente as distribuições dos dados de entrada e os intervalos de confiança das respostas. Se um agente passar a indicar 40% de confiança numa tarefa que normalmente executa com 95%, sinalize-o de imediato.
É um sinal claro de alerta. Ignorar estas mudanças estatísticas permite que o fluxo automatizado contamine gradualmente os dados dos sistemas seguintes com respostas falsas apresentadas com confiança, minando a confiança dos utilizadores.
Integrar IA com mainframes legados é um desafio técnico sério, mas tem solução. Use uma camada de middleware adequada para ligar os motores modernos de orquestração de IA a sistemas antigos incapazes de processar dados JSON modernos. A arquitetura faz a diferença.
Com uma camada de conversão bem concebida, os agentes de IA podem obter contexto e registar atualizações sem que tenha de alterar o sistema legado central.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Esta configuração YAML converte os dados das API modernas em formatos que o mainframe consegue interpretar. Assim, os serviços conseguem comunicar entre si. O agente de IA pode obter contexto e registar atualizações sem modificar o sistema legado central.
É uma grande vantagem operacional: evita o risco e o custo de mexer em código COBOL frágil, com décadas de existência, que suporta os seus sistemas bancários mais críticos.
Uma alteração no modelo de uma fatura pode manter uma pontuação elevada do modelo, mas fazer com que um valor seja colocado no campo errado. Monitorize a precisão de cada campo com amostras revistas, detete alterações na distribuição dos dados de entrada e interrompa o processamento quando a validação falhar.
A integração com mainframes apresenta riscos específicos para os dados. Converter decimais compactados de COBOL em valores JSON de vírgula flutuante pode introduzir erros de arredondamento que se acumulam ao longo de muitas transações. Preserve os tipos decimais, reconcilie os totais e execute o novo cálculo em paralelo com o existente antes de processar dados financeiros reais.
Quantifique qualquer diferença com base em registos de produção revistos, não numa estimativa de perdas inventada.
Para evitar esses erros, crie no middleware uma camada rigorosa que preserve os tipos decimais. A execução em paralelo é obrigatória. Encaminhe 5% do tráfego real para o modelo atualizado, compare os resultados com os do sistema legado e registe as diferenças.
Depois, aguarde. Só encaminhe o tráfego principal para o modelo quando a taxa de erros ficar abaixo de 0,5% e o sistema demonstrar estabilidade.
Acompanhe os níveis de serviço com definições explícitas, registos e uma pessoa responsável por responder à degradação do desempenho. Exemplos de produtividade de outros contextos não demonstram o que será possível alcançar num fluxo de trabalho diferente.
Passo 3: que casos de uso da automação de fluxos de trabalho são mais adequados para produção?
Os melhores casos de uso da automação de fluxos de trabalho para produção são processos de grande volume, poucas exceções e resultados determinísticos, com percursos claros de encaminhamento para revisão humana. Exemplos incluem o processamento de faturas, o encaminhamento de pedidos de clientes e a análise de contratos. É exclusivamente nestes casos que nos concentramos.
A escolha oferece uma vantagem clara. Selecionar os casos de uso é o último passo de uma boa otimização dos fluxos de trabalho automatizados com IA e ajuda a garantir que a plataforma funciona nas condições reais de operação.
Meça quantos projetos-piloto chegam à produção antes de alargar a implementação. A entrada em produção exige controlos rigorosos na plataforma, mas é perfeitamente viável. Com protocolos de teste exigentes e mecanismos de contingência adequados, poderá juntar-se à minoria das empresas que obtêm retornos mensuráveis dos seus investimentos em IA.
Usamos esta matriz de decisão para escolher os casos de uso com rigor. Elimina as suposições.
| Critério | Processamento de faturas | Revisão de contratos | Triagem de emails |
|---|---|---|---|
| Volume | Alto | Médio | Alto |
| Taxa de exceções | Baixa | Média | Alta |
| Prazo de retorno do investimento | 9,8 meses | 14,2 meses | 18+ meses |
| Complexidade da integração | Baixa | Alta | Média |
Ao escolher os processos certos, reduz drasticamente o prazo de retorno do investimento e liberta capital para financiar a próxima vaga de iniciativas de automação.
Um sistema em produção precisa de monitorização, alertas e mecanismos de contingência. Sem exceções. Se o motor de IA falhar, o sistema deve encaminhar o trabalho para uma pessoa, sem perder o evento nem corromper os dados.
É um requisito indispensável. Concebemos todos os fluxos de orquestração com mecanismos de degradação automática que garantem que não há perda de dados, mesmo durante falhas graves da infraestrutura.
Conclusão: aumentar a eficiência empresarial com a automação por IA
Aumentar a eficiência empresarial com IA exige técnicas avançadas de otimização de fluxos de trabalho automatizados. Não há atalhos. As organizações têm de conciliar metas ambiciosas de automação com rigor operacional em todos os departamentos.
Ignorar esse equilíbrio é cair na armadilha dos 41% de projetos que falham. E pode arruinar carreiras. Quando se privilegia a velocidade em detrimento da estabilidade, acabam por ser implementados sistemas frágeis, que falham nos períodos de maior procura e minam a confiança da direção na estratégia técnica.
Mas é preciso disciplina. São necessárias decisões com intervenção humana, pipelines orientados por eventos e um acompanhamento rigoroso dos valores de referência para evitar custos descontrolados e perda de precisão. Não automatize processos que não funcionam.
É o pior erro que pode cometer. Corrija primeiro o fluxo de trabalho subjacente para que as suas ferramentas de IA possam gerar os retornos exponenciais que justificam o enorme investimento de capital.
A transição da RPA baseada em regras para a orquestração dinâmica de IA está concluída. Os métodos antigos ficaram para trás. As empresas que dominarem estas técnicas de integração liderarão os seus mercados; as que ignorarem as salvaguardas operacionais gastarão capital rapidamente.
Garantimos isso. A escolha é sua: desenvolver agora uma capacidade de orquestração disciplinada ou ver os concorrentes usar a IA para reduzir sistematicamente a sua quota de mercado. É assim que se aplicam, na prática, as técnicas de otimização de fluxos de trabalho automatizados com IA.
Modelos atuais Claude, GPT, Gemini e Grok, até 75% abaixo do preço de tabela
Uma única chave de API para os modelos Claude, GPT, Gemini e Grok no SDK da OpenAI. Os modelos Claude funcionam também com o SDK da Anthropic e o Claude Code.
A taxa de cada modelo através do crédito AIGROW surge ao lado do preço de tabela do respetivo fabricante, nunca acima dele.
Perguntas frequentes
