KI fungerer i store virksomheter når isolerte modeller erstattes av orkestrerte arbeidsflyter der mennesker fortsatt er involvert. Gjort riktig reduserer orkestrering prosesstiden med 43% og feilraten med 90%. Denne guiden tar for seg arkitekturen, kontrollene som gjør den trygg, og hvordan du måler om løsningen fungerer i stor skala.
Bygger du med KI-modeller? AIGROW API-kreditt kjører modeller fra Claude, GPT, Gemini og Grok opptil 75 % under listepris.
- Orkestrering er nyttig når en arbeidsflyt har tilstand, avhengigheter, nye forsøk og trinn med tydelig ansvar. Den innfører også feilmuligheter som må testes.
- Velg det enkleste koordineringsmønsteret som håndterer prosessen, og legg til grenser for antall trinn, tidsfrister, ansvarsfordeling og eskalering.
- Fastsett terskler for gjennomgang ut fra evalueringsresultater og forretningsrisiko, ikke ved å kopiere en generell konfidensskår.
- Mål fullført arbeid, korrigeringsrate, gjenopprettingstid, totalkostnad og hendelser med faste definisjoner.
Innledning: Overgangen til orkestrerte KI-arbeidsflyter
Markedet har endret seg fullstendig. Automatisering er nå det vanlige, og 66% av organisasjonene har tatt i bruk en form for arbeidsflytautomatisering. Utviklingen er ikke til å overse.
Moderne referansearkitekturer kombinerer KI-agenter, hendelsesstyrte pipelines og kvalitetskontroll med mennesker involvert for å håndtere komplekse driftsoppgaver. Bransjen har lagt statisk RPA helt bak seg. Dynamisk KI-automatisering behandler informasjon langt raskere og tilpasser seg spesialtilfeller som ville fått eldre skript til å feile.
Statiske regler hører fortiden til. Skal du optimalisere KI-automatiserte arbeidsflyter på en god måte, kreves streng kontroll med driften slik at den dynamiske behandlingen forblir svært nøyaktig på tvers av varierte og uforutsigbare datasett i store virksomheter.
Bruk denne sjekklisten for å komme i gang:
- [ ] Kartlegg dagens prosess og utgangspunkt
- [ ] Fastsett mål for terskler ved avvik
- [ ] Velg rammeverk for orkestrering
- [ ] Konfigurer hendelsesstyrte utløsere
- [ ] Sett det første bruksområdet i produksjon
Orkestrering av arbeidsflyter er systematisk koordinering av KI-agenter og menneskelig kvalitetskontroll
Orkestrering av arbeidsflyter koordinerer agenter, hendelsesutløsere, deterministiske tjenester og menneskelig gjennomgang gjennom en prosess. Vurder den ut fra fullført arbeid, korrigeringsrate, gjenopprettingstid, driftskostnad og hendelser, med definisjoner driftsteamet kan stå inne for.
Orkestrering blir nyttig når en arbeidsflyt har avhengigheter, nye forsøk, tilstand og flere trinn med tydelig ansvar. Test uventede inndata og utilgjengelige tjenester for å finne ut om koordineringen gjør gjenoppretting enklere eller bare øker kompleksiteten.
Her trengs en tydelig struktur. Rammeverket LangChain beskriver fem utbredte mønstre for orkestrering av flere agenter som i dag brukes i produksjonsmiljøer til å håndtere komplekse, kritiske driftsoppgaver: * Ruter: En sentral agent sender oppgaver til spesialiserte underagenter ut fra hensikten. * Supervisor: En hierarkisk modell der en overordnet agent fordeler oppgaver og kontrollerer resultatene.
* Nettverk: Agenter kommuniserer direkte med hverandre og fordeler oppgaver dynamisk. * Hierarkisk: Delegering i flere nivåer, der ledere fordeler oppgaver til utførende agenter og deretter sammenstiller resultatene. * Tilpasset/graf: Arbeidsflyter basert på tilstandsmaskiner som definerer nøyaktig hvordan oppgaver flyttes mellom agenter.
Et nettverksmønster kan havne i en delegeringssløyfe når agenter kan sende samme oppgave frem og tilbake. Unngå dette med en grense for antall trinn, registrering av dupliserte oppgaver, regler for oppgaveansvar, tidsfrister og en vei for eskalering. Test kontrollene med fremprovoserte feil før produksjonssetting.
Et hierarkisk mønster kan håndtere en kompleks arbeidsflyt som kredittvurdering av lån, der utførende agenter samler dokumentasjon og en overordnet komponent setter sammen resultatene. I et tenkt feilscenario mottar den overordnede komponenten motstridende opplysninger om kreditt og inntekt, men mangler en deterministisk regel for å løse eller eskalere konflikten. Test motstridende opplysninger, manglende dokumenter, tidsfrister som utløper, og avviste handlinger før mønsteret brukes til reelle beslutninger.
Da to utførende agenter leverte motstridende forholdstall for gjeld og inntekt, brukte den overordnede komponenten 45 sekunder på å vurdere avviket. Responstiden steg dermed fra forventede 2 sekunder til et helt uakseptabelt nivå. Det kan virke opplagt å velge det mest avanserte mønsteret, men den skjulte kostnaden er at kompleksiteten gjør feilsøking eksponentielt vanskeligere.
Vi anbefaler på det sterkeste å starte med Supervisor-mønsteret. Det gir kontrollert delegering uten risikoen for endeløse sløyfer som følger med nettverksmønsteret.
Vi integrerer disse mønstrene direkte med hendelsesstyrt arkitektur. For å bygge pålitelig verktøylogikk må du koble rammeverket for orkestrering til webhook-utløsere som starter og overvåker hver automatiserte arbeidsflyt. Her er standardformatet vi bruker for nyttelasten som utløser en orkestrert arbeidsflyt.
Det fungerer utmerket. Når du standardiserer JSON-strukturen på tvers av alle pipelinene dine, reduserer du integrasjonsarbeidet betydelig og gjør feilsøking mye enklere for utviklingsteamene.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Denne JSON-strukturen sørger for at KI-motoren mottar både oppgaven og de nødvendige kontrollparameterne. Hvis konfidensen faller under 0.85, sendes oppgaven til en kø for menneskelig gjennomgang. Det sikrer kvalitetskontroll uten å blokkere hele pipelinen.
Dermed opprettholdes gjennomstrømningen samtidig som de operative rammene håndheves strengt. God optimalisering av KI-automatiserte arbeidsflyter sørger for at de mest kostbare medarbeiderressursene bare brukes på reelle spesialtilfeller med stor betydning, ikke rutinemessig datauthenting.
Vi hører innvendingen stadig vekk: Driftsteam mener orkestrering gir uakseptabel forsinkelse i kritiske pipelines for transaksjonsbehandling. Men det stemmer ikke. Riktig konfigurerte, hendelsesstyrte pipelines reduserer faktisk den samlede prosesstiden ved å fjerne manuelle overleveringer og unødvendige mellomliggende behandlingstrinn.
Trinn 1: Utform eskaleringslogikk med menneskelig kontroll for hendelsesstyrte pipelines
For å utforme eskaleringslogikk med menneskelig kontroll (HITL) må du knytte tydelige konfidensgrenser til bestemte nivåer for gjennomgang. Dette trinnet kan du ikke hoppe over. Den økonomiske gevinsten kan være stor.
Definer hvor automatiseringen stopper og menneskelig gjennomgang begynner. Grensene bør gjenspeile risikoen ved handlingen, om den kan reverseres, konfidens og regulatoriske krav. Deretter bør de valideres med representative feiltilfeller.
- Nivå 1: Utfør automatisk. Konfidens > 95%. Ingen menneskelig gjennomgang.
- Nivå 2: Stikkprøve. Konfidens 80 til 95%. Tilfeldig kontroll av 10% av tilfellene.
- Nivå 3: Obligatorisk gjennomgang. Konfidens < 80%. Full HITL-kø.
Det er en alvorlig feil å basere disse grensene utelukkende på råresultatet fra en LLM. Modellene er dårlig kalibrert. En LLM kan oppgi 99% konfidens for en ondsinnet promptinjeksjon skjult i en opplastet kontrakt.
Da kan oppgaven gå utenom HITL-køen og føre til katastrofal skade. Løsningen er å kontrollere om svarene er konsistente. Generer tre svar på samme inndata.
Hvis to samsvarer, er konsistensen høy. Hvis alle tre er forskjellige, skal saken eskaleres til nivå 3 uansett modellens egen skår.
Se for deg en hypotetisk arbeidsflyt for skadeoppgjør der manipulerte inndata blåser opp konfidensen. Deterministisk validering, grenser for utbetaling, avviksdeteksjon og menneskelig godkjenning av høyrisikohandlinger bør hindre systemet i å behandle et stort parti automatisk. Test disse kontrollene med syntetiske tilfeller før du behandler reelle krav.
Hvis systemet henter ut et dollarbeløp, kontrollerer en regel at beløpet ligger innenfor historiske grenser. Kapasiteten til dem som gjennomgår sakene, er også begrenset. Derfor setter vi opp et dynamisk system for grenser.
Hvis ventetiden i køen for menneskelig gjennomgang overstiger 4 timer, hever systemet midlertidig grensen for automatisk utførelse til 97% og setter stikkprøvene på nivå 2 på pause. Det hindrer at kontrollørene drukner i eskaleringer med liten betydning.
Ved integrasjon med hendelsesstyrt arkitektur brukes Apache Kafka og Google Cloud PubSub som meldingsformidlere. Vi bruker dem mye. Når et dokument kommer inn i pipelinen, publiserer Kafka en hendelse.
KI-motoren for orkestrering abonnerer på hendelsen, behandler nyttelasten og publiserer resultatet. Ruting skjer automatisk. Ved lav konfidens sendes nyttelasten direkte til PubSub for umiddelbar menneskelig gjennomgang.
Brukere i virksomheten starter disse KI-arbeidsflytene via plattformer med lite eller ingen kode. Det er enkelt: En bruker laster opp en kontrakt i en portal, og plattformen sender en webhook til backend. Orkestreringsmotoren henter ut klausuler, sammenligner dem med standarder og returnerer en samlet risikoskår.
Slik blir teknologien nyttig i praksis. Når den underliggende API-kompleksiteten skjules, kan team uten teknisk kompetanse utføre avansert risikoanalyse uten å skrive en eneste linje kode.
Trinn 2: Beregn avkastning og sammenlign kostnadsreduksjoner fra pilot til produksjon
Det er en oppsiktsvekkende avkastning. Mål gjennomløpstid, arbeidskostnader, kostnader ved rettelser, modellbruk, tid til gjennomgang og hendelser ut fra definisjoner som økonomi- og driftsteamene kan stille seg bak. Å beregne avkastningen er en sentral del av gode metoder for å optimalisere KI-baserte arbeidsflyter.
Det skiller vellykkede utrullinger fra kostbare eksperimenter.
Bruk denne tabellen til å sammenligne kostnadsbesparelser:
| Bruksområde | Manuell kostnad | Kostnad med KI-orkestrering | Besparelse | Færre feil |
|---|---|---|---|---|
| Fakturabehandling | $3.70 / dokument | $1.20 / dokument | 67,6% | en betydelig andel |
| Kontraktsgjennomgang | $52.00 / kontrakt | $18.50 / kontrakt | 64,4% | 85% |
Se på et regneeksempel for fakturabehandling i stor skala. Anta et volum på 50 000 fakturaer. Den manuelle kostnaden er enkel å beregne: 50 000 ganger $3.70 er $185,000 per måned.
Så tar vi kostnadene ved automatisering. 50 000 ganger $1.20 for databehandling og menneskelig gjennomgang blir $60,000. I tillegg kommer $5,000 for API-tokens og $2,000 for hosting.
Regnestykket er enkelt. Den samlede kostnaden ved automatisering blir $67,000 per måned. Det gir en månedlig besparelse på $118,000 og en årlig besparelse på hele $1,416,000.
Omfanget er enormt. Og dette er ikke et enkeltstående tilfelle. Når du bruker slike metoder for optimalisering i en stor virksomhet, kan de samlede økonomiske gevinstene endre kostnadsstrukturen i driften vesentlig til det bedre.
Kalkulator for avkastning på KI-baserte arbeidsflyter
Beregn hvor mye du kan spare hver måned med KI-basert fakturaautomatisering.
En viktig innsikt: Hvorfor mislykkes 41% av prosjektene med KI-orkestrering i store virksomheter?
Prosjekter med KI-orkestrering i store virksomheter mislykkes fordi organisasjoner prøver å automatisere prosesser som ikke fungerer, uten først å måle utgangspunktet eller utforme arbeidsflytene på nytt. Det er en grunnleggende feil. Hele 41% av slike prosjekter når ikke de uttalte forretningsmålene innenfor opprinnelig tidsplan og budsjett, på grunn av feil prosessvalg og undervurdert integrasjonsarbeid.
Vi ser det stadig vekk. Hopper du over arbeidet med å forbedre prosessen, vil de dyre nye KI-verktøyene bare utføre de samme ineffektive stegene raskere.
KI-automatisering kan gi troverdige gevinster i den enkelte arbeidsflyten. Men avkastning for hele virksomheten avhenger av at du måler utgangspunktet, forbedrer arbeidsflyten, får løsningen tatt i bruk, sikrer styring og holder streng kontroll på kostnadene. Dårlige prosesser lar seg ikke reparere med automatisering.
Prøver du å automatisere en prosess som ikke fungerer, får du den bare til å feile raskere, samtidig som du bruker dyre databehandlingsressurser. Det er den harde sannheten. Vi nekter å rulle ut agenter i ustabile arbeidsflyter før kunden har kartlagt dagens prosess og utformet de nødvendige driftstrinnene på nytt for å oppnå reell effektivitet.
Hvis en prosess har en unntaksrate over 8%, bør du ikke automatisere den ennå. Forbedre prosessen først. Team velger ofte bruksområder med stor variasjon, slik at KI-en stadig må sende oppgaver videre til overbelastede medarbeidere.
Hvorfor gjør de det? Det er feil fremgangsmåte. Å beherske gode metoder for å optimalisere KI-baserte arbeidsflyter innebærer å godta at ikke alt bør settes i produksjon med en gang, uansett hva styret krever.
Årsaken til at dette går galt, er enkel matematikk. Når unntaksraten er høy, blir orkestreringssystemet i praksis bare et avansert system for å sende saker videre til mennesker. Du betaler for alt: API-tokens, databehandlingstid og køhåndtering for hver eneste transaksjon som går gjennom systemet.
Hvis KI-en prøver å behandle et komplisert krav, mislykkes og sender det videre til en medarbeider, tar behandlingen samlet sett vesentlig lengre tid enn om medarbeideren hadde håndtert kravet fra starten.
Vi vurderte et logistikkselskap på Fortune 500-listen som hadde forsøkt å automatisere behandlingen av fraktkrav. De valgte bruksområdet fordi verdien per transaksjon var høy. Men den skjulte ulempen er at høy verdi ofte betyr stor variasjon.
Den faktiske unntaksraten var 22%. Hvert transportselskap hadde egne dokumentasjonsformater og uoversiktlige e-postinnsendinger som forvirret modellen. KI-en brukte tokens på å tolke ustrukturerte e-posttråder, mislyktes og sendte sakene videre.
Det ble dyrt. Ventetiden fra det mislykkede KI-forsøket la 3 minutter til behandlingen av hvert krav og kostet selskapet $1.2M i ekstra driftsforsinkelser i løpet av seks måneder.
General Motors trakk seg på samme måte fra et prosjekt for helautomatisk ruting i forsyningskjeden i 2023. De oppdaget at variasjonen i leverandørenes dataformater presset unntaksraten over 30%. De måtte gå tilbake til et regelbasert system med KI-støtte for å håndtere de uforutsigbare unntakene.
Team velger verdifulle, kompliserte prosesser fordi prognosene i regnearket ser imponerende ut. Motstå fristelsen. Velg kjedelige, repetitive prosesser først.
Da kan du bygge tillit til driften og teknisk stabilitet før du tar fatt på prosessene med stor variasjon.
Vi bruker denne sjekklisten for å unngå fellene. Du må kontrollere at prosessens unntaksrate er under 8% før du skriver en eneste linje kode. - [ ] Kontroller at prosessens unntaksrate er under 8% - [ ] Fastsett utgangspunktet for kostnader og gjennomløpstid - [ ] Kartlegg integrasjonspunkter mot eldre systemer - [ ] Sikre støtte fra berørte parter til å utforme arbeidsflyten på nytt For oss er dette ufravikelig.
Hopper du over disse grunnleggende stegene, ruller du ut et system som tapper virksomheten for penger og frustrerer driftsteamet.
Lar du hypen styre utrullingsstrategien? Ikke gjør det. Velg de riktige oppgavene, mål utgangspunktet og forbedre arbeidsflyten før du i det hele tatt vurderer automatisering. Først da automatiserer du.
Hvordan overvåker du modelldrift og integrerer KI-motorer med eldre stormaskiner?
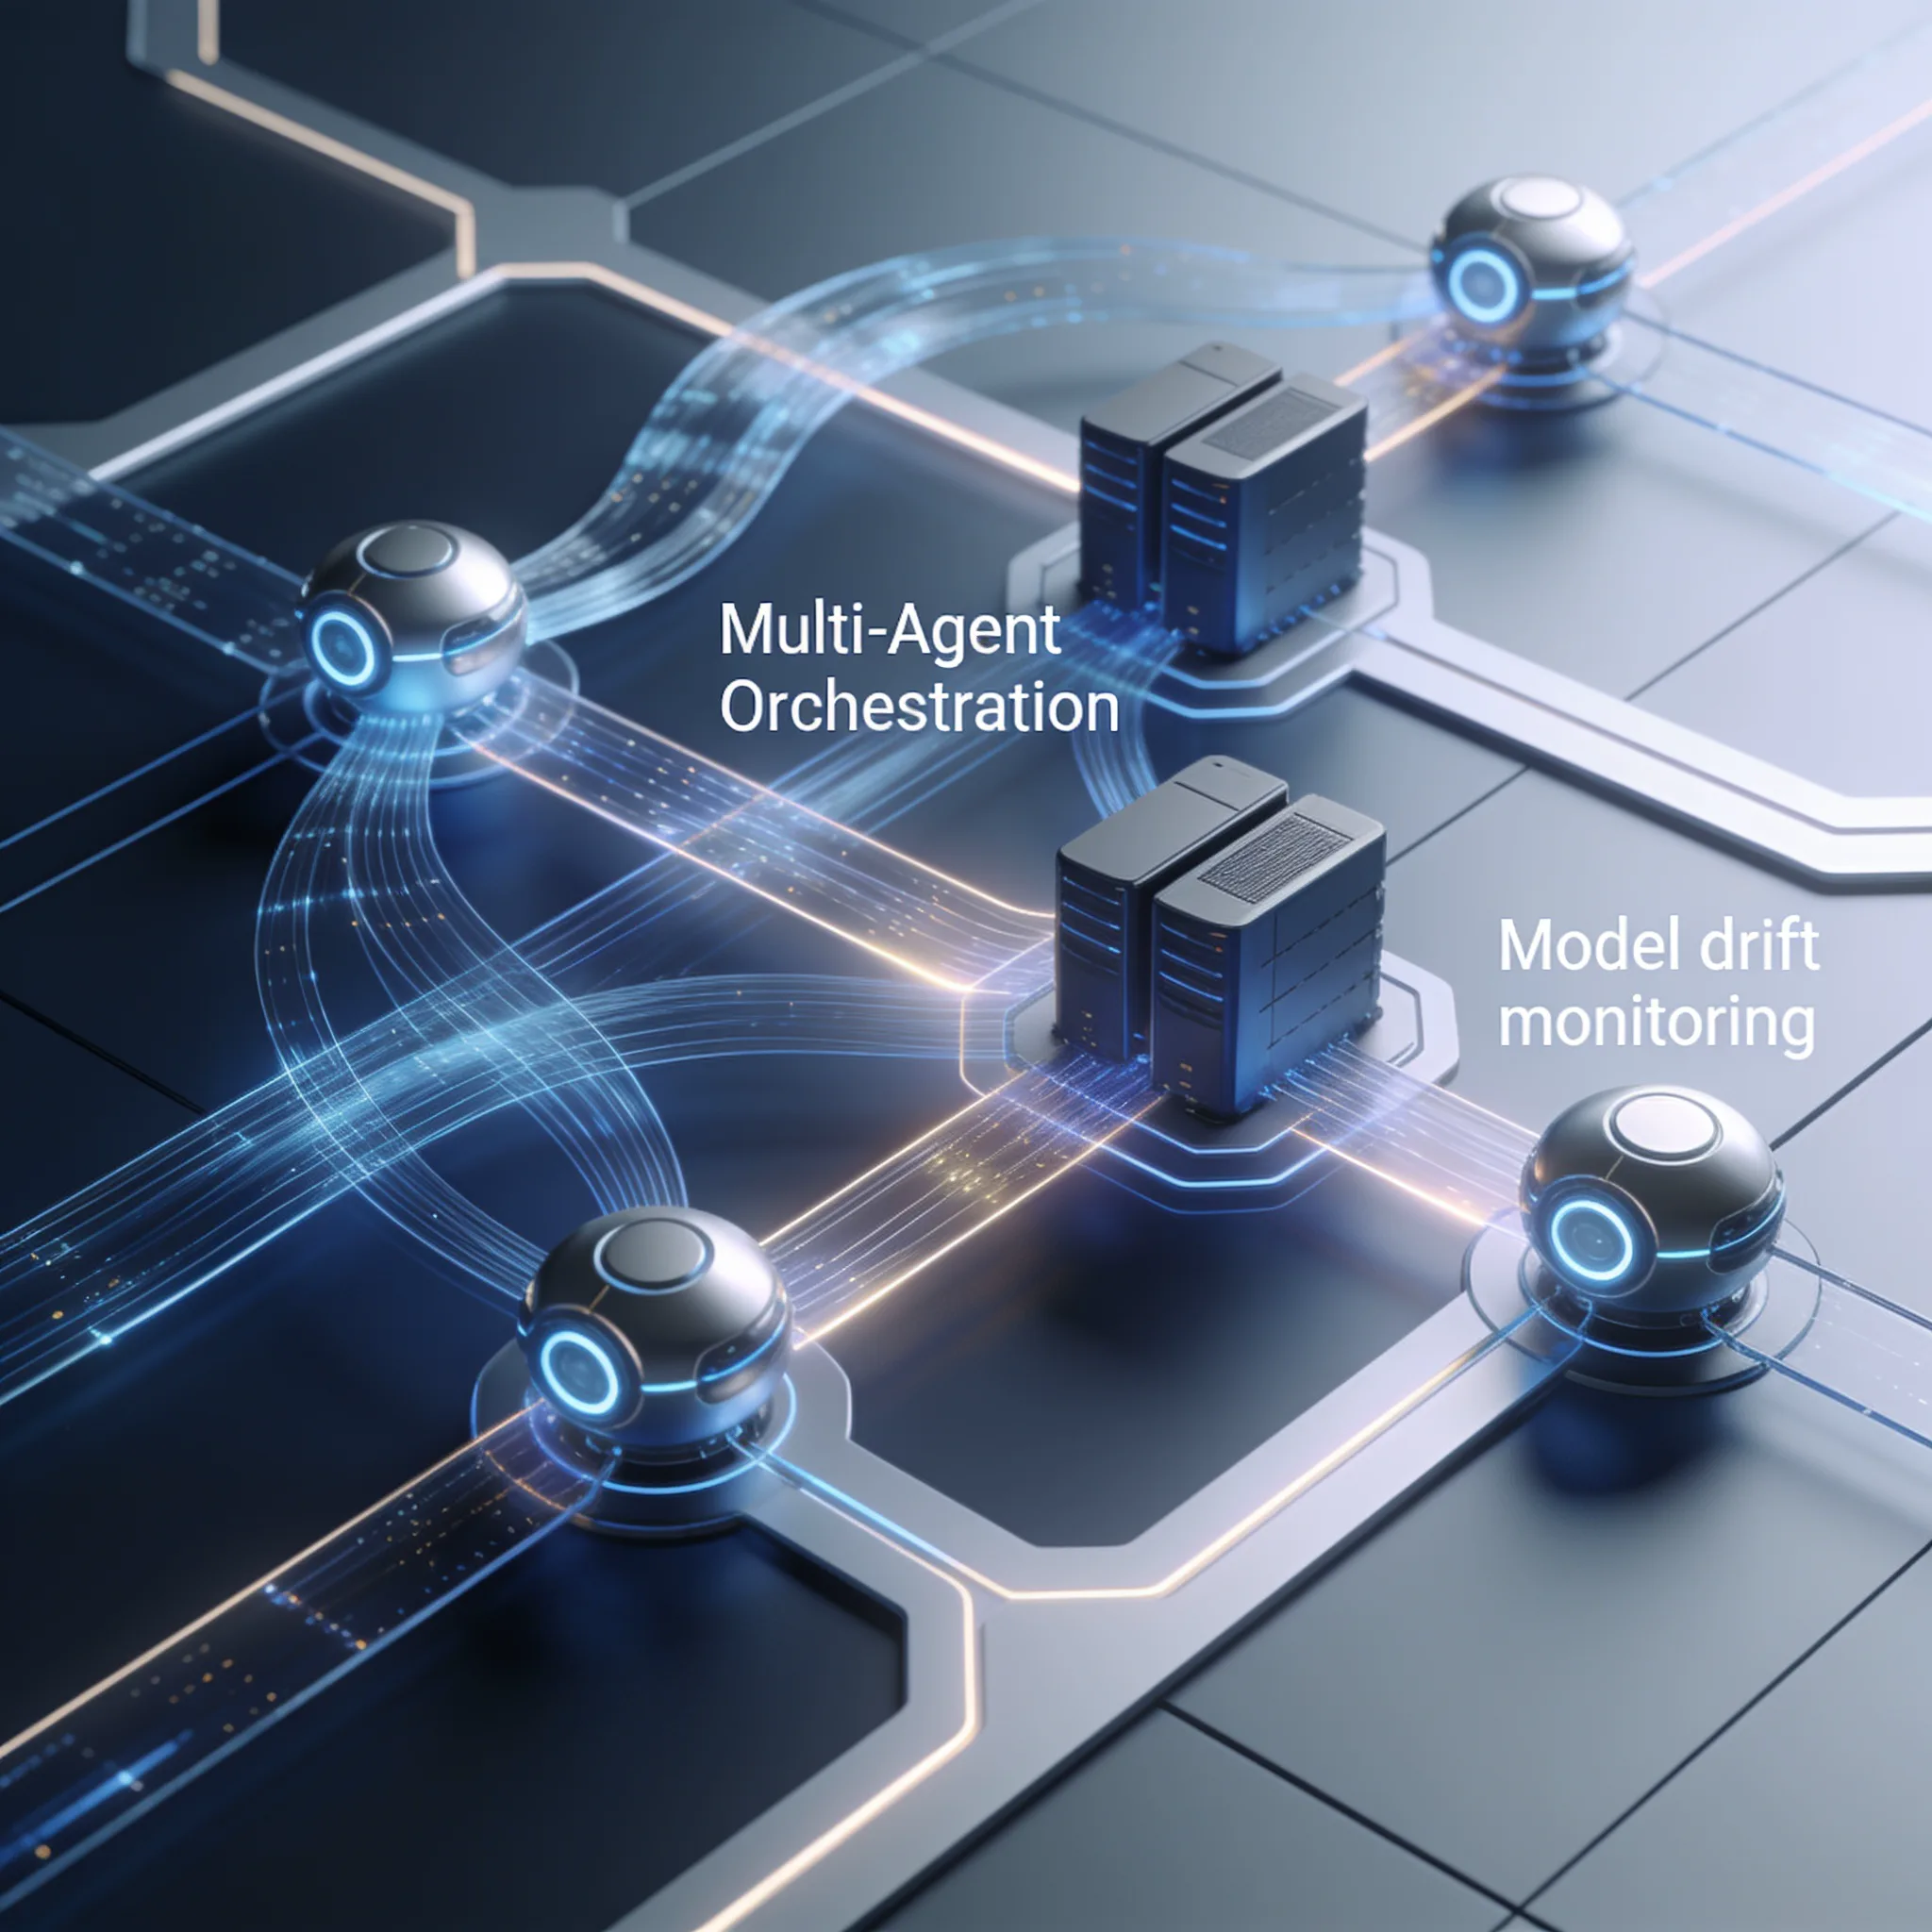
Du overvåker modelldrift ved å etablere datasett med fasitsvar og følge med på hvordan fordelingen av konfidensskårer endrer seg over tid. KI-motorer integrerer du med eldre stormaskiner ved hjelp av API-gatewayer og mellomvare som oversetter moderne JSON-data til formater de eldre terminalsystemene forstår. Følg med på modelldrift og tjenestenivå gjennom loggførte modellslutninger, utvalg med fasitsvar og varsler med en tydelig ansvarlig mottaker.
Skal du følge med på tjenestenivået i sanntid, må du loggføre forsinkelsen for hver modellslutning og varsle når terskelverdier overskrides. Avanserte metoder for å optimalisere KI-baserte arbeidsflyter krever at du følger systemets og modellens tilstand nøye og kontinuerlig.
Modelldrift kan raskt svekke treffsikkerheten. Du må hele tiden overvåke fordelingen i inndataene og konfidensintervallene i resultatene. Hvis en agent plutselig oppgir 40% sikkerhet for en oppgave den vanligvis løser med 95%, må du varsle umiddelbart.
Det er et tydelig faresignal. Overser du slike statistiske endringer, kan den automatiserte behandlingskjeden gradvis forurense dataene videre i systemet med overbevisende hallusinasjoner som ødelegger brukernes tillit.
Integrasjon med eldre stormaskiner er en betydelig teknisk utfordring. Men den kan løses. Bruk et egnet lag med mellomvare mellom moderne systemer for KI-orkestrering og eldre systemer som ikke kan behandle moderne JSON-data.
Riktig arkitektur er avgjørende. Med et godt oversettelseslag kan KI-agentene hente kontekst og skrive oppdateringer uten at du må endre kjernen i det eldre systemet.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Dette YAML-oppsettet oversetter moderne API-data til formater stormaskinen kan lese. Slik kan tjenestene kommunisere. KI-agenten kan hente kontekst og skrive oppdateringer uten å endre kjernen i det eldre systemet.
Det er en stor driftsfordel. Du slipper den betydelige risikoen og kostnaden ved å endre skjør, flere tiår gammel COBOL-kode som driver de mest kritiske banksystemene dine.
En endret fakturamal kan gi en fortsatt høy modellskår selv om en verdi havner i feil felt. Overvåk nøyaktigheten på feltnivå mot gjennomgåtte eksempler, oppdag endringer i fordelingen av inndata og stans behandlingen når valideringen mislykkes.
Stormaskinintegrasjon innebærer særskilte datarisikoer. Hvis pakkede desimaltall i COBOL konverteres til JSON-tall med flyttallspresisjon, kan det oppstå avrundingsfeil som bygger seg opp over mange transaksjoner. Bevar desimaltypene, avstem totalsummene og kjør den eksisterende beregningen parallelt før du behandler reelle finansdata.
Tallfest eventuelle avvik ut fra gjennomgåtte produksjonsdata, ikke et oppdiktet tapstall.
For å forhindre dette må du bygge et strengt lag i mellomvaren som bevarer desimaltypene. Parallellkjøring før full utrulling er obligatorisk. Send 5% av den reelle trafikken til den oppdaterte modellen, sammenlign resultatene med det eldre systemet og loggfør avvikene.
Så venter du. Først når feilraten faller under 0,5% og systemet har vist seg stabilt, kan modellen ta over hovedtrafikken.
Følg opp tjenestenivåene med tydelige definisjoner, logger og en ansvarlig for svekket ytelse. Produktivitetseksempler fra andre virksomheter sier ikke hva en annen arbeidsflyt vil oppnå.
Trinn 3: Hvilke bruksområder for arbeidsflytautomatisering egner seg best for produksjon?
Bruksområdene som egner seg best for automatisering i produksjon, er deterministiske prosesser med høyt volum, få unntak og klare rutiner for å sende saker videre til mennesker. Eksempler er fakturabehandling, ruting av kundehenvendelser og kontraktsanalyse. Vi velger utelukkende slike prosesser.
Det gir en tydelig fordel. Å velge de riktige bruksområdene er det siste steget i gode metoder for å optimalisere KI-baserte arbeidsflyter, og det bidrar til at plattformen fungerer også i praksis.
Mål hvor mange pilotprosjekter som når produksjon før du utvider utrullingen. Produksjonssetting krever strenge sikkerhetsmekanismer i plattformen. Men det er fullt mulig.
Med grundige testprotokoller og god logikk for reservehåndtering kan du bli blant de få selskapene som faktisk oppnår målbar avkastning på KI-investeringene sine.
Vi bruker denne beslutningsmatrisen til å velge bruksområder målrettet. Den fjerner gjettingen.
| Kriterium | Fakturabehandling | Kontraktsgjennomgang | Sortering av e-post |
|---|---|---|---|
| Volum | Høyt | Middels | Høyt |
| Unntaksrate | Lav | Middels | Høy |
| Tilbakebetalingstid | 9,8 måneder | 14,2 måneder | 18+ måneder |
| Integrasjonskompleksitet | Lav | Høy | Middels |
Når du velger de riktige prosessene, blir tilbakebetalingstiden betydelig kortere. Det frigjør kapital til neste runde med automatisering.
Et system i produksjon trenger overvåking, varsling og logikk for reservehåndtering. Uten unntak. Hvis KI-motoren svikter, må systemet gå over til manuell behandling uten å miste hendelsen eller ødelegge data.
Det er et absolutt krav. Vi utformer hver behandlingskjede for orkestrering med automatiske rutiner for redusert drift som sikrer null datatap, selv ved alvorlige utfall i infrastrukturen.
Konklusjon: Slik øker du effektiviteten i virksomheten med KI-automatisering
Skal virksomheter bli mer effektive med KI, trenger de avanserte teknikker for å optimalisere arbeidsflyt med KI-automatisering. Dette kan ikke gjøres på liksom. Organisasjoner må kombinere ambisiøse mål for automatisering med kompromissløs kontroll over driften i alle avdelinger.
Uten den balansen risikerer de å havne blant de 41% som mislykkes. Det kan også ødelegge karrierer. Setter du fart foran stabilitet, ender du med sårbare systemer som bryter sammen ved høy belastning og undergraver ledelsens tillit til den tekniske strategien din.
Det krever disiplin. Menneskelig kontroll underveis, hendelsesstyrte datapipelines og grundig måling mot et utgangspunkt er nødvendig for å hindre løpske kostnader og fallende treffsikkerhet. Ikke automatiser prosesser som ikke fungerer.
Det er den verste feilen du kan gjøre. Rett opp selve arbeidsflyten først, så kan KI-verktøyene gi den eksponentielle avkastningen som forsvarer den store kapitalinvesteringen.
Overgangen fra regelbasert RPA til dynamisk KI-orkestrering er fullført. De gamle metodene hører fortiden til. Virksomheter som mestrer disse integrasjonsteknikkene, vil dominere markedene sine.
De som overser rammene for trygg drift, vil raskt bruke opp kapitalen. Det garanterer vi. Valget er ditt: Bygg evnen til disiplinert orkestrering nå, eller se konkurrentene bruke KI til systematisk å ta markedsandeler fra deg.
Slik fungerer teknikker for å optimalisere arbeidsflyt med KI-automatisering i praksis.
Aktuelle Claude-, GPT-, Gemini- og Grok-modeller, opptil 75 % under listepris
Én API-nøkkel til modellene fra Claude, GPT, Gemini og Grok via OpenAI SDK. Claude-modellene fungerer også med Anthropic SDK og Claude Code.
Prisen for hver modell via AIGROW-kreditt ligger ved siden av utviklerens listepris, aldri over den.
Ofte stilte spørsmål
