L’AI in azienda funziona quando i modelli isolati lasciano spazio a flussi di lavoro orchestrati, nei quali le persone continuano a intervenire. Se realizzata correttamente, l’orchestrazione riduce del 43% i tempi dei processi e del 90% il tasso di errore. Questa guida illustra l’architettura, i controlli necessari per operare in sicurezza e le misure con cui valutare i risultati su larga scala.
Sviluppi con modelli AI? Il credito API AIGROW ti permette di usare i modelli Claude, GPT, Gemini e Grok fino al 75% sotto il prezzo di listino.
- L’orchestrazione è utile quando un flusso di lavoro prevede stati, dipendenze, tentativi successivi e passaggi con responsabilità definite. Introduce però anche possibili errori da verificare con i test.
- Scegli il modello di coordinamento più semplice che riesca a gestire il processo e definisci un limite ai passaggi, timeout, responsabilità e procedure di escalation.
- Definisci le soglie di revisione in base ai risultati delle valutazioni e ai rischi aziendali, anziché adottare un punteggio di affidabilità generico.
- Misura il lavoro completato, il tasso di correzione, i tempi di ripristino, il costo totale e gli incidenti usando definizioni coerenti nel tempo.
Introduzione: il passaggio all’orchestrazione dei flussi di lavoro AI
Il mercato è cambiato completamente. L’adozione è ormai la norma: il 66% delle organizzazioni ha implementato qualche forma di automazione dei flussi di lavoro. È una tendenza innegabile.
Le moderne architetture di riferimento combinano agenti AI, pipeline basate su eventi e controlli di qualità con supervisione umana per gestire attività operative complesse. Il settore ha abbandonato del tutto la RPA statica. L’automazione AI dinamica elabora le informazioni molto più rapidamente e si adatta anche ai casi particolari che manderebbero in errore gli script tradizionali.
Le regole statiche appartengono al passato. Applicare tecniche efficaci di ottimizzazione dei flussi di lavoro con l’AI richiede però un rigoroso controllo operativo, affinché l’elaborazione dinamica rimanga accurata anche su insiemi di dati aziendali diversi e imprevedibili.
Per iniziare, usa questa lista di controllo:
- [ ] Rileva lo stato attuale del processo come riferimento
- [ ] Definisci le soglie per la gestione delle eccezioni
- [ ] Scegli il framework di orchestrazione
- [ ] Configura i trigger basati su eventi
- [ ] Porta in produzione il primo caso d’uso
L’orchestrazione dei flussi di lavoro coordina in modo sistematico agenti AI e controlli di qualità umani
L’orchestrazione coordina agenti, trigger basati su eventi, servizi deterministici e revisione umana lungo un processo. Valutala in base al lavoro completato, al tasso di correzione, ai tempi di ripristino, ai costi operativi e agli incidenti, usando definizioni condivise con il team operativo.
L’orchestrazione diventa utile quando un flusso di lavoro presenta dipendenze, tentativi successivi, stati e più passaggi con responsabilità definite. Mettila alla prova con input imprevisti e servizi non disponibili per capire se migliora il ripristino o aggiunge soltanto complessità.
Serve una struttura. Il framework LangChain distingue esplicitamente cinque principali modelli di orchestrazione multiagente, oggi usati negli ambienti di produzione per gestire attività operative complesse e ad alto rischio: * Router: Un agente centrale indirizza le attività a sottoagenti specializzati in base all’intento. * Supervisor: In un modello gerarchico, un agente supervisore assegna le attività e convalida i risultati.
* Network: Gli agenti comunicano tra loro e si assegnano dinamicamente le attività. * Hierarchical: La delega avviene su più livelli: i responsabili assegnano le attività agli esecutori e poi ne aggregano i risultati. * Custom/Graph: Flussi di lavoro basati su macchine a stati definiscono con precisione la logica di transizione tra agenti.
Nel modello Network, gli agenti possono continuare a passarsi la stessa attività senza uscire dal ciclo di delega. Per evitarlo, imposta un limite ai passaggi, rileva le attività duplicate e definisci regole di responsabilità, timeout e un percorso di escalation. Prima della messa in produzione, verifica questi controlli simulando dei guasti.
Un modello gerarchico può sostenere un processo complesso come la valutazione di una richiesta di prestito: gli agenti esecutori raccolgono le prove e un componente responsabile ne combina i risultati. In un ipotetico caso di errore, il componente responsabile riceve dati discordanti sul credito e sul reddito, ma non dispone di una regola deterministica per risolvere il conflitto o avviare un’escalation. Prima di usare questo modello per decisioni reali, verifica come gestisce conflitti, documenti mancanti, timeout e azioni negate.
Quando due agenti esecutori hanno restituito rapporti debito/reddito discordanti, il componente responsabile ha impiegato 45 secondi per esaminare la discrepanza, portando la latenza dai 2 secondi attesi a livelli del tutto inaccettabili. Spesso si tende a scegliere il modello più avanzato, senza considerare che la complessità rende il debug esponenzialmente più difficile. Consigliamo vivamente di iniziare dal modello Supervisor: permette di delegare in modo controllato senza il rischio di cicli infiniti del modello Network.
Integriamo questi modelli direttamente con un’architettura basata su eventi. Per sviluppare una logica affidabile degli strumenti, occorre collegare il framework di orchestrazione ai trigger webhook che avviano e monitorano ogni flusso automatizzato. Ecco il formato standard del payload che usiamo per avviare un flusso orchestrato.
Funziona alla perfezione. Standardizzare la struttura JSON in tutte le pipeline riduce notevolmente gli attriti di integrazione e facilita il debug per i team di ingegneria.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Questa struttura JSON fornisce al motore AI sia l’attività sia i parametri di governance necessari. Se l’affidabilità scende sotto 0.85, il sistema invia il caso a una coda di revisione umana. Il controllo qualità è così garantito senza bloccare l’intera pipeline: la capacità di elaborazione resta invariata e i vincoli operativi vengono rispettati.
Le giuste tecniche di ottimizzazione dei flussi di lavoro con l’AI fanno sì che le persone più costose per l’azienda dedichino il proprio tempo soltanto ai casi particolari di maggiore impatto, anziché all’estrazione ordinaria dei dati.
Sentiamo spesso un’obiezione: secondo i team operativi, l’orchestrazione introduce una latenza inaccettabile nelle pipeline che elaborano transazioni critiche. Ma è un falso problema. Se configurate correttamente, le pipeline basate su eventi riducono il tempo complessivo dei processi, eliminando i passaggi manuali e le fasi intermedie superflue.
Passaggio 1: progettare la logica di escalation con supervisione umana per le pipeline basate su eventi
Progettare la logica di escalation con supervisione umana (HITL) significa associare soglie di affidabilità rigorose a livelli specifici di revisione. È un passaggio irrinunciabile. I potenziali benefici economici sono enormi.
Stabilisci dove finisce l’automazione e inizia la revisione umana. Le soglie devono tenere conto del rischio dell’azione, della sua reversibilità, dell’affidabilità e degli obblighi normativi, per poi essere convalidate con casi di errore rappresentativi.
- Livello 1: esecuzione automatica. Affidabilità > 95%. Nessuna revisione umana.
- Livello 2: controllo a campione. Affidabilità da 80 a 95%. Verifica casuale del 10% dei casi.
- Livello 3: revisione obbligatoria. Affidabilità < 80%. Tutti i casi passano alla coda HITL.
Basare queste soglie soltanto sul valore prodotto da un LLM è un grave errore. La calibrazione dei modelli è spesso scarsa. Un LLM potrebbe dichiarare un’affidabilità del 99% anche in presenza di una prompt injection malevola nascosta in un contratto caricato, aggirando completamente la coda HITL e causando danni catastrofici.
Per evitarlo, introduci verifiche di coerenza: genera tre risposte per lo stesso input. Se due coincidono, considera alta l’affidabilità. Se tutte e tre sono diverse, imponi il passaggio al Livello 3 indipendentemente dal punteggio interno.
Considera un’ipotetica pipeline di gestione dei sinistri in cui input avversari gonfiano il punteggio di affidabilità. Convalida deterministica, limiti agli indennizzi, rilevamento delle anomalie e approvazione umana per le azioni ad alto rischio devono impedire al sistema di elaborare automaticamente un grande lotto di pratiche. Verifica questi controlli con casi sintetici prima di gestire sinistri reali.
Se il sistema estrae un importo in dollari, un controllo basato su regole verifica che rientri nei limiti storici. Inoltre, la capacità dei revisori umani è limitata. Per questo configuriamo un sistema di soglie dinamiche.
Se il tempo di attesa nella coda di revisione supera le 4 ore, il sistema alza temporaneamente al 97% la soglia per l’esecuzione automatica e sospende i controlli a campione del Livello 2. Si evita così che i revisori siano sommersi da escalation di scarso impatto.
Le tecniche di integrazione per le architetture basate su eventi impiegano Apache Kafka e Google Cloud PubSub come broker di messaggi. Li usiamo ampiamente. Quando un documento entra nella pipeline, Kafka pubblica l’evento; il motore di orchestrazione AI lo riceve, elabora il payload e pubblica il risultato.
L’instradamento è automatico. Se l’affidabilità è bassa, il sistema invia il payload direttamente a PubSub per una revisione umana immediata.
Gli utenti aziendali avviano questi flussi AI tramite piattaforme no-code e low-code. È molto semplice: una persona carica un contratto su un portale e la piattaforma invia un webhook al backend. Il motore di orchestrazione estrae le clausole, le confronta con gli standard e restituisce una valutazione completa del rischio.
La tecnologia diventa così davvero utile. Nascondendo la complessità delle API sottostanti, permetti ai team non tecnici di svolgere analisi del rischio avanzate senza scrivere una riga di codice.
Passaggio 2: calcolare il ROI e confrontare la riduzione dei costi dal progetto pilota alla produzione
È un ritorno notevole. Misura i tempi di lavorazione, il lavoro impiegato, i costi delle correzioni, l’utilizzo dei modelli, i tempi di revisione e gli incidenti, usando definizioni condivise dai team finanziari e operativi. Calcolare il ROI è una parte essenziale delle tecniche di ottimizzazione dei flussi di lavoro con l’automazione AI: è ciò che distingue le implementazioni riuscite dai costosi progetti sperimentali.
Usa questa tabella per confrontare le riduzioni dei costi:
| Caso d’uso | Costo manuale | Costo con orchestrazione AI | Risparmio | Riduzione degli errori |
|---|---|---|---|---|
| Elaborazione delle fatture | $3.70 / documento | $1.20 / documento | 67,6% | una percentuale significativa |
| Revisione dei contratti | $52.00 / contratto | $18.50 / contratto | 64,4% | 85% |
Considera un esempio di elaborazione delle fatture su larga scala. Supponiamo di gestire 50.000 fatture. Il costo manuale è semplice da calcolare: 50.000 moltiplicato per $3.70 dà $185,000 al mese.
Vediamo i costi dell’automazione. Moltiplichi 50.000 per $1.20, il costo di elaborazione e revisione umana, e ottieni $60,000. Aggiungi poi $5,000 per i token API e $2,000 per l’hosting.
Il calcolo è semplice: il costo totale dell’automazione è $67,000 al mese. Risparmi quindi $118,000 al mese, pari a ben $1,416,000 all’anno.
Sono cifre enormi, e non si tratta di un caso isolato. Applicati a una grande azienda, questi metodi di ottimizzazione producono effetti finanziari cumulativi che migliorano in modo sostanziale la struttura dei costi operativi.
Calcolatore del ROI dei flussi di lavoro AI
Calcola il risparmio mensile ottenuto automatizzando le fatture con l’AI.
Un dato poco noto: perché il 41% dei progetti aziendali di orchestrazione AI fallisce?
I progetti aziendali di orchestrazione AI falliscono perché le organizzazioni cercano di automatizzare processi che non funzionano, senza prima misurarne le prestazioni o riprogettare i flussi di lavoro. È un errore decisivo. Ben il 41% dei progetti aziendali di orchestrazione AI non raggiunge gli obiettivi di business dichiarati nei tempi e nel budget inizialmente previsti, a causa di errori nella scelta dei processi e di una sottovalutazione delle integrazioni.
Lo vediamo di continuo. Se salti la riprogettazione dei processi, i tuoi nuovi e costosi strumenti AI si limiteranno ad accelerare le inefficienze esistenti.
L’automazione AI può portare miglioramenti concreti nei singoli flussi di lavoro. Ma il ROI a livello aziendale dipende dalla misurazione delle prestazioni iniziali, dalla riprogettazione dei flussi, dall’adozione, dalla governance e da una rigorosa disciplina dei costi. L’automazione non aggiusta un processo difettoso: lo fa fallire più in fretta, consumando costose risorse di calcolo.
È una realtà da affrontare. Non implementiamo agenti su flussi di lavoro instabili finché il cliente non ha mappato il processo attuale e riprogettato i passaggi operativi necessari per renderlo davvero efficiente.
Se un processo ha un tasso di eccezioni superiore all’8%, non automatizzarlo ancora. Riprogettalo prima. Spesso i team scelgono casi d’uso molto variabili, e l’AI finisce per passare continuamente i compiti a operatori umani già sovraccarichi.
Perché farlo? È l’approccio sbagliato. Padroneggiare le tecniche di ottimizzazione dei flussi di lavoro con l’automazione AI significa accettare che non tutto debba andare subito in produzione, qualunque cosa chieda il consiglio di amministrazione.
Il meccanismo di questo fallimento è una questione di matematica. Con un tasso di eccezioni elevato, l’orchestratore diventa poco più di uno strumento che smista il lavoro alle persone. E tu paghi ogni passaggio: token API, tempo di calcolo e gestione delle code per ogni singola transazione.
Se l’AI prova a elaborare un reclamo complesso, fallisce e lo passa a una persona, il tempo totale di lavorazione diventa molto più lungo rispetto a un intervento umano fin dall’inizio.
Abbiamo valutato una società di logistica Fortune 500 che aveva tentato di automatizzare la valutazione dei reclami relativi al trasporto merci. Aveva scelto questo caso d’uso per l’alto valore di ogni transazione. Il compromesso meno evidente è che a un valore elevato corrisponde spesso un’elevata variabilità.
Il tasso effettivo di eccezioni era del 22%. Ogni vettore usava formati personalizzati per la documentazione e inviava email disordinate che confondevano il modello. L’AI consumava token cercando di interpretare conversazioni email non strutturate, poi falliva e passava il caso a una persona.
Un fallimento costoso: il tentativo non riuscito dell’AI aggiungeva 3 minuti a ogni reclamo e, nell’arco di sei mesi, ha causato all’azienda $1.2M di costi aggiuntivi dovuti ai ritardi operativi.
Anche General Motors ha fatto un passo indietro rispetto a un progetto di instradamento della catena di approvvigionamento completamente automatizzato nel 2023. L’azienda ha scoperto che la variabilità dei formati dei dati dei fornitori faceva superare il 30% al tasso di eccezioni. Ha quindi dovuto tornare a un sistema basato su regole, affiancato da un livello di assistenza AI per gestire i casi limite imprevedibili.
I team scelgono processi complessi e di alto valore perché le proiezioni nei fogli di calcolo promettono risultati enormi. Resisti a questa tentazione. Parti dai processi ripetitivi e prevedibili per costruire fiducia operativa e stabilità tecnica, prima di affrontare quelli con un’elevata variabilità.
Usiamo questa lista di controllo per evitare tali errori. Prima di scrivere una sola riga di codice, verifica che il tasso di eccezioni del processo sia inferiore all’8%. - [ ] Verifica che il tasso di eccezioni del processo sia inferiore all’8% - [ ] Definisci i valori iniziali di costo e tempi di lavorazione - [ ] Mappa i punti di integrazione con i sistemi legacy - [ ] Ottieni il sostegno delle parti interessate alla riprogettazione del flusso di lavoro Per noi sono condizioni imprescindibili.
Se salti questi passaggi fondamentali, metterai in produzione un sistema che consuma capitale e frustra il team operativo.
Stai lasciando che sia l’entusiasmo per l’AI a guidare la tua strategia di implementazione? Non farlo. Scegli le attività giuste, misura la situazione iniziale e riprogetta il flusso prima ancora di pensare all’automazione. Solo allora automatizza.
Come monitorare il drift dei modelli e integrare i motori AI con i mainframe legacy?
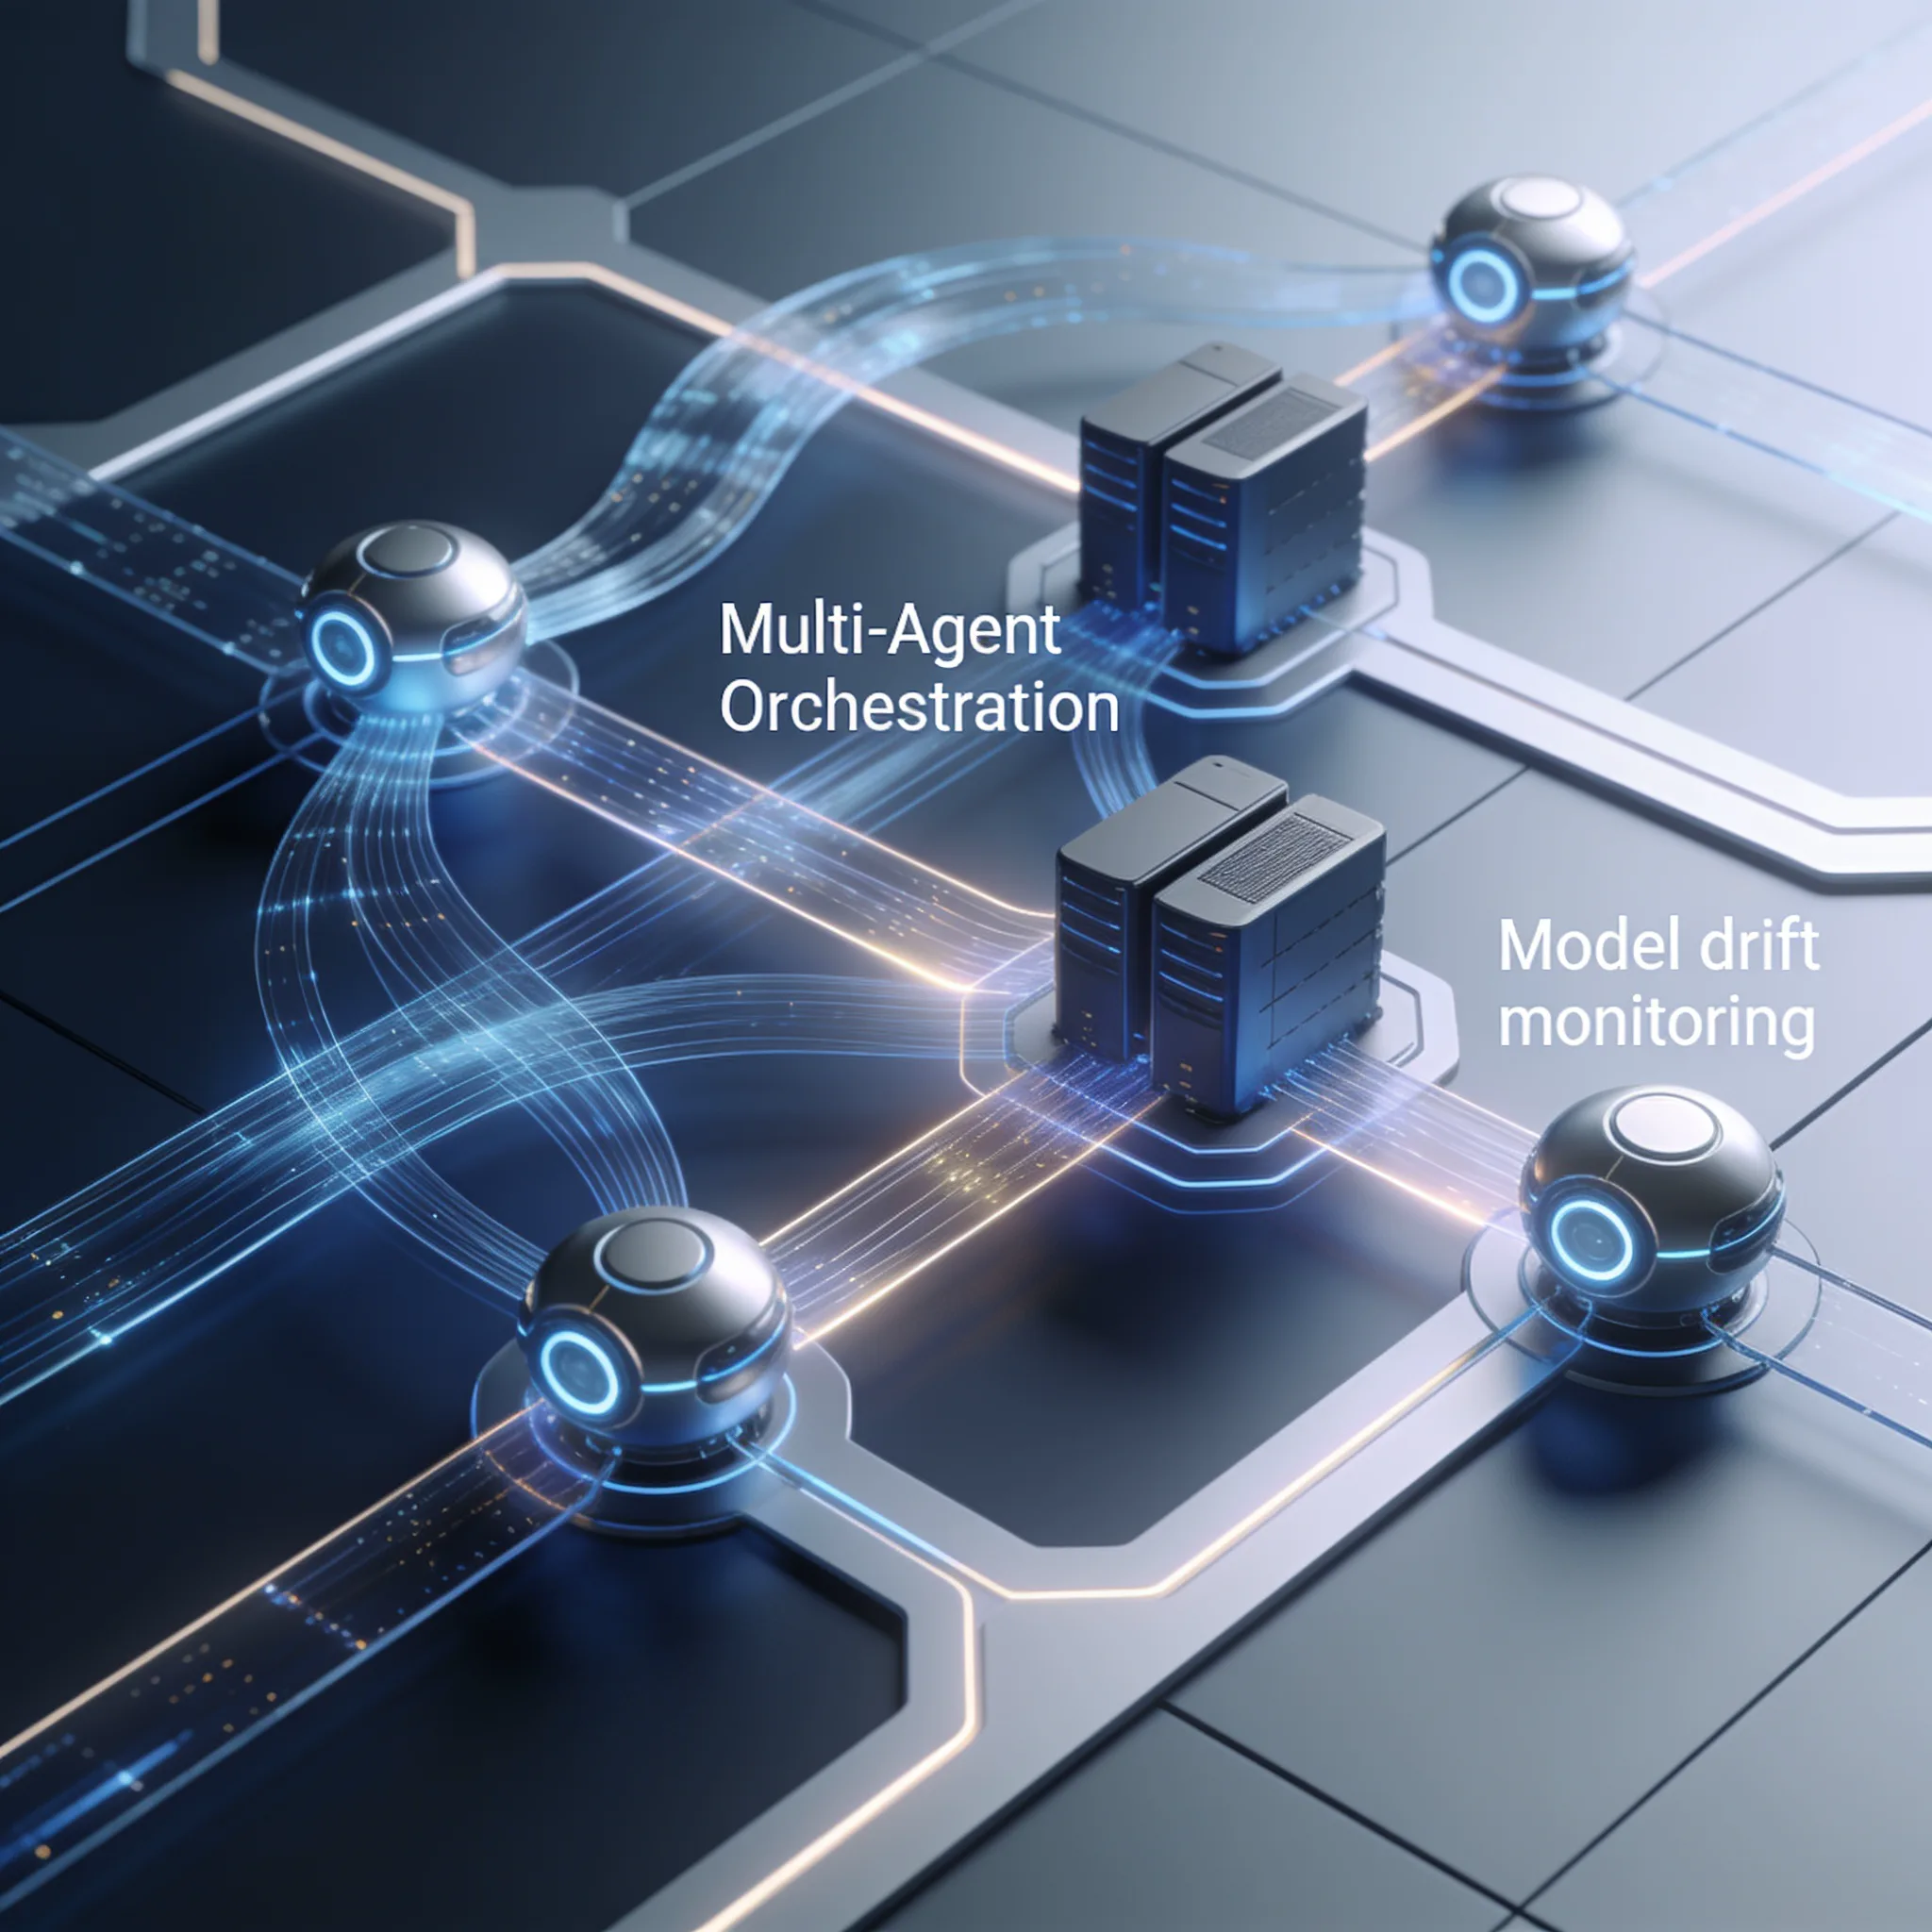
Per monitorare il drift dei modelli, definisci dataset di riferimento verificati e osserva nel tempo la distribuzione dei punteggi di confidenza. Per integrare i motori AI con i mainframe legacy, usa gateway API e middleware che convertono i payload JSON moderni nei formati dei vecchi terminali. Tieni sotto controllo il drift e i livelli di servizio attraverso dati di inferenza registrati, campioni verificati e avvisi affidati a un responsabile preciso.
Per monitorare gli SLA in tempo reale, registra la latenza di ogni inferenza e invia un avviso quando supera le soglie. Le tecniche avanzate di ottimizzazione dei flussi di lavoro con l’automazione AI richiedono un controllo costante dello stato del sistema e dei modelli.
Il drift può ridurre rapidamente l’accuratezza. Monitora costantemente la distribuzione dei dati in ingresso e gli intervalli di confidenza dei risultati. Se un agente restituisce all’improvviso una confidenza del 40% per un’attività che di solito gestisce al 95%, segnala subito il problema.
È un chiaro campanello d’allarme. Ignorare questi cambiamenti statistici significa rischiare che la pipeline automatizzata contamini gradualmente i dati a valle con allucinazioni espresse con sicurezza, minando la fiducia degli utenti.
L’integrazione con i mainframe legacy è una sfida tecnica seria, ma risolvibile. Usa un livello middleware adeguato per collegare i moderni motori di orchestrazione AI ai sistemi più vecchi, incapaci di elaborare payload JSON moderni. L’architettura conta.
Con un livello di conversione ben progettato, gli agenti AI possono recuperare informazioni di contesto e scrivere aggiornamenti senza modificare il nucleo del sistema legacy.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Questa configurazione YAML converte i payload delle API moderne in formati leggibili dal mainframe e permette ai servizi di comunicare. L’agente AI può recuperare informazioni di contesto e scrivere aggiornamenti senza modificare il nucleo del sistema legacy. È un importante vantaggio operativo: eviti i rischi e i costi enormi di intervenire su fragile codice COBOL vecchio di decenni, da cui dipendono i sistemi bancari più critici.
Un modello può mantenere un punteggio elevato anche quando un nuovo modello di fattura fa finire un valore nel campo sbagliato. Monitora l’accuratezza dei singoli campi confrontandola con campioni revisionati, rileva i cambiamenti nella distribuzione dei dati in ingresso e interrompi l’elaborazione quando la validazione fallisce.
L’integrazione con i mainframe comporta rischi specifici per i dati. Convertire i decimali packed di COBOL in valori JSON a virgola mobile può introdurre errori di arrotondamento che si accumulano su molte transazioni. Mantieni i tipi decimali, riconcilia i totali e confronta in parallelo i calcoli con quelli del sistema esistente prima di elaborare dati finanziari reali.
Quantifica gli eventuali scostamenti sulla base di record di produzione revisionati, non di una cifra di perdita inventata.
Per evitarlo, devi creare nel middleware un livello rigoroso che preservi i tipi decimali. Le implementazioni parallele sono obbligatorie. Invia il 5% del traffico reale al modello aggiornato, confronta i risultati con quelli del sistema legacy e registra le discrepanze.
Poi attendi. Promuovi il modello al traffico principale solo quando il tasso di errore scende sotto lo 0,5% e il sistema dimostra di essere stabile.
Monitora i livelli di servizio con definizioni esplicite, log e un responsabile degli interventi in caso di prestazioni degradate. Gli esempi esterni di produttività non dimostrano quali risultati otterrà un flusso di lavoro diverso.
Passaggio 3: quali flussi di lavoro conviene automatizzare e mettere in produzione?
I casi d’uso migliori da mettere in produzione sono processi ad alto volume, con poche eccezioni e risultati deterministici, che prevedono percorsi chiari per il passaggio a un operatore umano. Alcuni esempi sono l’elaborazione delle fatture, lo smistamento delle richieste dei clienti e l’analisi dei contratti. Selezioniamo solo casi con queste caratteristiche.
È un vantaggio concreto. La scelta dei casi d’uso è il passaggio finale delle tecniche di ottimizzazione dei flussi di lavoro con l’automazione AI: serve a garantire che la piattaforma regga alla prova dei fatti.
Prima di estendere l’implementazione, misura quanti progetti pilota arrivano in produzione. Il passaggio alla produzione richiede rigorose misure di controllo della piattaforma, ma è del tutto possibile. Con protocolli di test rigorosi e una logica di fallback adeguata, puoi entrare nel gruppo ristretto di aziende che ottengono rendimenti misurabili dai propri investimenti nell’AI.
Usiamo questa matrice decisionale per selezionare i casi d’uso con criteri rigorosi. Elimina le supposizioni.
| Criterio | Elaborazione delle fatture | Revisione dei contratti | Smistamento delle email |
|---|---|---|---|
| Volume | Alto | Medio | Alto |
| Tasso di eccezioni | Basso | Medio | Alto |
| Tempo di ritorno dell’investimento | 9,8 mesi | 14,2 mesi | Oltre 18 mesi |
| Complessità dell’integrazione | Bassa | Alta | Media |
Puntando sui processi giusti, riduci drasticamente il tempo necessario a recuperare l’investimento e liberi risorse per finanziare le successive iniziative di automazione.
Un sistema in produzione ha bisogno di monitoraggio, avvisi e logica di fallback. Senza eccezioni. Se il motore AI si guasta, il sistema deve passare all’elaborazione umana senza perdere l’evento né alterare i dati.
È un requisito imprescindibile. Progettiamo ogni pipeline di orchestrazione con procedure automatiche di funzionamento degradato che garantiscono la totale assenza di perdita di dati, anche in caso di gravi interruzioni dell’infrastruttura.
Conclusione: aumentare l’efficienza aziendale su larga scala con l’automazione AI
Per aumentare l’efficienza aziendale con l’AI servono tecniche avanzate di ottimizzazione dei flussi di lavoro tramite automazione AI. Non ci sono scorciatoie. Le aziende devono conciliare obiettivi di automazione ambiziosi con un rigoroso controllo operativo in ogni reparto.
Se trascuri questo equilibrio, rischi di finire tra il 41% dei progetti che falliscono. E di compromettere la tua carriera. Quando privilegi la velocità rispetto alla stabilità, finisci per implementare sistemi fragili che cedono nei momenti di picco e minano la fiducia dei dirigenti nella tua strategia tecnica.
Serve disciplina: una logica che preveda l’intervento umano, pipeline basate sugli eventi e un monitoraggio meticoloso dei valori di riferimento per evitare costi fuori controllo e cali di accuratezza. Non automatizzare processi che non funzionano. È l’errore peggiore che puoi fare.
Se prima sistemi il flusso di lavoro alla base, i tuoi strumenti AI potranno generare i ritorni esponenziali necessari a giustificare un investimento così ingente.
Il passaggio dalla RPA basata su regole all’orchestrazione dinamica dell’AI è ormai compiuto. I vecchi metodi sono superati. Le aziende che padroneggiano queste tecniche di integrazione domineranno i loro mercati; quelle che ignorano le misure di controllo operativo consumeranno rapidamente il capitale.
Lo garantiamo. A te la scelta: sviluppare ora una capacità di orchestrazione disciplinata o lasciare che i concorrenti usino l’AI per erodere sistematicamente la tua quota di mercato. Ecco cosa significano, nella pratica, le tecniche di ottimizzazione dei flussi di lavoro tramite automazione AI.
Modelli Claude, GPT, Gemini e Grok attuali, fino al 75% sotto il prezzo di listino
Un'unica chiave API per i modelli Claude, GPT, Gemini e Grok sull'SDK di OpenAI. I modelli Claude funzionano anche con l'SDK di Anthropic e con Claude Code.
La tariffa di ogni modello tramite il credito AIGROW è indicata accanto al prezzo di listino del suo produttore e non lo supera mai.
Domande frequenti
