La IA empresarial funciona cuando los modelos aislados dan paso a flujos de trabajo orquestados en los que las personas siguen participando. Si se hace bien, la orquestación reduce los tiempos de ciclo de los procesos un 43% y las tasas de error un 90%. Esta guía explica la arquitectura, los controles que la mantienen segura y cómo medir si ha escalado.
¿Desarrollas con modelos de IA? El crédito de API de AIGROW ejecuta modelos de Claude, GPT, Gemini y Grok hasta un 75% por debajo del precio de lista.
- La orquestación resulta útil cuando un flujo de trabajo tiene estados, dependencias, reintentos y pasos con responsables definidos. También introduce fallos posibles que hay que probar.
- Elige el patrón de coordinación más sencillo que permita gestionar el proceso y añade límites de pasos, tiempos de espera, responsables y vías de escalado.
- Establece los umbrales de revisión según los resultados de las evaluaciones y el riesgo para el negocio, en lugar de copiar una puntuación de confianza genérica.
- Mide el trabajo completado, la tasa de corrección, el tiempo de recuperación, el coste total y los incidentes con criterios estables.
Introducción: el paso a la orquestación de flujos de trabajo con IA
El mercado ha cambiado por completo. La adopción es ya mayoritaria: el 66% de las organizaciones ha implementado alguna forma de automatización de flujos de trabajo. El impulso es innegable.
Las arquitecturas de referencia actuales combinan agentes de IA, pipelines basados en eventos y controles de calidad con intervención humana para gestionar cargas operativas complejas. El sector ha dejado atrás por completo la RPA estática. La automatización dinámica con IA procesa la información mucho más rápido y se adapta bien a casos excepcionales que harían fallar los scripts heredados.
Las reglas estáticas ya no sirven. Aplicar correctamente técnicas de optimización de flujos de trabajo automatizados con IA exige un gran rigor operativo para mantener una precisión alta ante conjuntos de datos empresariales diversos e impredecibles.
Empieza con esta lista de comprobación:
- [ ] Documentar el punto de partida del proceso actual
- [ ] Definir los umbrales objetivo para las excepciones
- [ ] Elegir un marco de orquestación
- [ ] Configurar los activadores basados en eventos
- [ ] Llevar el primer caso de uso a producción
La orquestación de flujos de trabajo coordina de forma sistemática agentes de IA y controles de calidad humanos
La orquestación de flujos de trabajo coordina agentes, activadores de eventos, servicios deterministas y revisión humana a lo largo de un proceso. Evalúala según el trabajo completado, la tasa de corrección, el tiempo de recuperación, el coste operativo y los incidentes, con criterios aceptados por el equipo de operaciones.
La orquestación resulta útil cuando un flujo de trabajo tiene dependencias, reintentos, estados y varios pasos con responsables definidos. Prueba entradas inesperadas y servicios no disponibles para comprobar si la coordinación mejora la recuperación o solo añade complejidad.
Aquí hace falta estructura. El marco LangChain define expresamente cinco patrones principales de orquestación multiagente que se usan actualmente en producción para gestionar cargas operativas complejas y de alto riesgo: * Router: Un agente central dirige las tareas a subagentes especializados según la intención. * Supervisor: En este modelo jerárquico, un agente supervisor asigna tareas y valida los resultados.
* Network: Los agentes se comunican entre sí y asignan tareas de forma dinámica. * Hierarchical: En una delegación de varios niveles, los responsables asignan tareas a los agentes ejecutores y después reúnen los resultados. * Custom/Graph: Flujos de trabajo basados en máquinas de estados que definen la lógica exacta de transición entre agentes.
El patrón Network puede entrar en un bucle de delegación si los agentes se pasan la misma tarea unos a otros. Evítalo con un límite de pasos, detección de tareas duplicadas, reglas de responsabilidad, tiempos de espera y una vía de escalado. Prueba estos controles ante fallos provocados antes de llevar el sistema a producción.
El patrón Hierarchical puede servir para un flujo complejo como la evaluación de solicitudes de préstamo: los agentes ejecutores recopilan pruebas y un componente responsable combina los resultados. En un caso de fallo hipotético, ese componente recibe datos contradictorios sobre el crédito y los ingresos, pero no dispone de una regla determinista para resolver la discrepancia ni para escalarla. Prueba los conflictos, la falta de documentos, los tiempos de espera y las acciones denegadas antes de usar este patrón en decisiones reales.
Cuando dos agentes ejecutores devolvieron ratios de deuda sobre ingresos contradictorios, el componente responsable tardó 45 segundos en analizar la discrepancia. La latencia pasó de los 2 segundos previstos a un nivel completamente inaceptable. Puede parecer obvio elegir el patrón más avanzado, pero hay una contrapartida menos visible: la complejidad multiplica exponencialmente la dificultad de depuración.
Recomendamos empezar por el patrón Supervisor. Permite delegar de forma controlada sin el riesgo de bucles infinitos del patrón Network.
Integramos estos patrones directamente en una arquitectura basada en eventos. Para construir una lógica de herramientas fiable, hay que conectar el marco de orquestación con los activadores de webhook de esas herramientas, que inician y monitorizan cada flujo automatizado. Este es el formato de payload estándar que usamos para activar un flujo orquestado.
Funciona perfectamente. Al estandarizar la estructura JSON en todos los pipelines, reduces drásticamente las dificultades de integración para tus equipos de ingeniería y facilitas mucho la depuración.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Esta estructura JSON garantiza que el motor de IA reciba tanto la tarea como los parámetros de gobernanza necesarios. Si la confianza cae por debajo de 0.85, el sistema envía el caso a una cola de revisión humana. Así se garantiza el control de calidad sin bloquear todo el pipeline, lo que mantiene su capacidad de procesamiento y hace cumplir estrictamente tus límites operativos.
Aplicar correctamente técnicas de optimización de flujos de trabajo automatizados con IA garantiza que tus profesionales de mayor coste dediquen su tiempo exclusivamente a casos excepcionales de gran impacto, en lugar de a la extracción rutinaria de datos.
Oímos la misma objeción una y otra vez: los equipos de operaciones dicen que la orquestación añade una latencia inaceptable a sus pipelines de procesamiento de transacciones críticas. Pero es un mito. Los pipelines basados en eventos, si se configuran correctamente, reducen el tiempo total de ciclo al eliminar de forma decidida los traspasos manuales y los pasos intermedios innecesarios.
Paso 1: diseñar la lógica de escalado a revisión humana para pipelines basados en eventos
Diseñar la lógica de escalado con intervención humana (HITL) exige asociar umbrales de confianza estrictos a niveles concretos de revisión. No puedes saltarte este paso. El beneficio económico potencial es enorme.
Define dónde termina la automatización y empieza la revisión humana. Los umbrales deben reflejar el riesgo de cada acción, su reversibilidad, la confianza y los requisitos normativos. Después, valídalos con casos de fallo representativos.
- Nivel 1: ejecución automática. Confianza > 95%. Sin revisión humana.
- Nivel 2: revisión por muestreo. Confianza del 80 al 95%. Auditoría de una muestra aleatoria del 10%.
- Nivel 3: revisión obligatoria. Confianza < 80%. Cola HITL completa.
Basar estos umbrales únicamente en la salida sin procesar de un LLM es un error grave. Los modelos están mal calibrados. Un LLM podría indicar una confianza del 99% ante una inyección de instrucciones maliciosa oculta en un contrato subido al sistema, eludir por completo la cola HITL y causar daños catastróficos.
Para evitarlo, incorpora comprobaciones de consistencia. Genera tres respuestas para una misma entrada. Si dos coinciden, la confianza es alta.
Si las tres difieren, fuerza el escalado al nivel 3, independientemente de la puntuación interna.
Imagina un pipeline hipotético de reclamaciones en el que entradas adversarias inflan la confianza. La validación determinista, los límites de pago, la detección de anomalías y la aprobación humana de acciones de alto riesgo deberían impedir que el sistema ejecute un lote grande. Prueba estos controles con casos sintéticos antes de procesar reclamaciones reales.
Si el sistema extrae una cantidad en dólares, una comprobación basada en reglas verifica que esté dentro de los límites históricos. Además, la capacidad de los revisores humanos es limitada. Por eso configuramos un sistema de umbrales dinámicos.
Si el tiempo de espera de la cola de revisión humana supera las 4 horas, el sistema eleva temporalmente el umbral de ejecución automática al 97% y suspende las revisiones por muestreo del nivel 2. Esto evita un cuello de botella en el que los revisores humanos quedan desbordados por escalados de poco impacto.
Las técnicas de integración para una arquitectura basada en eventos utilizan Apache Kafka y Google Cloud PubSub como intermediarios de mensajes. Los usamos mucho. Cuando un documento entra en el pipeline, Kafka publica el evento.
El motor de orquestación de IA lo recibe, procesa el payload y publica el resultado. El enrutamiento se gestiona automáticamente. Si la confianza es baja, el sistema envía el payload directamente a PubSub para su revisión humana inmediata.
Los usuarios de negocio activan estos flujos de IA mediante plataformas no-code y low-code. Es muy sencillo. Un usuario sube un contrato a un portal y la plataforma envía un webhook al backend.
El motor de orquestación extrae las cláusulas, las compara con los estándares y devuelve una puntuación de riesgo completa. Así, la tecnología resulta muy útil. Al ocultar la complejidad de la API, permites que los equipos sin conocimientos técnicos realicen análisis de riesgo sofisticados sin escribir una sola línea de código.
Paso 2: calcular el retorno de inversión y comparar la reducción de costes del piloto a producción
Es un rendimiento extraordinario. Mide la duración de cada ciclo, las horas de trabajo, el coste de las correcciones, el uso de modelos, el tiempo de revisión y los incidentes con definiciones aceptadas por los equipos de finanzas y operaciones. Calcular el retorno de la inversión es fundamental para optimizar los flujos de trabajo con automatización con IA y distinguir los despliegues rentables de los experimentos costosos.
Usa esta tabla para comparar la reducción de costes:
| Caso de uso | Coste manual | Coste de orquestación con IA | Ahorro | Reducción de errores |
|---|---|---|---|---|
| Procesamiento de facturas | $3.70 / documento | $1.20 / documento | 67,6% | un porcentaje significativo |
| Revisión de contratos | $52.00 / contrato | $18.50 / contrato | 64,4% | 85% |
Veamos un ejemplo de procesamiento de facturas a gran escala. Supongamos un volumen de 50.000 facturas. El coste manual es fácil de calcular: 50.000 por $3.70 son $185,000 al mes.
Para calcular el coste automatizado, multiplica 50.000 por $1.20 en procesamiento y revisión humana, lo que da $60,000. Después, suma $5,000 en tokens de API y $2,000 en alojamiento. El coste automatizado total es de $67,000 al mes.
Eso supone un ahorro mensual de $118,000 y un ahorro anual de $1,416,000.
A esa escala, el impacto es enorme. Y no es un caso aislado. Aplicar estos métodos de optimización en toda una gran empresa produce un efecto financiero acumulativo que mejora de forma sustancial su estructura de costes operativos.
Calculadora del retorno de la inversión en flujos de trabajo con IA
Calcula cuánto ahorrarías al mes automatizando facturas con IA.
Una conclusión poco habitual: ¿por qué fracasa el 41% de los proyectos de orquestación de IA en grandes empresas?
Los proyectos de orquestación de IA en grandes empresas fracasan porque intentan automatizar procesos deficientes sin medir primero su rendimiento ni rediseñar los flujos de trabajo. Es un error decisivo. El 41% de estos proyectos no alcanza los objetivos de negocio previstos dentro del plazo y el presupuesto originales debido a una mala selección de procesos y a la subestimación de las integraciones.
Lo vemos constantemente: si omites el rediseño del proceso, tus nuevas y costosas herramientas de IA solo harán que las ineficiencias existentes se reproduzcan más rápido.
La automatización con IA puede aportar mejoras creíbles a cada flujo de trabajo. Sin embargo, el retorno de la inversión a escala empresarial depende de medir el punto de partida, rediseñar los flujos, conseguir que se adopten, establecer controles y mantener una estricta disciplina de costes. Automatizar un proceso deficiente no lo arregla: solo acelera sus fallos mientras consume recursos de procesamiento costosos.
Por eso no desplegamos agentes sobre flujos inestables hasta que el cliente documenta el proceso actual y rediseña los pasos operativos necesarios para hacerlo eficiente.
Si un proceso tiene una tasa de excepciones superior al 8%, todavía no lo automatices. Rediséñalo primero. A menudo, los equipos eligen casos de uso muy variables y la IA acaba derivando tareas continuamente a operadores humanos ya sobrecargados.
Es un planteamiento equivocado. Optimizar bien los flujos de trabajo con automatización con IA exige aceptar que no todo debe entrar en producción de inmediato, por mucho que lo pida la dirección.
La causa de este fracaso se entiende con una cuenta sencilla. Cuando hay muchas excepciones, el orquestador se limita a derivar trabajo a personas. Y pagas por cada transacción que pasa por el sistema: tokens de API, tiempo de procesamiento y gestión de colas.
Si la IA intenta tramitar una reclamación compleja, falla y la deriva a una persona, el tiempo total de tramitación será bastante mayor que si esa persona se hubiera ocupado de ella desde el principio.
Evaluamos a una empresa logística de la lista Fortune 500 que intentó automatizar la resolución de reclamaciones de transporte. Eligió ese caso de uso por el alto valor de cada transacción. La contrapartida, menos evidente, era la gran variabilidad que suele acompañar a ese valor.
La tasa real de excepciones era del 22%. Cada transportista utilizaba formatos de pruebas propios y enviaba correos desordenados que confundían al modelo. La IA consumía tokens intentando interpretar cadenas de correos no estructuradas, fallaba y derivaba el caso.
Cada intento fallido salía caro: añadía 3 minutos a cada reclamación y, en seis meses, generó $1.2M en costes adicionales por retrasos operativos.
De forma parecida, General Motors dio marcha atrás en 2023 con un proyecto de asignación de rutas de la cadena de suministro totalmente automatizado. Descubrió que las diferencias entre los formatos de datos de los proveedores elevaban las excepciones por encima del 30%. Tuvo que volver a un sistema basado en reglas, complementado con una capa de asistencia de IA para los casos imprevistos.
Los equipos eligen procesos complejos y de alto valor porque las proyecciones en la hoja de cálculo parecen enormes. Resiste esa tentación. Empieza por procesos rutinarios y repetitivos para ganar confianza operativa y estabilidad técnica antes de abordar los que presentan mucha variabilidad.
Usamos esta lista para evitar esos errores. Antes de escribir una sola línea de código, comprueba que la tasa de excepciones del proceso sea inferior al 8%. - [ ] Comprobar que la tasa de excepciones del proceso sea inferior al 8% - [ ] Medir el coste y la duración actuales de cada ciclo - [ ] Identificar los puntos de integración con los sistemas heredados - [ ] Obtener el apoyo de las partes implicadas para rediseñar el flujo de trabajo Para nosotros, estos pasos son imprescindibles.
Si te los saltas, desplegarás un sistema que consume capital y frustra a tu equipo de operaciones.
¿Estás dejando que las expectativas exageradas decidan tu estrategia de despliegue? No lo hagas. Elige las tareas adecuadas, mide el punto de partida y rediseña el flujo antes de pensar siquiera en automatizarlo. Después, automatiza.
¿Cómo se monitoriza la deriva del modelo y se integran los motores de IA con los mainframes heredados?
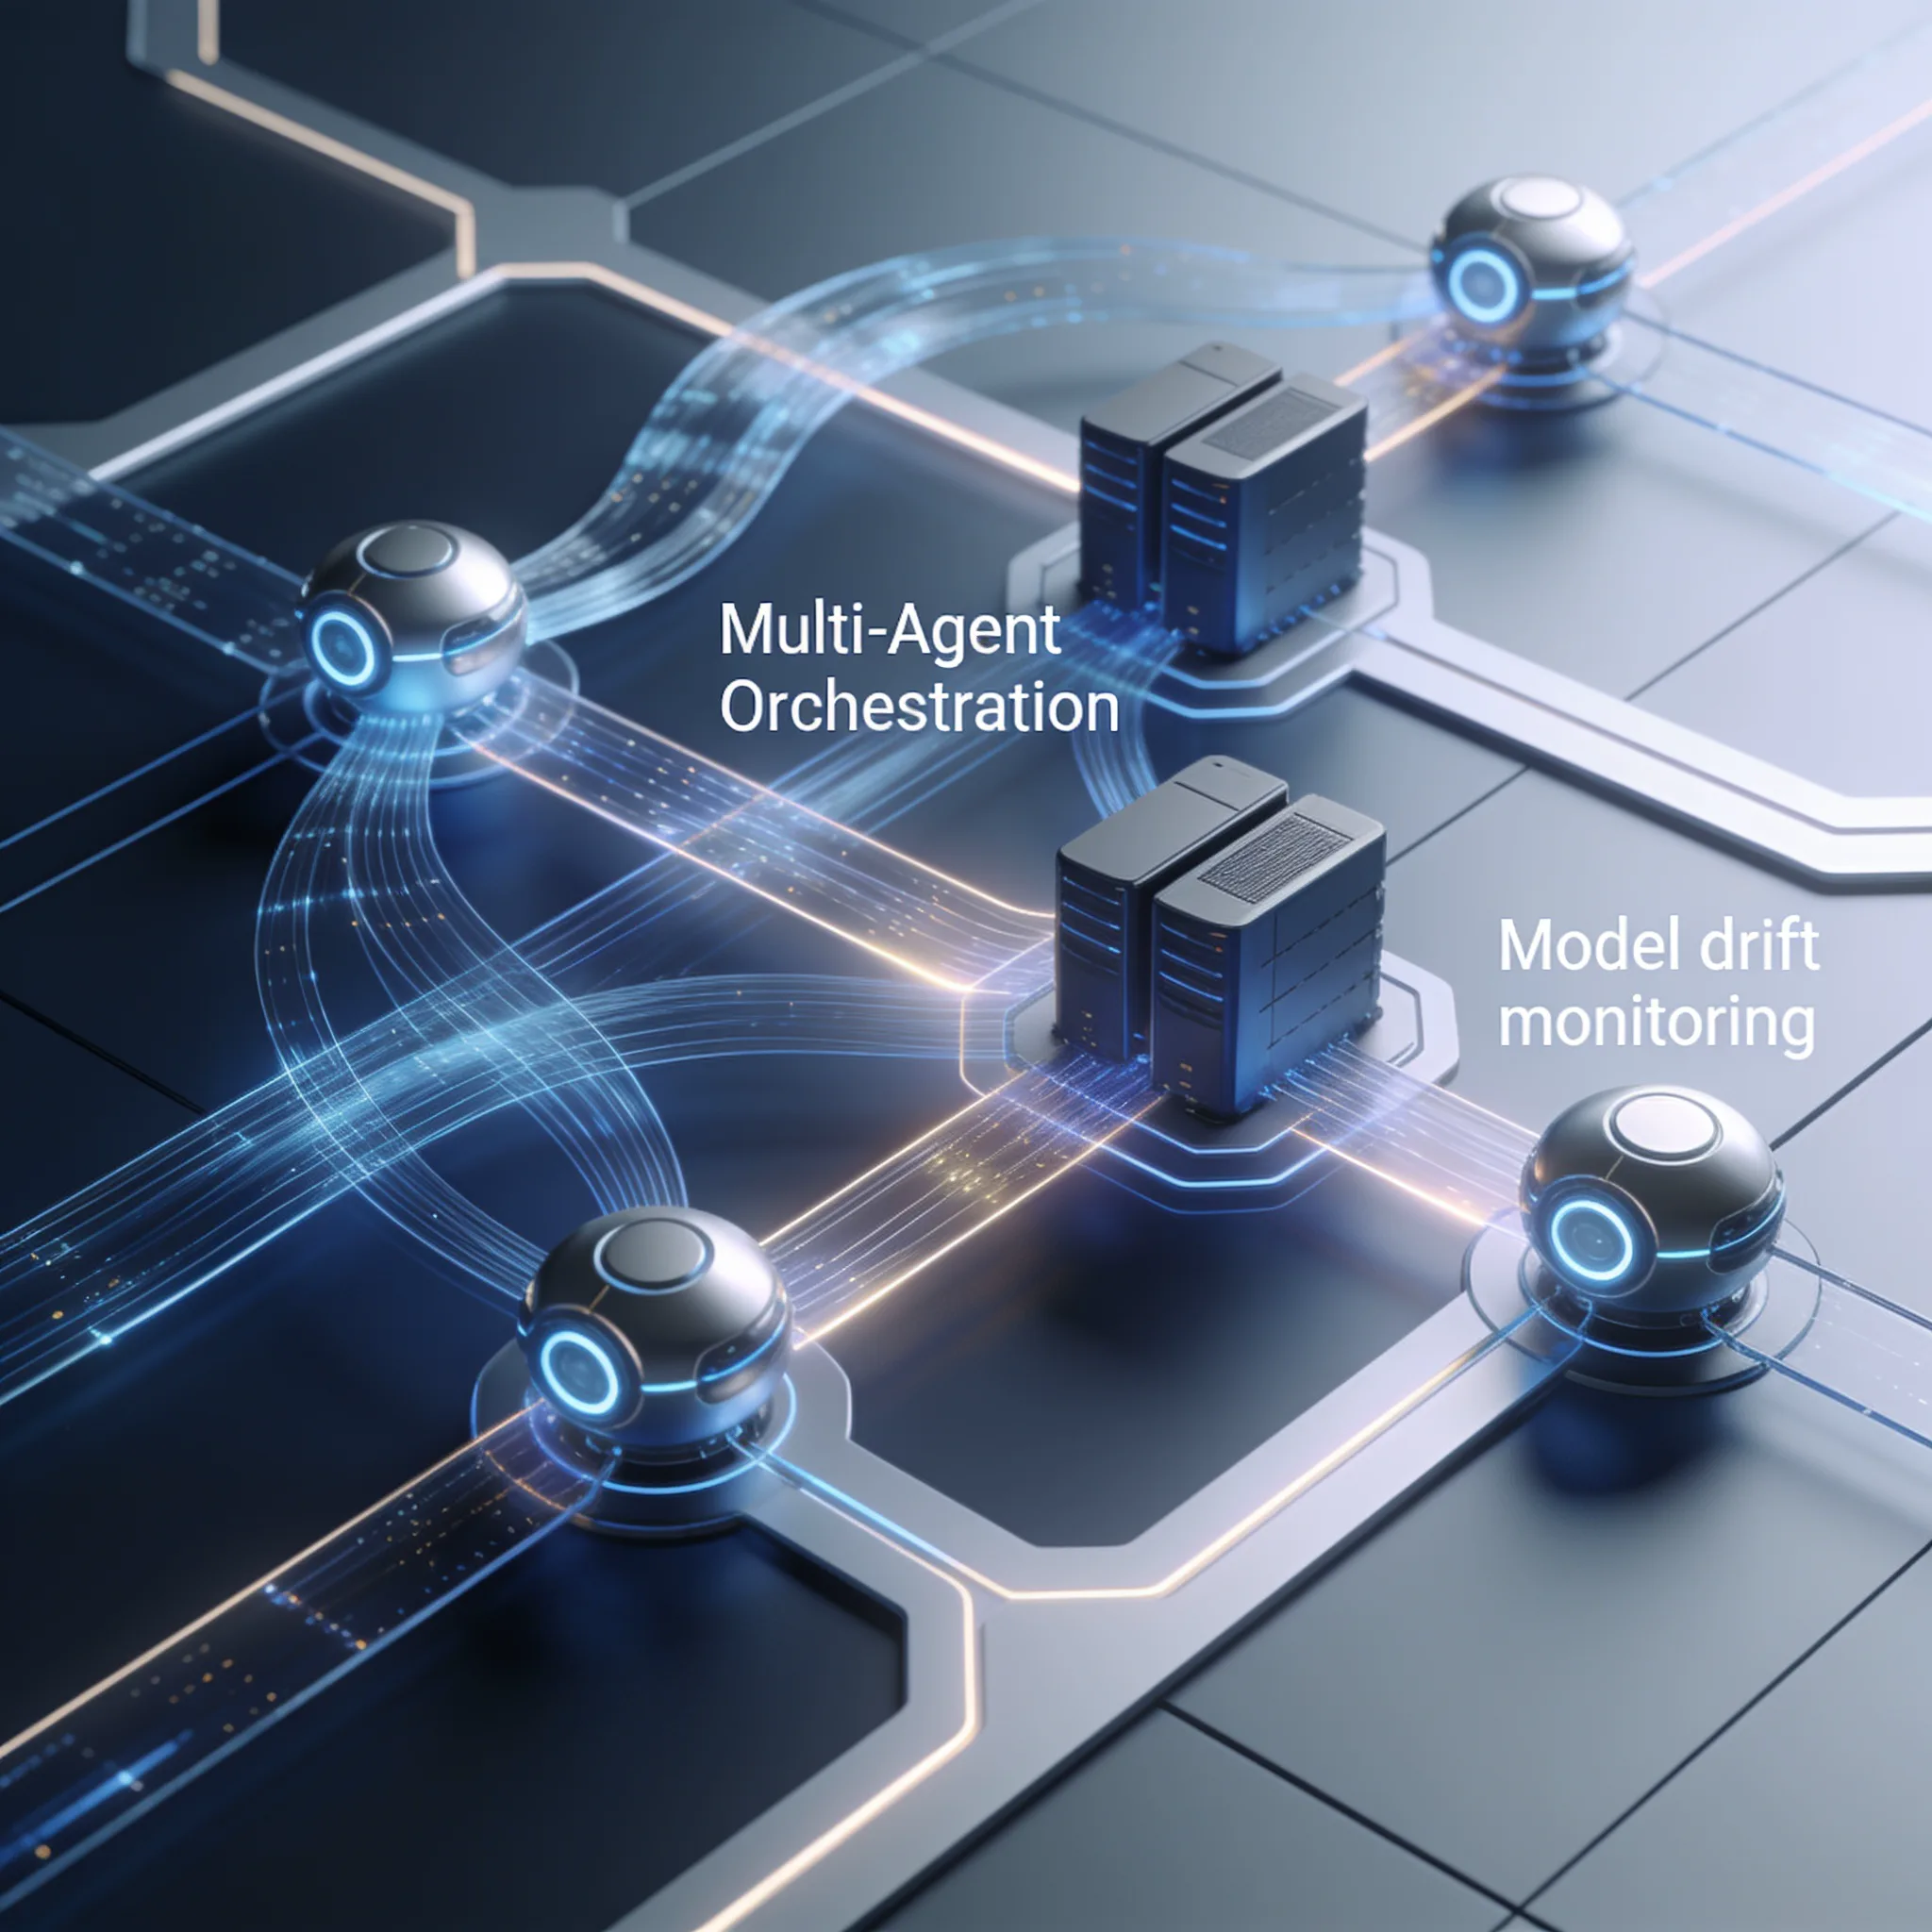
Para monitorizar la deriva del modelo, establece conjuntos de datos de referencia y sigue la evolución de las distribuciones de las puntuaciones de confianza. Para integrar motores de IA con mainframes heredados, utiliza puertas de enlace de API y middleware que convierta los datos JSON modernos a los formatos de terminal antiguos. Supervisa la deriva y los niveles de servicio mediante registros de inferencia, muestras de referencia y alertas con una persona responsable de responder.
Para controlar los acuerdos de nivel de servicio en tiempo real, registra la latencia de cada inferencia y genera alertas cuando se superen los umbrales. Optimizar los flujos de trabajo con automatización con IA exige vigilar de forma constante tanto el sistema como el modelo.
La deriva del modelo puede reducir la precisión rápidamente. Supervisa continuamente las distribuciones de los datos de entrada y los intervalos de confianza de las salidas. Si un agente pasa a mostrar un 40% de confianza en una tarea que normalmente resuelve con un 95%, investígalo de inmediato.
Es una señal de alerta clara. Si ignoras estos cambios estadísticos, tu flujo automatizado puede ir contaminando los datos posteriores con respuestas inventadas que parecen fiables y erosionan la confianza de los usuarios.
Integrar sistemas de IA con mainframes heredados supone un reto técnico considerable, pero tiene solución. Utiliza una capa de middleware para conectar los motores modernos de orquestación de IA con sistemas antiguos que no pueden procesar datos JSON modernos. La arquitectura es importante: con una capa de traducción adecuada, los agentes de IA pueden consultar información y guardar cambios sin modificar el núcleo heredado.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Esta configuración YAML convierte los datos de una API moderna a formatos que el mainframe puede leer y permite la comunicación entre ambos sistemas. El agente de IA puede consultar información y guardar cambios sin modificar el núcleo heredado. Así evitas los riesgos y costes de intervenir en código COBOL frágil, escrito hace décadas, que sostiene sistemas bancarios esenciales.
Un cambio en la plantilla de una factura puede desplazar un importe al campo equivocado sin que baje la puntuación del modelo. Compara la precisión de cada campo con muestras revisadas, detecta cambios en la distribución de los datos de entrada y detén el procesamiento cuando falle una validación.
La integración con mainframes conlleva riesgos específicos para los datos. Convertir decimales empaquetados de COBOL a valores JSON de coma flotante puede introducir errores de redondeo que se acumulan a lo largo de muchas transacciones. Conserva los tipos decimales, concilia los totales y ejecuta el cálculo actualizado en paralelo con el existente antes de procesar datos financieros reales.
Cuantifica cualquier diferencia a partir de registros de producción revisados, no de una cifra de pérdidas inventada.
Para evitarlo, debes incorporar al middleware una capa estricta que conserve los tipos decimales. Las pruebas en paralelo son obligatorias. Envía el 5% del tráfico real al modelo actualizado, compara sus resultados con los del sistema heredado y registra las discrepancias.
Después, espera. Solo debes pasar el modelo al tráfico principal cuando la tasa de errores baje del 0,5% y el sistema haya demostrado su estabilidad.
Controla los niveles de servicio con definiciones claras, registros y una persona responsable de responder si el rendimiento empeora. Los ejemplos de productividad de otros proyectos no demuestran qué resultados obtendrá un flujo de trabajo distinto.
Paso 3: ¿Qué casos de uso de automatización de flujos de trabajo conviene desplegar en producción?
Los mejores casos de uso para desplegar en producción son los procesos de gran volumen, pocas excepciones y resultados deterministas, con vías claras para derivar casos a una persona. Entre ellos están el procesamiento de facturas, la asignación de consultas de clientes y el análisis de contratos. Nos centramos exclusivamente en este tipo de procesos.
Elegir bien los casos de uso es el último paso para optimizar los flujos de trabajo con automatización con IA y conseguir que la plataforma funcione en condiciones reales.
Antes de ampliar el despliegue, mide cuántos proyectos piloto llegan a producción. Ese paso requiere controles estrictos en la plataforma, pero es perfectamente viable. Con protocolos de prueba rigurosos y mecanismos de respaldo adecuados, puedes formar parte de las pocas empresas que obtienen un retorno medible de su inversión en IA.
Usamos esta matriz de decisión para seleccionar casos de uso con criterio y evitar las conjeturas.
| Criterio | Procesamiento de facturas | Revisión de contratos | Clasificación de correos |
|---|---|---|---|
| Volumen | Alto | Medio | Alto |
| Tasa de excepciones | Baja | Media | Alta |
| Plazo de recuperación de la inversión | 9,8 meses | 14,2 meses | Más de 18 meses |
| Complejidad de integración | Baja | Alta | Media |
Si eliges los procesos adecuados, reduces considerablemente el plazo de recuperación de la inversión y liberas capital para financiar nuevas iniciativas de automatización.
Un sistema en producción necesita monitorización, alertas y mecanismos de respaldo. Sin excepciones. Si falla el motor de IA, el sistema debe pasar a la tramitación humana sin perder el evento ni corromper los datos.
Es un requisito indispensable. Diseñamos cada flujo de orquestación con protocolos automáticos para funcionar con capacidad reducida y garantizar que no se pierdan datos, incluso ante fallos graves de infraestructura.
Conclusión: cómo mejorar la eficiencia empresarial a escala con la automatización con IA
Mejorar la eficiencia empresarial a gran escala con IA exige técnicas avanzadas de optimización de flujos de trabajo automatizados. No basta con aparentar que funcionan. Las organizaciones deben combinar objetivos ambiciosos de automatización con una disciplina operativa rigurosa en todos los departamentos.
Perder ese equilibrio las expone a una tasa de fracaso del 41%. También puede arruinar carreras. Si antepones la velocidad a la estabilidad, acabarás implantando sistemas frágiles que fallan en los momentos de mayor carga y hacen que la dirección pierda la confianza en tu estrategia técnica.
Para evitarlo, necesitas incorporar la supervisión humana, usar pipelines basados en eventos y seguir de cerca los indicadores de referencia. Así podrás controlar los costes y evitar que se degrade la precisión. No automatices procesos que ya funcionan mal.
Es el peor error que puedes cometer. Si corriges primero el flujo de trabajo, tus herramientas de IA podrán ofrecer los rendimientos exponenciales que justifican una inversión de capital tan elevada.
La transición de la RPA basada en reglas a la orquestación dinámica de IA ya se ha producido. Los métodos antiguos han quedado atrás. Las empresas que dominen estas técnicas de integración se impondrán en sus mercados; las que ignoren los controles operativos agotarán su capital rápidamente.
Te lo garantizamos. Tú decides: desarrolla ahora una capacidad de orquestación disciplinada o contempla cómo tus competidores usan la IA para arrebatarte cuota de mercado de forma sistemática. Así se aplican en la práctica las técnicas de optimización de flujos de trabajo automatizados con IA.
Modelos actuales de Claude, GPT, Gemini y Grok, hasta un 75 % por debajo del precio de lista
Una sola clave de API para los modelos de Claude, GPT, Gemini y Grok en el SDK de OpenAI. Los modelos de Claude también funcionan con el SDK de Anthropic y con Claude Code.
La tarifa de cada modelo con el crédito de AIGROW figura junto al precio de lista de su fabricante, nunca por encima.
Preguntas frecuentes
