L’IA en entreprise fonctionne lorsque des modèles isolés cèdent la place à des workflows orchestrés, tout en conservant une intervention humaine. Bien mise en œuvre, l’orchestration réduit de 43 % la durée des processus et de 90 % le taux d’erreur. Ce guide présente l’architecture, les contrôles nécessaires à sa sécurité et les moyens de vérifier qu’elle tient le passage à l’échelle.
- L’orchestration est utile lorsqu’un workflow comporte des états, des dépendances, des tentatives de reprise et des étapes dont la responsabilité est définie. Elle introduit aussi des risques de défaillance qu’il faut tester.
- Choisissez le mode de coordination le plus simple qui réponde aux besoins du processus, puis définissez un nombre maximal d’étapes, des délais d’expiration, des responsabilités et une procédure d’escalade.
- Fixez les seuils de révision à partir des résultats d’évaluation et des risques métier, plutôt que de reprendre un score de confiance générique.
- Mesurez le travail effectivement accompli, le taux de correction, le temps de rétablissement, le coût total et les incidents selon des définitions stables.
Introduction : le passage à l’orchestration des workflows IA
Le marché a complètement changé. L’adoption est désormais majoritaire : 66 % des organisations ont déployé une forme d’automatisation des workflows. La dynamique est indéniable.
Les architectures de référence actuelles associent agents IA, pipelines pilotés par événements et contrôles qualité avec intervention humaine pour gérer des charges opérationnelles complexes. Le secteur a entièrement abandonné la RPA statique. L’automatisation dynamique par l’IA traite les informations beaucoup plus vite et s’adapte bien aux cas particuliers qui feraient échouer les anciens scripts.
Les règles statiques ont fait leur temps. Appliquer de bonnes techniques d’optimisation des workflows d’automatisation par l’IA exige une grande rigueur opérationnelle pour que ce traitement dynamique reste fiable face à des données d’entreprise variées et imprévisibles.
Pour commencer, suivez cette liste :
- [ ] Établir l’état initial du processus actuel
- [ ] Définir les seuils cibles pour les exceptions
- [ ] Choisir un framework d’orchestration
- [ ] Configurer les déclencheurs pilotés par événements
- [ ] Mettre un premier cas d’usage en production
L’orchestration des workflows coordonne méthodiquement les agents IA et les contrôles qualité humains
L’orchestration des workflows coordonne les agents, les déclencheurs événementiels, les services déterministes et la vérification humaine tout au long d’un processus. Évaluez-la à partir du travail effectivement accompli, du taux de correction, du temps de rétablissement, des coûts d’exploitation et des incidents, selon des définitions validées par l’équipe opérationnelle.
L’orchestration devient utile lorsqu’un workflow comporte des dépendances, des tentatives de reprise, des états et plusieurs étapes dont la responsabilité est définie. Testez les entrées inattendues et les services indisponibles pour déterminer si cette coordination facilite le rétablissement ou ne fait qu’ajouter de la complexité.
Il faut ici une structure claire. Le framework LangChain distingue cinq grands modèles d’orchestration multi-agents actuellement utilisés en production pour gérer des opérations complexes et sensibles : * Routeur : Un agent central dirige les tâches vers des sous-agents spécialisés selon l’intention. * Superviseur : Dans ce modèle hiérarchique, un agent superviseur attribue les tâches et valide les résultats.
* Réseau : Les agents communiquent entre eux et se répartissent les tâches de façon dynamique. * Hiérarchique : Dans cette délégation à plusieurs niveaux, des agents responsables attribuent les tâches à des agents exécutants, puis regroupent les résultats. * Personnalisé/graphe : Des workflows sous forme de machines à états définissent précisément les transitions entre agents.
Dans un modèle en réseau, les agents peuvent entrer dans une boucle de délégation en se renvoyant la même tâche. Pour l’éviter, fixez un nombre maximal d’étapes, détectez les tâches en double et définissez des règles de responsabilité, des délais d’expiration et une procédure d’escalade. Testez ces garde-fous en provoquant des défaillances avant la mise en production.
Un modèle hiérarchique peut prendre en charge un workflow complexe, comme l’évaluation d’une demande de prêt : des agents exécutants réunissent les justificatifs et un composant responsable combine leurs résultats. Dans un scénario de défaillance hypothétique, ce composant reçoit des informations contradictoires sur la solvabilité et les revenus, sans règle déterministe pour trancher ni procédure d’escalade. Testez les contradictions, les documents manquants, les délais d’expiration et les actions refusées avant d’utiliser ce modèle pour des décisions réelles.
Lorsque deux agents exécutants ont renvoyé des ratios dette/revenu contradictoires, le composant responsable a mis 45 secondes à analyser l’écart, faisant passer la latence de 2 secondes attendues à un niveau totalement inacceptable. On pourrait être tenté de choisir le modèle le plus avancé, mais sa complexité rend le débogage exponentiellement plus difficile. Nous recommandons vivement de commencer par le modèle Superviseur.
Il permet une délégation contrôlée sans les risques de boucle infinie du modèle Réseau.
Nous intégrons directement ces modèles à une architecture pilotée par événements. Pour créer une logique d’outils fiable, il faut relier votre framework d’orchestration aux déclencheurs webhook des outils, qui lancent et suivent chaque flux automatisé. Voici le format de payload standard que nous utilisons pour déclencher un flux orchestré.
Il fonctionne parfaitement. En uniformisant la structure JSON de tous vos pipelines, vous réduisez considérablement les difficultés d’intégration et facilitez nettement le débogage pour vos équipes d’ingénierie.
{
 "event_id": "evt_9a8b7c",
 "trigger_source": "kafka_topic",
 "workflow_type": "invoice_processing",
 "payload": {
 "document_uri": "s3://bucket/invoice.pdf",
 "confidence_threshold": 0.85
 },
 "hitl_escalation": {
 "enabled": true,
 "channel": "slack_notify"
 }
}
Cette structure JSON transmet au moteur d’IA la tâche et les paramètres de gouvernance nécessaires. Si le niveau de confiance passe sous 0.85, le système dirige le dossier vers une file de vérification humaine. Elle garantit ainsi un contrôle qualité sans bloquer l’ensemble du pipeline : le débit est préservé et vos garde-fous opérationnels restent strictement appliqués.
De bonnes techniques d’optimisation des workflows d’automatisation par l’IA garantissent que vos ressources humaines les plus coûteuses se consacrent uniquement aux cas particuliers à fort impact, plutôt qu’à l’extraction courante de données.
Nous entendons souvent la même objection : les équipes opérationnelles estiment que l’orchestration ajoute une latence inacceptable à leurs pipelines de traitement des transactions critiques. Pourtant, c’est une idée reçue. Des pipelines pilotés par événements et correctement configurés réduisent en réalité la durée totale des processus en supprimant les passages de relais manuels et les étapes intermédiaires inutiles.
Étape 1 : définir les règles d’escalade vers un humain dans les pipelines pilotés par événements
Pour définir les règles d’escalade vers un humain (HITL), il faut associer des seuils de confiance stricts à des niveaux précis de vérification. Cette étape est indispensable. Les gains financiers potentiels sont considérables.
Définissez où l’automatisation s’arrête et où la vérification humaine commence. Les seuils doivent tenir compte du risque lié à l’action, de sa réversibilité, du niveau de confiance et des exigences réglementaires, puis être validés sur des cas de défaillance représentatifs.
- Niveau 1 : exécution automatique. Confiance > 95 %. Aucune vérification humaine.
- Niveau 2 : contrôle ponctuel. Confiance de 80 à 95 %. Audit d’un échantillon aléatoire de 10 %.
- Niveau 3 : vérification obligatoire. Confiance < 80 %. Passage systématique dans la file HITL.
Se fier uniquement à la sortie brute d’un LLM pour définir ces seuils est une grave erreur. Les modèles sont mal calibrés. Un LLM peut afficher une confiance de 99 % face à une injection de prompt malveillante dissimulée dans un contrat téléchargé, contourner entièrement la file HITL et causer des dégâts catastrophiques.
Pour y remédier, mettez en place des contrôles de cohérence interne : générez trois réponses pour une même entrée. Si deux concordent, le niveau de confiance est élevé. Si les trois diffèrent, imposez une escalade au niveau 3, quel que soit le score interne.
Prenons un pipeline hypothétique de traitement des sinistres dans lequel des entrées adversariales gonflent le niveau de confiance. Une validation déterministe, des plafonds d’indemnisation, la détection des anomalies et l’approbation humaine des actions à haut risque doivent empêcher le système de traiter un lot important. Testez ces contrôles avec des cas synthétiques avant de traiter de vrais dossiers.
Si le système extrait un montant en dollars, une vérification fondée sur des règles confirme qu’il se situe dans les limites historiques. La capacité des personnes chargées des vérifications reste toutefois limitée. Nous mettons donc en place un système de seuils dynamiques.
Si le délai d’attente de la file humaine dépasse 4 heures, le système relève temporairement le seuil d’exécution automatique à 97 % et suspend les contrôles ponctuels de niveau 2. Cela évite que les personnes chargées des vérifications soient submergées par des remontées de cas à faible impact.
Pour intégrer une architecture pilotée par événements, nous utilisons Apache Kafka et Google Cloud PubSub comme courtiers de messages. Nous nous appuyons largement sur ces outils. Lorsqu’un document entre dans le pipeline, Kafka publie l’événement.
Le moteur d’orchestration IA y est abonné : il traite le payload, puis publie le résultat. Le routage est automatique. Si le niveau de confiance est faible, le système envoie directement le payload à PubSub pour une vérification humaine immédiate.
Les utilisateurs métier déclenchent ces flux IA depuis des plateformes no-code et low-code. Le fonctionnement est très simple : une personne dépose un contrat sur un portail et la plateforme envoie un webhook au backend. Le moteur d’orchestration extrait les clauses, les compare aux standards et renvoie un score de risque complet.
La technologie devient alors très utile. En masquant la complexité des API sous-jacentes, vous permettez aux équipes non techniques de mener des analyses de risque poussées sans écrire une seule ligne de code.
Étape 2 : calculer le ROI et comparer les réductions de coûts, du pilote à la production
C’est un retour sur investissement considérable. Suivez le temps de traitement, le coût de la main-d’œuvre et des corrections, l’utilisation des modèles, le temps de vérification et les incidents, selon des définitions validées par les équipes financières et opérationnelles. Le calcul du retour sur investissement est au cœur d’une bonne optimisation des flux de travail par l’automatisation IA : c’est ce qui distingue les déploiements réussis des projets expérimentaux coûteux.
Utilisez ce tableau comparatif pour évaluer les réductions de coûts :
| Cas d’usage | Coût manuel | Coût de l’orchestration IA | Économies | Réduction des erreurs |
|---|---|---|---|---|
| Traitement des factures | $3.70 / document | $1.20 / document | 67.6% | un pourcentage significatif |
| Analyse des contrats | $52.00 / contrat | $18.50 / contrat | 64.4% | 85% |
Prenons un exemple concret de traitement des factures à grande échelle, avec un volume de 50,000 factures. Le coût manuel est facile à calculer : 50,000 multiplié par $3.70, soit $185,000 par mois. Détaillons les coûts de l’automatisation.
Multipliez 50,000 par $1.20 pour le calcul informatique et la vérification humaine, soit $60,000, puis ajoutez $5,000 pour les jetons API et $2,000 pour l’hébergement. Le calcul est simple : le coût total de l’automatisation atteint $67,000 par mois. Vous économisez donc $118,000 par mois, soit $1,416,000 par an.
À cette échelle, les montants sont considérables. Et ce cas n’est pas isolé. Appliqués à l’ensemble d’une grande entreprise, ces principes d’optimisation produisent des économies cumulées qui améliorent en profondeur sa structure de coûts opérationnels.
Calculateur de retour sur investissement des flux de travail IA
Calculez vos économies mensuelles grâce à l’automatisation IA du traitement des factures.
Un constat méconnu : pourquoi 41% des projets d’orchestration IA en entreprise échouent-ils ?
Les projets d’orchestration IA en entreprise échouent lorsque les organisations tentent d’automatiser des processus défaillants sans avoir d’abord défini des indicateurs de référence ni repensé leurs flux de travail. C’est une erreur décisive. Pas moins de 41% des projets d’orchestration IA en entreprise n’atteignent pas leurs objectifs métier dans les délais et le budget initialement prévus, en raison d’un mauvais choix de processus et d’une sous-estimation des intégrations nécessaires.
Nous le constatons régulièrement. Sans ce travail préalable de refonte, vos nouveaux outils IA, aussi coûteux soient-ils, ne feront qu’accélérer les inefficacités existantes.
L’automatisation IA peut apporter des gains crédibles à l’échelle d’un flux de travail. Mais le retour sur investissement à l’échelle de l’entreprise dépend des mesures de référence, de la refonte des processus, de l’adoption, de la gouvernance et d’une stricte maîtrise des coûts. L’automatisation ne répare pas un mauvais processus.
Elle le fait échouer plus vite, tout en consommant de coûteuses ressources de calcul. C’est la réalité. Nous refusons de déployer des agents sur des flux de travail instables tant que le client n’a pas cartographié la situation actuelle et repensé les étapes opérationnelles nécessaires à une véritable efficacité.
Si le taux d’exceptions d’un processus dépasse 8%, ne l’automatisez pas encore. Repensez d’abord le processus. Les équipes choisissent souvent des cas d’usage très variables, ce qui oblige l’IA à transférer sans cesse les tâches à des opérateurs humains déjà débordés.
Pourquoi faire ce choix ? C’est la mauvaise approche. Maîtriser l’optimisation des flux de travail par l’automatisation IA, c’est accepter que tout ne doit pas être mis en production immédiatement, quelles que soient les exigences de la direction.
Le mécanisme de cet échec est une simple question de calcul. Quand le taux d’exceptions est élevé, l’orchestrateur ne fait guère plus que rediriger les tâches vers des humains. Et vous payez pour chaque étape : les jetons API, le temps de calcul et la gestion de la file d’attente pour chaque transaction qui traverse le système.
Si l’IA tente de traiter une réclamation complexe, échoue, puis la transmet à une personne, la durée totale du traitement devient nettement supérieure à celle d’un traitement humain dès le départ.
Nous avons évalué une entreprise de logistique du Fortune 500 qui avait tenté d’automatiser le traitement des réclamations liées au fret. Elle avait choisi ce cas d’usage pour la valeur élevée de chaque transaction. Mais cette valeur va généralement de pair avec une forte variabilité.
Le taux d’exceptions réel atteignait 22%. Chaque transporteur utilisait ses propres formats de justificatifs et envoyait des e-mails peu structurés qui déconcertaient le modèle. L’IA consommait des jetons pour tenter d’analyser ces échanges, échouait, puis transférait le dossier.
Cet échec coûtait cher. La tentative infructueuse de l’IA ajoutait 3 minutes par réclamation et a entraîné $1.2M de coûts supplémentaires liés aux retards opérationnels en six mois.
De même, General Motors a renoncé en 2023 à un projet d’acheminement entièrement automatisé pour sa chaîne d’approvisionnement. L’entreprise a constaté que la diversité des formats de données de ses fournisseurs faisait grimper le taux d’exceptions au-delà de 30%. Elle a dû revenir à un système fondé sur des règles, complété par une couche d’assistance IA pour gérer les cas particuliers imprévisibles.
Les équipes choisissent des processus complexes et à forte valeur parce que les projections financières sont séduisantes. Résistez à cette tentation. Commencez par des processus répétitifs et sans surprise pour gagner en confiance opérationnelle et en stabilité technique, avant de vous attaquer aux processus très variables.
Nous utilisons cette liste de contrôle pour éviter ces écueils. Vérifiez que le taux d’exceptions du processus est inférieur à 8% avant d’écrire la moindre ligne de code. - [ ] Vérifier que le taux d’exceptions du processus est inférieur à 8% - [ ] Définir les coûts et les temps de traitement de référence - [ ] Cartographier les points d’intégration avec les systèmes existants - [ ] Obtenir l’adhésion des parties prenantes à la refonte du flux de travail Pour nous, ces étapes sont incontournables.
Si vous les ignorez, vous déploierez un système qui engloutira des ressources et compliquera le travail de vos équipes opérationnelles.
L’engouement autour de l’IA dicte-t-il votre stratégie de déploiement ? Ne le laissez pas faire. Choisissez les bonnes tâches, mesurez la situation de départ et repensez le flux de travail avant même d’envisager l’automatisation. Automatisez ensuite.
Prêt à découvrir ce que l’IA peut apporter à vos opérations ?
Livré sous 3-5 jours ouvrés. Sans engagement.
Comment surveiller la dérive des modèles et intégrer les moteurs IA aux mainframes existants ?
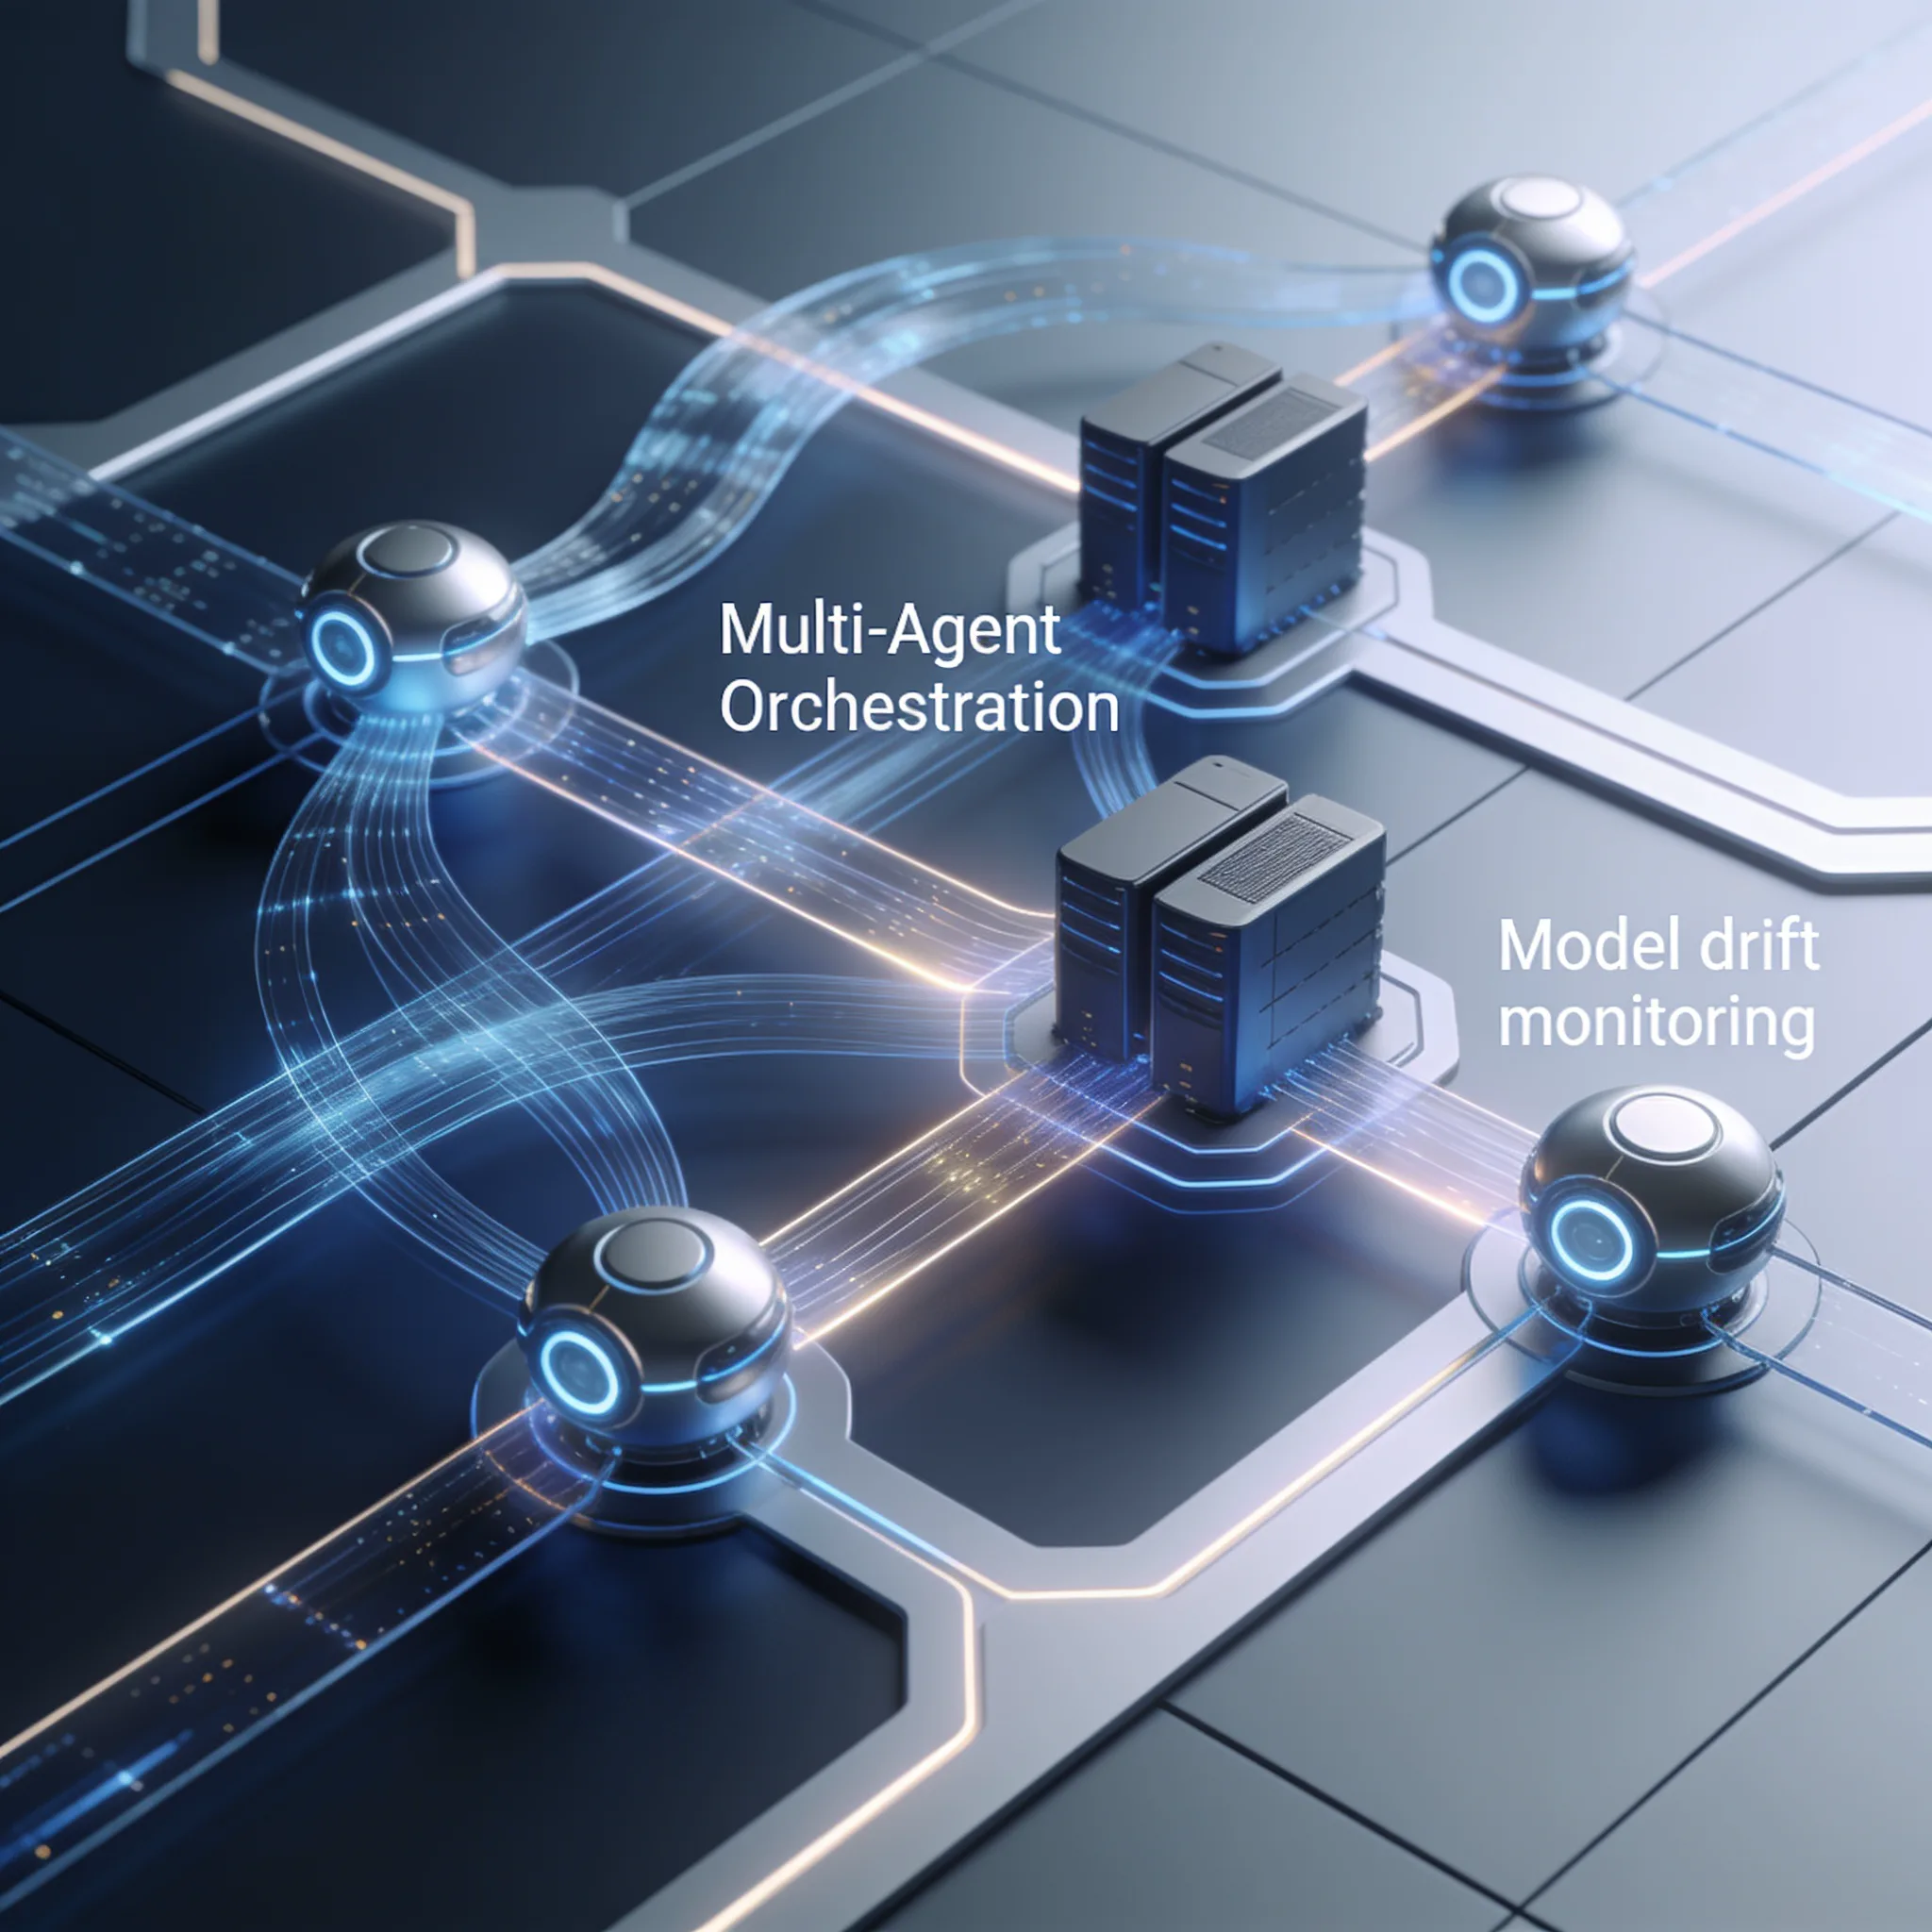
Pour surveiller la dérive d’un modèle, constituez des jeux de données de référence et suivez l’évolution de la répartition des scores de confiance. Pour intégrer des moteurs IA aux mainframes existants, utilisez des passerelles API et un middleware qui convertit les charges utiles JSON modernes dans les formats des anciens terminaux. Suivez la dérive du modèle et les niveaux de service à l’aide des données d’inférence journalisées, d’échantillons de référence et d’alertes confiées à un responsable désigné.
Pour suivre les engagements de niveau de service en temps réel, enregistrez toutes les latences d’inférence et déclenchez une alerte dès qu’un seuil est dépassé. Une optimisation avancée des flux de travail par l’automatisation IA exige une vigilance constante sur l’état du système et des modèles.
La dérive d’un modèle peut rapidement dégrader sa précision. Surveillez en permanence la répartition des données d’entrée et les intervalles de confiance des résultats. Si un agent affiche soudain une confiance de 40% pour une tâche qu’il traite habituellement avec 95% de confiance, signalez-le immédiatement.
C’est un signal d’alerte clair. Si vous ignorez ces changements statistiques, votre pipeline automatisé risque d’injecter progressivement dans les systèmes en aval des données erronées issues d’hallucinations formulées avec assurance, au détriment de la confiance des utilisateurs.
L’intégration aux mainframes existants est un véritable défi technique, mais il peut être relevé. Utilisez une couche middleware adaptée pour relier les moteurs modernes d’orchestration IA aux anciens systèmes incapables de traiter les charges utiles JSON actuelles. L’architecture est déterminante.
Avec une couche de traduction appropriée, vos agents IA peuvent récupérer le contexte et enregistrer des mises à jour sans modifier le cœur du système existant.
mainframe_integration:
 endpoint: "tcp://legacy-mainframe:8083"
 protocol: "tn3270"
 data_mapping:
 - field: "CUSTOMER_ID"
 legacy_format: "PIC X(8)"
 modern_format: "string"
 - field: "BALANCE"
 legacy_format: "PIC 9(10)V99"
 modern_format: "float"
Cette configuration YAML convertit les charges utiles des API modernes en formats lisibles par le mainframe. Elle permet aux services de communiquer. L’agent IA peut récupérer le contexte et enregistrer des mises à jour sans modifier le cœur du système existant.
C’est un avantage opérationnel majeur : vous évitez les risques et les coûts considérables d’une intervention sur le code COBOL fragile, parfois vieux de plusieurs décennies, dont dépendent vos systèmes bancaires les plus critiques.
Un nouveau modèle de facture peut conserver un score de confiance élevé tout en plaçant une valeur dans le mauvais champ. Mesurez la précision champ par champ à partir d’échantillons vérifiés, détectez les changements dans la répartition des données d’entrée et interrompez le traitement si la validation échoue.
L’intégration aux mainframes présente des risques particuliers pour les données. La conversion de nombres décimaux condensés COBOL en valeurs JSON à virgule flottante peut provoquer des erreurs d’arrondi qui s’accumulent au fil des transactions. Conservez les types décimaux, rapprochez les totaux et exécutez le nouveau calcul en parallèle du calcul existant avant de traiter des données financières réelles.
Quantifiez tout écart à partir de données de production vérifiées, plutôt que d’avancer un montant de perte inventé.
Pour éviter cela, vous devez mettre en place dans le middleware une couche stricte de préservation des types décimaux. Les déploiements en parallèle sont indispensables. Acheminez 5% du trafic réel vers le modèle mis à jour, comparez ses résultats à ceux du système existant et consignez les écarts.
Puis patientez. Ne faites passer le modèle sur le trafic principal que lorsque le taux d’erreur est inférieur à 0.5% et que le système a démontré sa stabilité.
Suivez les niveaux de service à l’aide de définitions explicites, de journaux et d’un responsable chargé de réagir en cas de dégradation des performances. Les exemples de gains de productivité obtenus ailleurs ne prouvent pas ce qu’un autre flux de travail permettra d’accomplir.
Étape 3 : quels cas d’usage de l’automatisation des flux de travail privilégier pour la mise en production ?
Les meilleurs cas d’usage à mettre en production sont les processus à fort volume, peu sujets aux exceptions et déterministes, avec un parcours clair de transfert à une personne en cas de besoin. Le traitement des factures, l’orientation des demandes clients et l’analyse des contrats en sont des exemples. Nous sélectionnons exclusivement ce type de processus.
Cet avantage est décisif. Bien choisir les cas d’usage constitue la dernière étape d’une bonne optimisation des flux de travail par l’automatisation IA et permet à votre plateforme de tenir ses promesses en conditions réelles.
C’est un taux de conversion dérisoire. Le passage en production exige des garde-fous stricts pour la plateforme, mais il reste tout à fait possible. En imposant des protocoles de test rigoureux et des mécanismes de repli adaptés, vous rejoignez la minorité d’entreprises qui obtiennent un rendement mesurable de leurs investissements dans l’IA.
Nous utilisons cette matrice de décision pour sélectionner les cas d’usage sans hésitation. Elle évite de décider à l’aveugle.
| Critère | Traitement des factures | Analyse des contrats | Tri des e-mails |
|---|---|---|---|
| Volume | Élevé | Moyen | Élevé |
| Taux d’exceptions | Faible | Moyen | Élevé |
| Délai de retour sur investissement | 9.8 mois | 14.2 mois | 18+ mois |
| Complexité de l’intégration | Faible | Élevée | Moyenne |
En ciblant les bons processus, vous raccourcissez considérablement le délai de retour sur investissement et libérez des fonds pour financer les prochaines initiatives d’automatisation.
Un système en production doit disposer d’une surveillance, d’alertes et d’une logique de repli. Sans exception. Si le moteur IA tombe en panne, le traitement doit être confié par défaut à une personne, sans perdre l’événement ni corrompre les données.
C’est une exigence absolue. Nous concevons chaque pipeline d’orchestration avec des mécanismes de fonctionnement dégradé automatiques qui garantissent qu’aucune donnée ne sera perdue, même en cas de panne majeure de l’infrastructure.
Conclusion : gagner en efficacité à grande échelle grâce à l’automatisation IA
Améliorer l’efficacité d’une entreprise grâce à l’IA exige des techniques avancées d’optimisation des flux de travail automatisés. Impossible de faire semblant. Les organisations doivent concilier des objectifs d’automatisation ambitieux avec une rigueur opérationnelle sans faille dans chaque service.
Négliger cet équilibre, c’est tomber dans le piège des 41 % d’échecs. Et mettre des carrières en péril. Si vous privilégiez la vitesse au détriment de la stabilité, vous finirez par déployer des systèmes fragiles qui tombent en panne lors des pics de charge et sapent la confiance de la direction dans votre stratégie technique.
Cette approche demande de la discipline. Il faut prévoir une intervention humaine dans les décisions, des pipelines pilotés par les événements et un suivi minutieux des indicateurs de référence pour éviter l’explosion des coûts et la baisse de précision. N’automatisez pas des processus défaillants.
C’est la pire erreur à commettre. Corrigez d’abord le processus sous-jacent : vos outils d’IA pourront alors générer les rendements exponentiels qui justifient cet investissement massif.
Le passage de la RPA fondée sur des règles à une orchestration dynamique de l’IA est achevé. Les anciennes méthodes ont fait leur temps. Les entreprises qui maîtrisent ces techniques d’intégration domineront leur marché.
Celles qui négligent les garde-fous opérationnels brûleront rapidement leur capital. Nous vous le garantissons. À vous de choisir : développez dès maintenant une capacité d’orchestration rigoureuse, ou regardez vos concurrents utiliser l’IA pour grignoter méthodiquement vos parts de marché.
Voilà ce que recouvrent concrètement les techniques d’optimisation des flux de travail automatisés par l’IA.
Ne naviguez plus à vue. Lancez-vous avec une feuille de route claire.
Livraison rapide. Résultats mesurables. Sécurité avant tout.
Questions fréquentes
