
Agentów AI w n8n możesz tworzyć, łącząc model czatu, pamięć i narzędzia w wizualnym węźle AI Agent. Z tego przewodnika dowiesz się, jak wdrożyć produkcyjny system RAG, koordynować pracę wielu agentów i rozpoznać, kiedy sposób wykonywania procesów w n8n ogranicza złożone rozumowanie.
- n8n umożliwia tworzenie agentów AI w przystępnym edytorze wizualnym z użyciem frameworka LangChain. Dzięki temu możesz połączyć modele LLM z ponad 400 narzędziami biznesowymi bez pisania kodu.
- Produkcyjne procesy AI wymagają podejścia hybrydowego: n8n często obsługuje integracje z usługami SaaS, a usługi tworzone na zamówienie odpowiadają za złożone rozumowanie. Pozwala to uniknąć problemów z opóźnieniami i zarządzaniem stanem.
- Licencja Sustainable Use License ogranicza sposoby, w jakie agencje mogą zarabiać na n8n. Zanim zaoferujesz klientom n8n jako usługę zarządzaną, sprawdź jej warunki.
- Aby zbudować w n8n system RAG gotowy do pracy na produkcji, trzeba rozdzielić proces pobierania danych od procesu obsługi zapytań. Pozwala to zachować szybkość i niezawodność wraz ze wzrostem skali.
Krok 1: poznaj podstawowe elementy, zanim zaczniesz tworzyć agentów AI w n8n
Tworząc agenta AI w n8n, łączysz cztery odrębne elementy. Wyobraź sobie kuchnię restauracyjną: model czatu jest szefem kuchni, pamięć to jego notatki z przepisami, a narzędzia to przybory kuchenne. Prompt systemowy jest natomiast konkretnym zamówieniem klienta.
n8n udostępnia osobny węzeł AI Agent oparty na frameworku LangChain, dlatego każdy z tych czterech elementów trzeba poprawnie skonfigurować. n8n obsługuje modele czatu OpenAI, Claude od Anthropic, Google Gemini oraz modele lokalne przez Ollama. Modele dostępne w 2026 roku, takie jak GPT-4o czy Claude 3.5 Opus, zapewniają zdolność rozumowania.
Pamięć agenta w n8n może korzystać z prostego bufora okna konwersacji albo baz danych, takich jak Postgres i Redis, gdy sesje są dłuższe.
Bez skonfigurowanej pamięci agent zapomina wcześniejszy kontekst. Bez narzędzi potrafi tylko rozmawiać, nie może działać. Niejasne prompty, brak projektu zarządzania stanem i nieograniczony dostęp do narzędzi to częste przyczyny awarii.
Przed wdrożeniem przetestuj pamięć, uprawnienia do narzędzi i odzyskiwanie sprawności na reprezentatywnych przykładach. Niestrukturyzowane prompty i brak pamięci były przyczyną 40% awarii agentów. Osoby wdrażające agentów często zostawiają prompt systemowy na koniec, choć to właśnie on określa ścisłe zasady działania szefa kuchni.
Tak wygląda podstawowy przepływ w agencie n8n. Przed wdrożeniem pierwszego agenta trzymaj się tej listy kontrolnej: - [ ] Wybierz model czatu (OpenAI, Anthropic lub Ollama) - [ ] Skonfiguruj węzeł pamięci (Postgres lub Window Buffer) - [ ] Napisz precyzyjny prompt systemowy określający zasady - [ ] Dodaj co najmniej jedno narzędzie umożliwiające działanie
Najważniejszy wniosek: Agent AI jest tylko tak dobry, jak jego prompt i narzędzia. Opanuj te cztery podstawowe elementy, zanim zaczniesz zwiększać skalę.
Czym n8n różni się od LangGraph przy złożonym rozumowaniu?
Wybierz n8n, gdy wystarczą integracje wizualne i rutynowe kierowanie zadań. Jeśli proces wymaga złożonych rozgałęzień, odzyskiwania sprawności lub testów trudnych do przedstawienia na grafie wizualnym, wybierz framework kodowy z zarządzaniem stanem. Sprawdź obie opcje na tym samym reprezentatywnym procesie.
| Cecha | n8n | LangGraph |
|---|---|---|
| Próg wejścia | Niski (interfejs wizualny) | Wysoki (wymaga kodowania) |
| Zarządzanie stanem | Podstawowe, sekwencyjne | Złożone rozgałęzienia i pętle |
| Najlepsze zastosowanie | Integracje SaaS, RAG | Wieloetapowe pętle rozumowania |
| Utrzymanie SDK | Nie jest potrzebne | Wymaga dużego nakładu pracy |
Na tym polega różnica. Tworząc agentów AI w n8n, zyskujesz szybkość wdrożenia kosztem szczegółowej kontroli w kodzie.
Najważniejszy wniosek: Nie zmuszaj n8n do obsługi złożonego rozumowania, z którym sobie nie radzi. Niech będzie punktem wejścia, a cięższą pracę zostaw Pythonowi.
Krok 2: skonfiguruj produkcyjny system RAG z dwoma procesami
Dobierz narzędzie do zadania. Sprawny produkcyjny system RAG w n8n składa się z dwóch procesów: jeden pobiera dane, drugi obsługuje zapytania. Początkujący często próbują zmieścić oba zadania w jednym procesie, co prowadzi do wielokrotnego przetwarzania tych samych dokumentów i uszkodzenia indeksów wektorowych.
Trzeba je rozdzielić. n8n obsługuje popularne bazy wektorowe, w tym Pinecone, Qdrant i Supabase, oraz wariant działający w pamięci, przeznaczony do testów. Nie używaj wariantu działającego w pamięci na produkcji: jego zawartość znika przy każdym ponownym uruchomieniu serwera.
Konfiguracja procesu pobierania danych 1. Uruchamiaj proces, gdy w magazynie plików (Google Drive lub S3) pojawi się nowy plik. 2. Wyodrębnij tekst za pomocą węzła do wczytywania dokumentów. 3. Podziel tekst na fragmenty za pomocą odpowiedniego węzła. Każdy fragment powinien mieć około 500 tokenów. 4. Wygeneruj osadzenia za pomocą węzła modelu OpenAI lub modelu lokalnego. 5. Zapisz wektory w Pinecone lub Supabase.
Konfiguracja procesu obsługi zapytań 1. Zacznij od wyzwalacza czatu lub webhooka, który odbierze pytania użytkowników. 2. Połącz narzędzie pobierające dane z bazy wektorowej z węzłem AI Agent. 3. Przekaż pytanie użytkownika do narzędzia, aby przeszukało bazę wektorową. 4. Przekaż znaleziony kontekst z powrotem do modelu czatu. 5. Wygeneruj końcową odpowiedź. Oto przykładowe dane zwrócone przez narzędzie wyszukiwania.
{
 "query": "What is our remote work policy?",
 "matches": [
 {
 "score": 0.92,
 "text": "Employees can work remotely 3 days a week."
 }
 ]
}
Wykonaj te kroki, jeśli chcesz tworzyć w n8n agentów AI odpowiadających na pytania na podstawie danych Twojej firmy. Rozdzielenie procesów pozwala pobierać dane asynchronicznie i utrzymać krótki czas odpowiedzi. Gdy użytkownik zada pytanie, agent jedynie odpytuje bazę.
Najważniejszy wniosek: Oddzielne procesy pobierania danych i obsługi zapytań pozwalają utrzymać szybkość produkcyjnego systemu RAG i ułatwiają zarządzanie nim.
Jak koordynować pracę wielu agentów w n8n?
Koordynacja wielu agentów w n8n polega na łączeniu pojedynczych agentów AI w sekwencyjne procesy. Jeden agent może przekazać zadanie drugiemu za pomocą AI Agent Tool. Nie jest to w pełni autonomiczna grupa agentów, która sama organizuje swoją pracę.
Wiele osób błędnie zakłada, że agenci będą dynamicznie uzgadniać między sobą działania. n8n nie obsługuje takich autonomicznych grup od razu po instalacji. Umożliwia za to uporządkowane przekazywanie zadań. Agent główny otrzymuje prompt, a następnie wywołuje agenta pomocniczego przez AI Agent Tool.
Typowe zastosowania agentów w n8n obejmują obsługę klienta, kwalifikację leadów, RAG, tworzenie szkiców wiadomości e-mail, analizę danych i wewnętrzny helpdesk. Możesz na przykład stworzyć agenta kwalifikującego leady, który przekaże dane kontaktowe agentowi analitycznemu do uzupełnienia.
Zanim zbudujesz w n8n agentów AI działających według tego schematu, uwzględnij ograniczenia: - Utrata kontekstu: przekazanie pełnego stanu między agentami wymaga starannego zaprojektowania promptów. - Opóźnienia: każde wywołanie agenta wydłuża czas komunikacji z dostawcą modelu LLM. - Obsługa błędów: jeśli agent pomocniczy zawiedzie, agent główny często zmyśla odpowiedź.
Aby bezpiecznie wdrożyć taki układ, ustal ścisłe zasady przekazywania zadań. Agent główny powinien przekazywać agentowi pomocniczemu wyłącznie ustrukturyzowany JSON. Agent pomocniczy powinien odczytać te dane, wykonać zadanie i zwrócić odpowiedź w ściśle określonym formacie JSON.
{
  "task": "enrich_lead",
  "input_data": {
    "company_name": "Acme Corp",
    "domain": "acme.com"
  }
}
Bez takiej struktury agenci nie będą się rozumieć. Szybko zużyją tokeny, nie kończąc zadań.
Najważniejszy wniosek: Miej realistyczne oczekiwania wobec procesów z wieloma agentami. n8n dobrze radzi sobie z sekwencyjnym przekazywaniem zadań, a nie z dynamiczną, autonomiczną współpracą.
Krok 3: monitoruj działanie modeli LLM za pomocą Langfuse
Agenci szybko zużywają tokeny, nie kończąc zadań. Większość poradników dla początkujących pomija monitorowanie ich działania. Jeśli nie widzisz kosztów tokenów ani opóźnień, nie wiesz, co dzieje się wewnątrz agenta.
Dane wejściowe i wyjściowe modelu LLM trzeba śledzić równie dokładnie jak odsetek pomyślnie wykonanych procesów. Sposób wykonywania procesów w n8n wprowadza dodatkowy narzut, który przy dużej skali może powodować opóźnienia odczuwalne nawet przy czasie odpowiedzi poniżej sekundy. Każdy węzeł dodaje kolejne milisekundy.
Zanim żądanie dotrze do modelu LLM, wróci i przejdzie przez węzły wizualne, opóźnienie może stać się nieakceptowalne. Langfuse to platforma open source do pracy z modelami LLM.
Śledzi wersje promptów, koszty tokenów i jakość odpowiedzi. Aby przesyłać do Langfuse dane o wykonaniu procesów n8n, skonfiguruj własny węzeł żądania HTTP, który po każdym wywołaniu modelu LLM wyśle dane śledzenia. AI Workflow Builder w n8n potrafi wygenerować podstawowego agenta z promptu tekstowego, ale takim agentom brakuje monitorowania potrzebnego na produkcji.
Musisz dodać je samodzielnie. Nie zakładaj, że prompt tekstowy wygeneruje cały stos produkcyjny.
Kalkulator miesięcznego kosztu tokenów
Oszacuj miesięczne wydatki na API modeli LLM dla agentów n8n.
Oszacuj koszty tokenów, zanim zwiększysz skalę. Jeśli tworzysz agentów AI w n8n, monitorowanie ich działania jest konieczne.
Najważniejszy wniosek: Od razu zintegruj Langfuse. Śledzenie danych wejściowych i wyjściowych modeli LLM jest niezbędne do wykrywania opóźnień i przekroczeń kosztów na produkcji.
Chcesz sprawdzić, co AI może usprawnić w Twojej firmie?
Realizacja w 3-5 dni roboczych. Bez zobowiązań.
Inne spojrzenie: dlaczego n8n nie rozwiąże wszystkich problemów w złożonych procesach AI
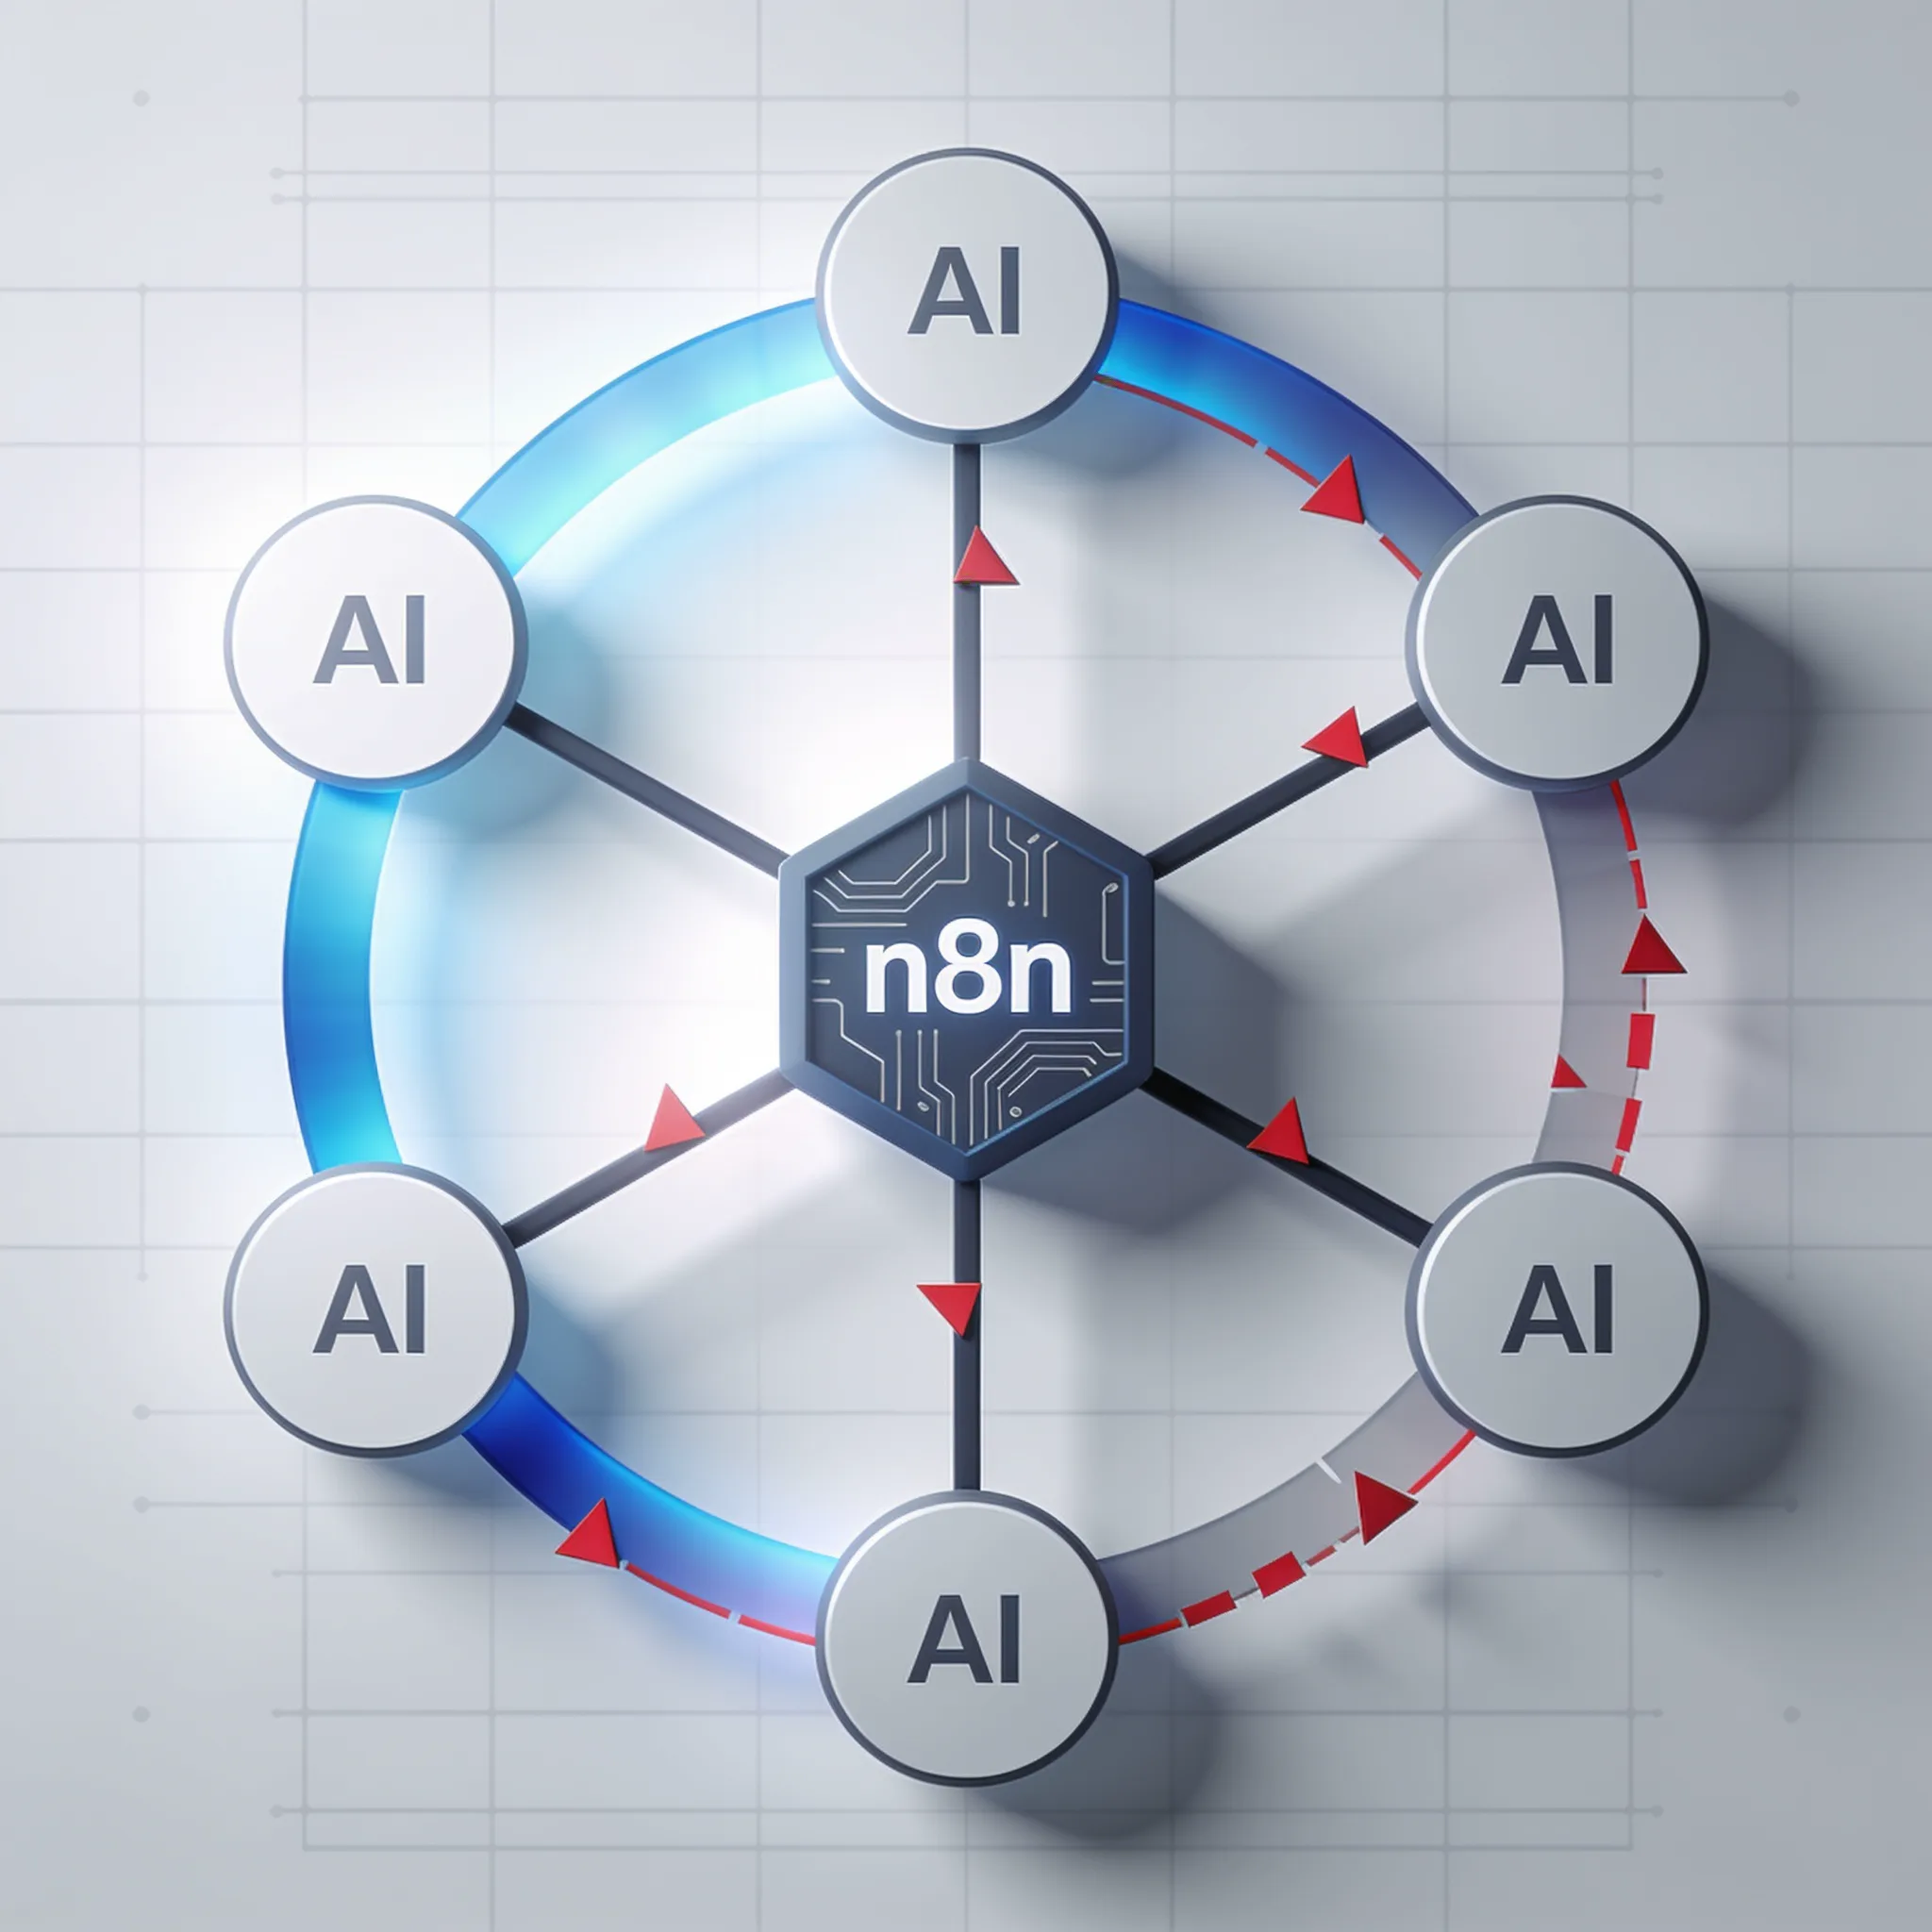
To zabezpieczenie przed niekontrolowanymi rachunkami za API i awariami, które pozostają niezauważone. Wizualne narzędzia do budowania procesów nie poradzą sobie z każdym zadaniem AI. W 2026 roku popularne jest przekonanie, że platformy no-code mogą całkowicie zastąpić zespoły inżynieryjne.
To niebezpieczny mit. Wizualny model wykonywania procesów w n8n ma nieunikniony narzut, który przy dużej skali powoduje opóźnienia. Każdy węzeł to operacja JavaScript interpretowana podczas działania.
Platforma ma też trudności ze złożonym rozgałęzianiem zależnym od stanu. Jeśli agent musi pięć razy wrócić do wcześniejszego etapu na podstawie złożonej logiki, wizualny schemat staje się nieczytelny.
To częste ograniczenie narzędzi wizualnych. Gdy logika wykracza poza możliwości schematu, trzeba wiedzieć, kiedy zrezygnować z n8n. W systemach produkcyjnych n8n często służy do przyjmowania żądań i orkiestracji, a za złożone rozumowanie odpowiada LangGraph lub kod napisany w Pythonie.
Nie zmuszaj wizualnego narzędzia do pracy, którą lepiej wykona skrypt w Pythonie. Kiedy n8n się nie sprawdza? - Strumienie danych o dużej przepustowości: mechanizm przetwarzania węzłów nie radzi sobie wydajnie z tysiącami równoczesnych zdarzeń.
- Rozumowanie cykliczne: pętle z warunkowym zakończeniem komplikują logikę wizualnego procesu. - Niestandardowe obliczenia matematyczne: węzeł kodu jest dostępny, ale niewygodny przy zaawansowanym przetwarzaniu danych. Budując agentów AI w n8n, traktuj tę platformę jak inteligentny router.
Najważniejszy wniosek: Wiedz, kiedy zrezygnować z n8n. Używaj go do przyjmowania żądań i podstawowej orkiestracji, a złożone rozumowanie powierz usługom napisanym w Pythonie.
Licencja Sustainable Use License: co muszą wiedzieć agencje i konsultanci
n8n odbiera żądanie, sprawdza uprawnienia, zapisuje zdarzenie i przekazuje dane do osobnej usługi odpowiedzialnej za rozumowanie. Platforma działa na licencji Sustainable Use License, a nie na standardowej licencji open source uznawanej przez OSI. Dla osób wdrażających rozwiązania to ważne rozróżnienie, ponieważ licencja ogranicza możliwość oferowania n8n jako usługi zarządzanej.
Nie możesz hostować n8n, dodać własnego interfejsu i sprzedawać całości jako swojego produktu SaaS. n8n działa jednak w modelu fair-code i można je hostować samodzielnie.
Dzięki temu firmy mogą uruchamiać agentów na własnej infrastrukturze i przechowywać dane u siebie. Agencje i konsultanci nadal mogą zgodnie z prawem budować i wdrażać agentów dla klientów. Nie mogą jedynie oferować samego n8n jako hostowanego produktu.
Jeśli jako konsultant budujesz agentów AI w n8n, zalecamy przestrzeganie tych zasad: - Wdrażaj n8n na infrastrukturze klienta (AWS, DigitalOcean lub jego własnych serwerach). - Przekaż klientowi własność procesów. - Nie pobieraj od klientów miesięcznej opłaty za dostęp do hostowanej przez siebie instancji n8n.
- Pobieraj opłaty za pracę nad rozwiązaniem i bieżące utrzymanie instancji hostowanej przez klienta.
Najważniejszy wniosek: Przestrzeganie warunków licencji jest obowiązkowe. Wdrażaj rozwiązanie na infrastrukturze klienta i pobieraj opłaty za swoją wiedzę, nie za wynajem oprogramowania.
Krok 4: Rozwijaj firmę dzięki integracjom n8n z usługami SaaS
Zanim zaczniesz, sprawdź, czy znasz ograniczenia licencyjne. n8n udostępnia ponad 400 integracji z aplikacjami jako narzędzia dla agentów. Dzięki temu agenci mogą odczytywać dane z CRM, wysyłać wiadomości w Slack, odpytywać bazy danych i bezpośrednio wywoływać API.
Jahanzaib podaje również, że n8n ma łącznie około 1,000 integracji, Make około 1,500, a Zapier 8,000+. Nie sugeruj się samymi liczbami. Zapier wygrywa liczbą integracji, a n8n głębokością ich wykorzystania, zwłaszcza gdy budujesz agentów AI w n8n i udostępniasz integracje bezpośrednio modelowi LLM jako funkcje, które może wywoływać.
Zapier nie udostępnia agentowi całego katalogu swoich aplikacji jako natywnych narzędzi w ten sam sposób.
Wszystko wskazuje na to, że przyszłość oprogramowania dla firm należy do agentów AI korzystających z API, a nie do ludzi klikających w interfejsach. Oto jak podłączyć narzędzie CRM do agenta w n8n. 1.
Dodaj narzędzie HTTP Request do węzła AI Agent. 2. Nazwij je "Fetch_HubSpot_Contact".
3. Napisz dla modelu LLM jasny opis: "Użyj tego narzędzia, gdy użytkownik pyta o dane konkretnego kontaktu". 4.
Skonfiguruj węzeł HTTP tak, aby wywoływał API HubSpot. 5. Przekaż wyodrębnioną z zapytania użytkownika informację, na przykład adres e-mail, jako parametr zapytania.
{
 "method": "GET",
 "url": "https://api.hubapi.com/crm/v3/objects/contacts",
 "authentication": "genericCredentialType",
 "genericAuthType": "httpHeaderAuth",
 "sendQuery": true,
 "queryParameters": {
 "parameters": [
 {
 "name": "email",
 "value": "={{ $json.email }}"
 }
 ]
 }
}
Oto konfiguracja węzła HTTP. Twój agent może teraz działać: pobiera aktualne dane, na których opiera swoje odpowiedzi.
Najważniejszy wniosek: Sposób wykorzystania integracji ma większe znaczenie niż ich liczba. Udostępnij agentom ponad 400 narzędzi n8n, aby zamienić statyczne procesy w dynamiczne systemy.
Nie zgaduj. Zacznij wdrażać rozwiązania z konkretnym planem.
Szybka realizacja. Mierzalne rezultaty. Bezpieczeństwo na pierwszym miejscu.
Najczęściej zadawane pytania
