Pour créer des agents IA avec n8n, associez un modèle de chat, une mémoire et des outils dans le nœud visuel AI Agent. Ce guide explique comment déployer un système RAG en production, coordonner plusieurs agents et reconnaître les limites du modèle d’exécution de n8n face aux raisonnements complexes.
Vous développez avec des modèles d’IA ? Le crédit API AIGROW donne accès aux modèles Claude, GPT, Gemini et Grok jusqu’à 75 % moins cher que le prix public.
- n8n permet de créer visuellement des agents IA avec le framework LangChain et de connecter des LLM à plus de 400 outils métier, sans écrire de code.
- En production, les workflows IA nécessitent souvent une approche hybride : n8n pour intégrer les services SaaS et des services sur mesure pour les raisonnements complexes, afin d’éviter les problèmes de latence et de gestion de l’état.
- La Sustainable Use License encadre la manière dont les agences peuvent tirer des revenus de n8n. Il est donc essentiel d’en comprendre les conditions avant de le proposer aux clients comme service géré.
- Pour qu’un système RAG créé avec n8n reste rapide et fiable à grande échelle en production, il faut séparer le workflow d’ingestion de celui des requêtes.
Étape 1 : comprendre les composants essentiels avant de créer des agents IA avec n8n
Créer des agents IA avec n8n revient à assembler quatre composants distincts. Imaginez une cuisine professionnelle : le modèle de chat est le chef, la mémoire contient ses notes de recettes et les outils sont ses ustensiles. Le prompt système, lui, correspond à la commande précise du client.
n8n utilise un nœud AI Agent dédié, fondé sur le framework LangChain. Vous devez donc configurer correctement ces quatre composants. Parmi les modèles de chat compatibles avec n8n figurent ChatGPT, Claude, Gemini et les modèles locaux exécutés avec Ollama.
Ollama exécute les modèles : choisissez celui qui répond aux besoins de raisonnement et de confidentialité de votre workflow. La mémoire des agents n8n peut reposer sur un simple tampon de messages récents ou sur des bases comme Postgres et Redis pour les sessions plus longues.
Sans mémoire configurée, votre agent oublie le contexte. Sans outils, il peut seulement parler, pas agir. Les prompts imprécis, l’absence de gestion de l’état et les outils aux permissions trop larges sont des causes fréquentes d’échec.
Avant le déploiement, testez la mémoire, les permissions des outils et la reprise après incident sur des cas représentatifs. Les prompts non structurés et l’absence de mémoire ont causé 40% des échecs d’agents. Les équipes opérationnelles relèguent souvent le prompt système au second plan, alors qu’il définit les règles strictes qui régissent le comportement du chef.
Voici le fonctionnement d’un agent n8n de base. Avant de déployer votre premier agent, suivez cette liste de vérification : - [ ] Choisir un modèle de chat (OpenAI, Anthropic ou Ollama) - [ ] Configurer un nœud de mémoire (Postgres ou Window Buffer) - [ ] Rédiger un prompt système strict qui définit les règles - [ ] Ajouter au moins un outil permettant d’agir
À retenir : La qualité d’un agent IA dépend de son prompt et de ses outils. Maîtrisez ces quatre composants avant de passer à plus grande échelle.
Quelle différence entre n8n et LangGraph pour les raisonnements complexes ?
Choisissez n8n si les intégrations visuelles et l’acheminement courant suffisent à vos besoins. Préférez un framework de code avec gestion de l’état si votre workflow exige des branchements complexes, une reprise après incident ou des tests difficiles à représenter dans un graphe visuel. Comparez les deux solutions sur le même workflow représentatif.
| Critère | n8n | LangGraph |
|---|---|---|
| Courbe d’apprentissage | Faible (visuel) | Élevée (code nécessaire) |
| Gestion de l’état | Séquentielle, simple | Branchements cycliques complexes |
| Cas d’usage idéal | Intégration SaaS, RAG | Raisonnement en plusieurs étapes avec boucles |
| Maintenance du SDK | Aucune | Importante |
Voilà comment ils se comparent. En créant des agents IA avec n8n, vous gagnez en rapidité de déploiement, mais renoncez à une partie du contrôle offert par le code.
À retenir : Ne confiez pas à n8n des raisonnements complexes qu’il ne peut pas gérer. Utilisez-le comme point d’entrée et laissez Python prendre en charge le plus exigeant.
Étape 2 : mettre en place un système RAG en production avec deux workflows
À chaque tâche son outil. Un système RAG exploitable en production avec n8n comporte deux workflows : l’un pour l’ingestion, l’autre pour les requêtes. Les débutants essaient souvent de tout réunir dans un seul flux, au risque de retraiter les mêmes documents et de corrompre les index vectoriels.
Séparez ces deux fonctions. n8n prend en charge les principales bases vectorielles, dont Pinecone, Qdrant et Supabase, ainsi qu’une option en mémoire pour les tests. N’utilisez pas cette dernière en production : son contenu est réinitialisé à chaque redémarrage du serveur.
Configurer le workflow d’ingestion 1. Déclenchez le workflow lorsqu’un nouveau fichier arrive dans votre espace de stockage (Google Drive ou S3). 2. Extrayez le texte avec un nœud de chargement de documents. 3. Découpez le texte en segments avec le nœud prévu à cet effet. Visez environ 500 tokens par segment. 4. Générez les embeddings avec un nœud utilisant un modèle OpenAI ou local. 5. Enregistrez les vecteurs dans Pinecone ou Supabase.
Configurer le workflow de requêtes 1. Utilisez un déclencheur de chat ou un webhook pour recevoir les questions des utilisateurs. 2. Reliez un outil de recherche dans la base vectorielle au nœud AI Agent. 3. Transmettez la requête de l’utilisateur à cet outil, qui interroge la base vectorielle. 4. Renvoyez le contexte trouvé au modèle de chat. 5. Générez la réponse finale. Voici un exemple de données renvoyées par l’outil de recherche.
{
 "query": "What is our remote work policy?",
 "matches": [
 {
 "score": 0.92,
 "text": "Employees can work remotely 3 days a week."
 }
 ]
}
Suivez ces étapes pour créer avec n8n des agents IA capables de répondre aux questions sur vos données internes. Cette séparation permet à l’ingestion de s’exécuter de façon asynchrone et limite la latence des requêtes. Lorsqu’un utilisateur pose une question, l’agent interroge uniquement la base de données.
À retenir : Séparer l’ingestion des requêtes est indispensable pour garder un système RAG en production rapide et facile à gérer.
Comment coordonner réellement plusieurs agents dans n8n ?
Dans n8n, coordonner plusieurs agents consiste à enchaîner des agents IA dans des pipelines séquentiels. Un agent peut déléguer une tâche à un autre grâce à AI Agent Tool. Il ne s’agit pas d’un collectif entièrement autonome qui s’organise seul.
Cette distinction échappe à beaucoup d’équipes opérationnelles. Elles s’attendent à ce que les agents négocient entre eux de façon dynamique. n8n ne prend pas en charge ce type de collectif autonome par défaut.
Il permet plutôt une délégation structurée : un agent principal reçoit un prompt, puis utilise AI Agent Tool pour solliciter un agent secondaire.
Dans n8n, les agents servent souvent au support client, à la qualification des leads, au RAG, à la rédaction d’e-mails, à l’analyse de données ou à l’assistance interne. Vous pouvez, par exemple, créer un agent de qualification des leads qui transmet un contact à un agent d’analyse de données pour enrichir sa fiche.
Avant de créer des agents IA avec n8n selon ce modèle, tenez compte de ces limites : - Perte de contexte : transmettre l’état complet entre agents demande une conception rigoureuse des prompts. - Latence : chaque appel à un agent ajoute un aller-retour vers le fournisseur du LLM. - Gestion des erreurs : si l’agent secondaire échoue, l’agent principal invente souvent une réponse.
Pour un déploiement sûr, définissez des protocoles de transfert stricts. L’agent principal ne doit transmettre que du JSON structuré à l’agent secondaire. Ce dernier doit analyser ce JSON, accomplir sa tâche et renvoyer une réponse JSON au format strict.
{
  "task": "enrich_lead",
  "input_data": {
    "company_name": "Acme Corp",
    "domain": "acme.com"
  }
}
Sans cette structure stricte, les agents communiquent sans se comprendre. Ils consomment rapidement des tokens sans mener les tâches à terme.
À retenir : Gardez des attentes réalistes pour les workflows multiagents. n8n excelle dans la délégation séquentielle, pas dans la collaboration autonome et dynamique.
Étape 3 : suivre le fonctionnement des LLM avec Langfuse
Ils consomment rapidement des tokens sans mener les tâches à terme. La plupart des tutoriels pour débutants négligent le suivi du fonctionnement. Si vous ne pouvez pas mesurer le coût en tokens et la latence, votre agent reste une boîte noire.
Suivez les entrées et les sorties du LLM avec autant de rigueur que les taux de réussite des workflows. Le modèle d’exécution de n8n ajoute une surcharge qui peut poser des problèmes de latence inférieure à la seconde à grande échelle. Chaque nœud ajoute quelques millisecondes.
Le temps que votre requête parvienne au LLM, que sa réponse revienne et traverse les nœuds visuels, le délai peut devenir inacceptable. Langfuse est une plateforme open source d’ingénierie des LLM.
Elle suit les versions des prompts, le coût en tokens et la qualité des réponses. Pour envoyer les journaux d’exécution de n8n vers Langfuse, configurez un nœud de requête HTTP personnalisé qui transmet les données de traçage après chaque appel au LLM. AI Workflow Builder de n8n peut générer un agent de départ à partir d’un prompt textuel.
Mais ces agents n’intègrent pas le suivi nécessaire en production : vous devez l’ajouter vous-même. Ne comptez pas sur un prompt textuel pour générer toute votre infrastructure de production.
Calculateur du coût mensuel en tokens
Estimez vos dépenses mensuelles en API de LLM pour vos agents n8n.
Estimez le coût potentiel en tokens avant de passer à plus grande échelle. Si vous créez des agents IA avec n8n, suivre leur fonctionnement est indispensable.
À retenir : Intégrez Langfuse dès le départ. Le suivi des entrées et des sorties du LLM est essentiel pour diagnostiquer les problèmes de latence et les dépassements de coûts en production.
Un autre point de vue : pourquoi n8n ne résout pas tous les problèmes des workflows IA complexes
C’est votre assurance contre les factures d’API qui s’emballent et les pannes silencieuses. Les outils de création visuels ne conviennent pas à toutes les charges de travail de l’IA. En 2026, on entend souvent que les plateformes no-code peuvent remplacer entièrement les équipes d’ingénierie.
C’est un mythe dangereux. Le modèle d’exécution visuel de n8n ajoute une surcharge inévitable, qui crée des problèmes de latence à grande échelle. Chaque nœud correspond à une opération JavaScript interprétée à l’exécution.
La plateforme peine aussi à gérer les états avec des branchements complexes. Si votre agent doit revenir cinq fois sur ses propres étapes selon une logique nuancée, le canevas visuel devient vite inextricable.
Cette rigidité est fréquente dans les outils visuels. Dès que la logique dépasse les capacités du canevas, vous atteignez leurs limites. Il faut savoir quand sortir de n8n.
En production, n8n sert souvent de point d’entrée et de couche d’orchestration, tandis que LangGraph ou du Python sur mesure prend en charge les raisonnements complexes. N’imposez pas au canevas visuel ce qu’un script Python fait mieux. Dans quels cas n8n atteint-il ses limites ?
- Flux de données à haut débit : le traitement des nœuds ne gère pas efficacement des milliers d’événements simultanés. - Raisonnement cyclique : les boucles avec sorties conditionnelles mettent en défaut la logique du flux visuel. - Logique mathématique sur mesure : le nœud de code existe, mais il est peu pratique pour les transformations de données lourdes.
Quand vous créez des agents IA avec n8n, considérez-le comme un routeur intelligent.
À retenir : Sachez quand sortir de n8n. Utilisez-le pour recevoir les requêtes et assurer l’orchestration de base, mais confiez les raisonnements complexes à des services Python sur mesure.
Comprendre la Sustainable Use License pour les agences et les consultants
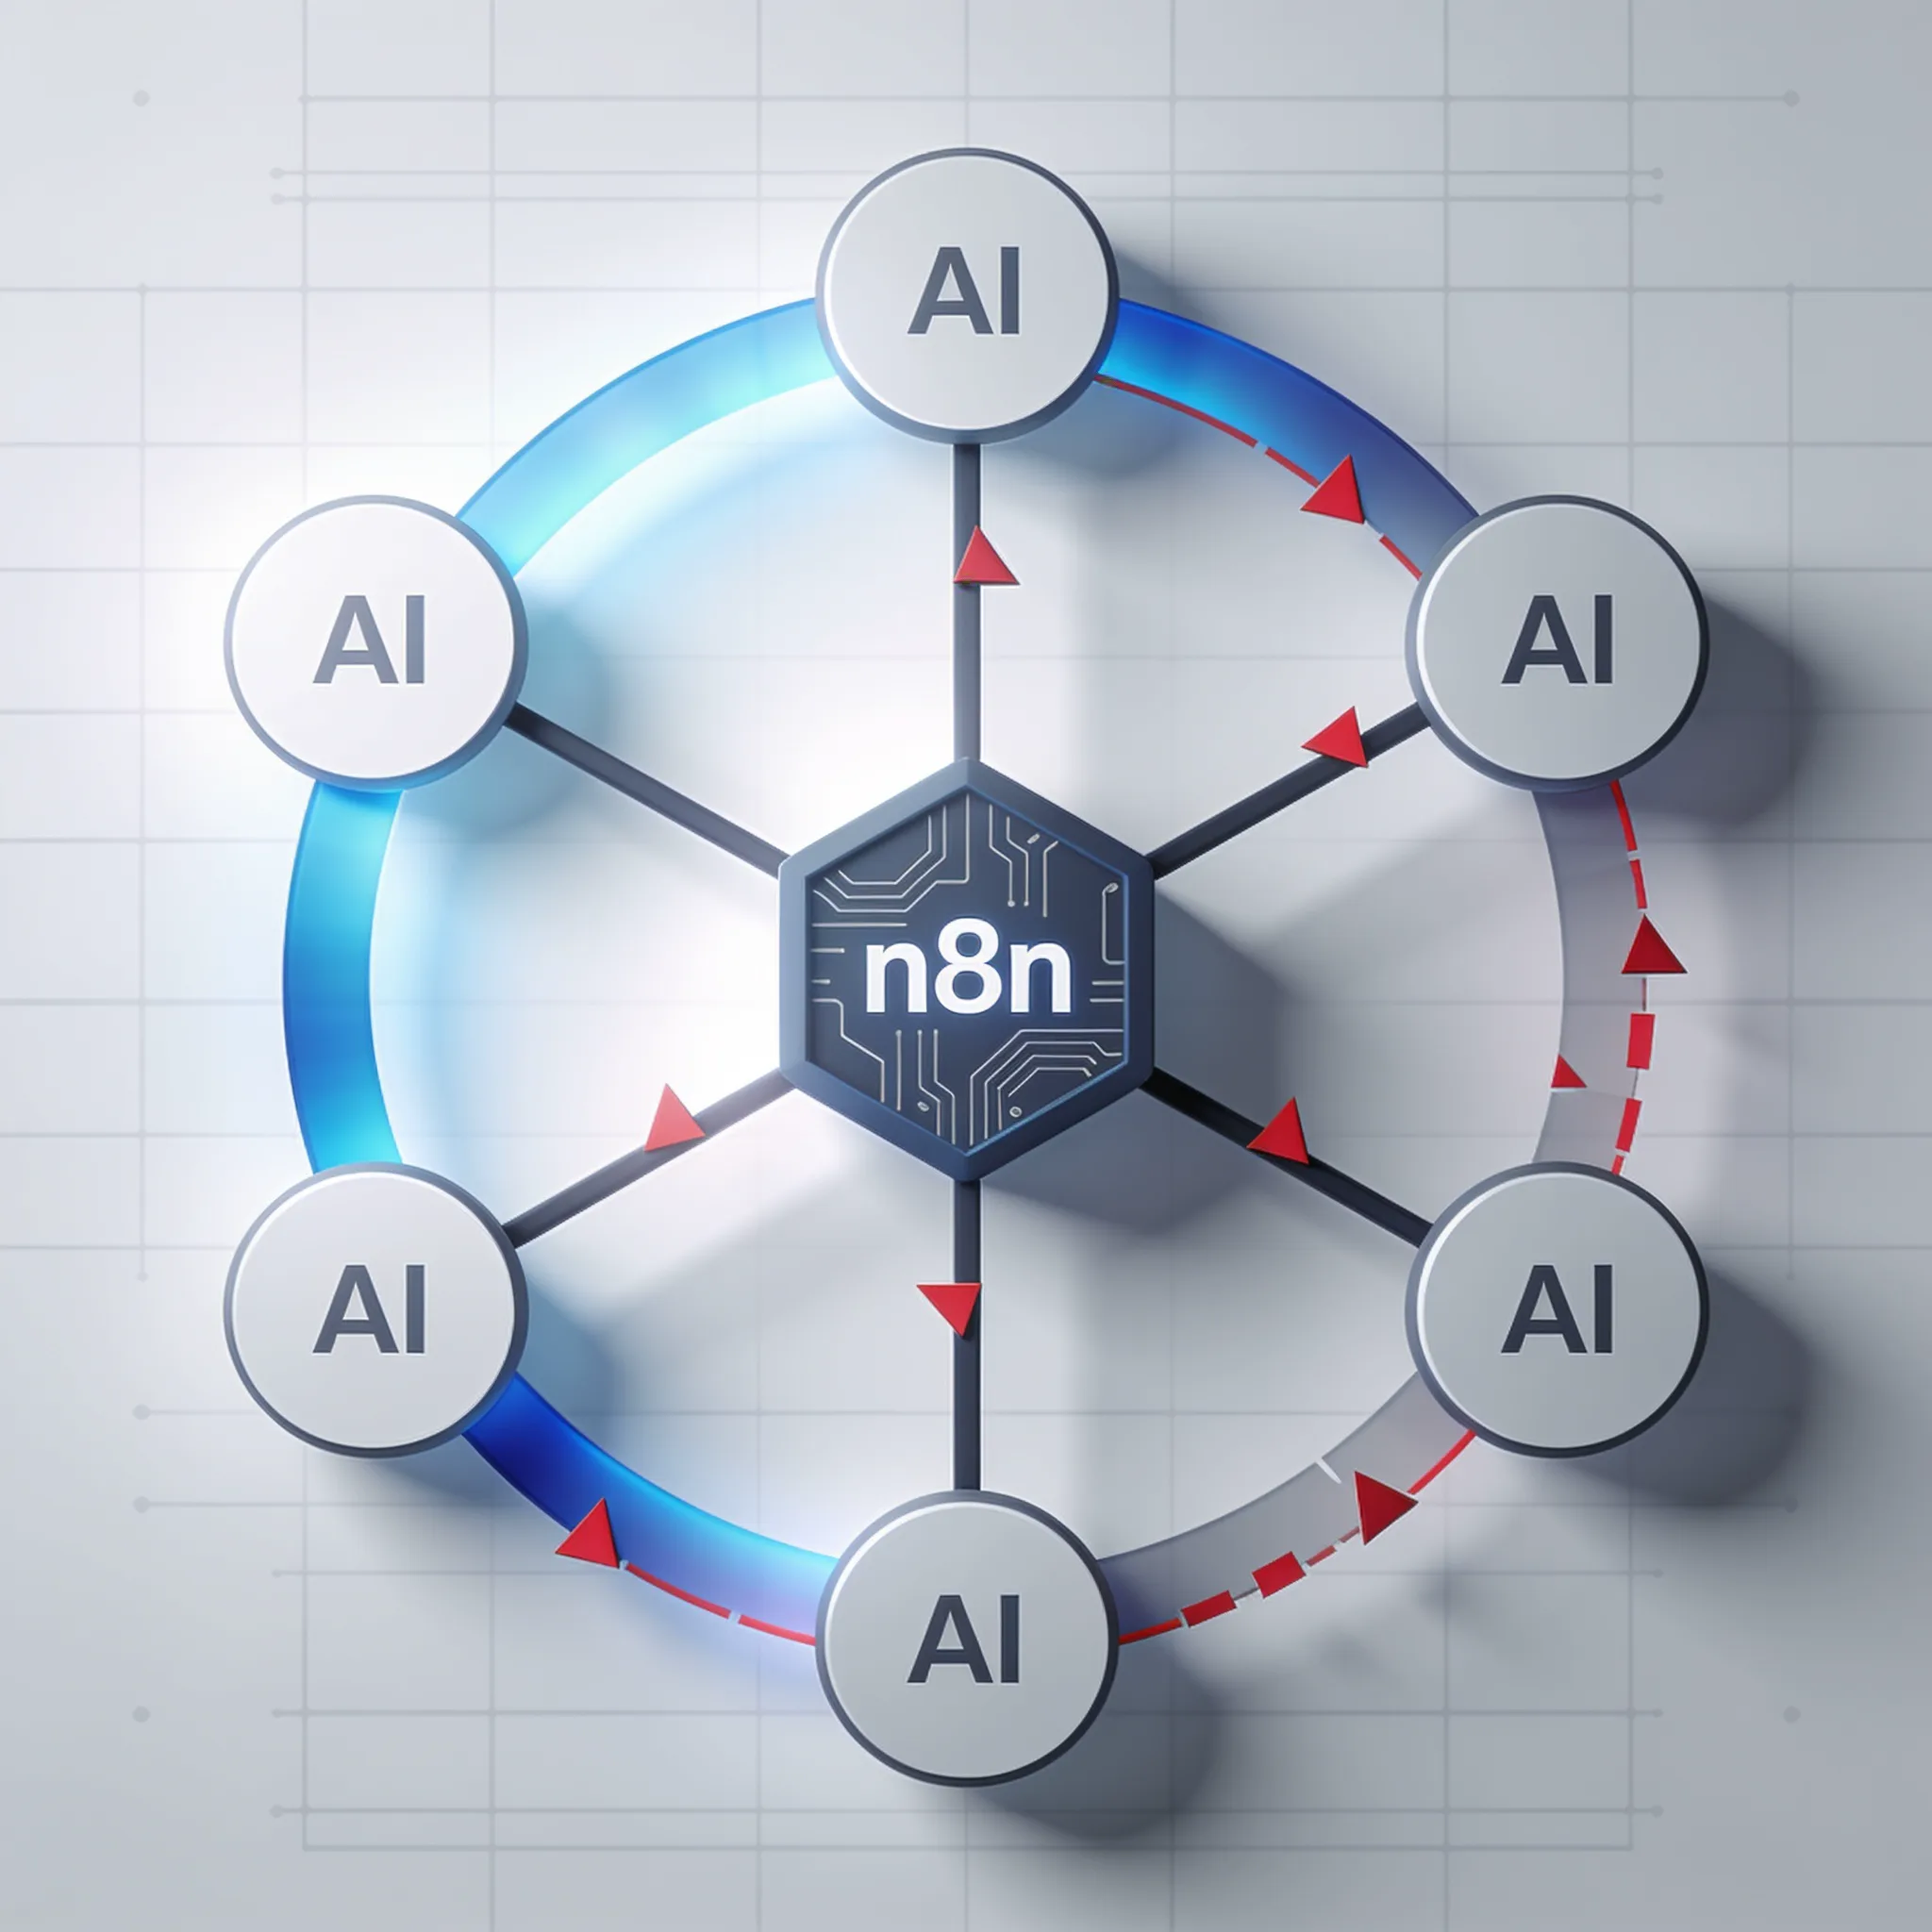
Il reçoit la requête, vérifie l’authentification, journalise l’événement et transmet les données à un service dédié au raisonnement. n8n est régi par la Sustainable Use License, et non par une licence open source standard reconnue par l’OSI. Cette distinction est essentielle pour les équipes qui l’exploitent : la licence limite la possibilité de le proposer comme service géré.
Vous ne pouvez pas héberger n8n, lui ajouter une interface personnalisée et le vendre comme votre propre SaaS. En revanche, n8n relève du fair-code et peut être auto-hébergé.
Les entreprises peuvent ainsi exécuter des agents sur leur propre infrastructure et conserver leurs données en interne. Les agences et les consultants peuvent légalement créer et déployer des agents pour leurs clients. Ils ne peuvent simplement pas vendre n8n lui-même comme produit hébergé.
Si vous créez des agents IA avec n8n pour vos clients, nous vous recommandons de suivre ces règles : - Déployez n8n sur l’infrastructure du client (AWS, DigitalOcean ou ses serveurs sur site). - Transférez au client la propriété des workflows. - Ne facturez pas aux clients un abonnement mensuel pour accéder à votre instance n8n hébergée.
- Facturez votre temps de développement et la maintenance continue de leur instance auto-hébergée.
À retenir : Le respect de la licence n’est pas négociable. Déployez sur l’infrastructure du client et facturez votre expertise, pas la location du logiciel.
Étape 4 : développer votre activité grâce aux intégrations SaaS de n8n
Vérifiez que vous maîtrisez les implications de cette licence. n8n permet d’utiliser ses plus de 400 intégrations d’applications comme outils. Les agents peuvent ainsi consulter un CRM, envoyer des messages Slack, interroger des bases de données ou appeler directement des API.
Jahanzaib indique également que n8n compte environ 1 000 intégrations au total, contre environ 1,500 pour Make et plus de 8 000 pour Zapier. Ne vous laissez pas impressionner par les chiffres bruts. Zapier mise sur le volume.
n8n offre davantage de profondeur, surtout quand vous créez des agents IA avec n8n et mettez ces intégrations directement à la disposition du LLM sous forme de fonctions appelables. Zapier ne permet pas, de la même manière, de mettre nativement tout son catalogue d’applications à la disposition de l’agent comme outils.
La tendance est claire : l’avenir des logiciels d’entreprise passe par des agents IA qui interagissent avec les API, plutôt que par des humains qui cliquent dans des interfaces. Voici comment connecter un outil CRM à un agent n8n. 1.
Ajoutez un outil HTTP Request à votre nœud AI Agent. 2. Nommez l’outil « Fetch_HubSpot_Contact ».
3. Rédigez une description claire pour le LLM : « Utilisez cet outil quand l’utilisateur demande les coordonnées d’un contact précis. » 4.
Configurez le nœud HTTP pour appeler l’API HubSpot. 5. Transmettez une information extraite de la demande de l’utilisateur, comme une adresse e-mail, en paramètre de requête.
{
 "method": "GET",
 "url": "https://api.hubapi.com/crm/v3/objects/contacts",
 "authentication": "genericCredentialType",
 "genericAuthType": "httpHeaderAuth",
 "sendQuery": true,
 "queryParameters": {
 "parameters": [
 {
 "name": "email",
 "value": "={{ $json.email }}"
 }
 ]
 }
}
Voici la configuration du nœud HTTP. Votre agent peut désormais agir : il récupère des données en temps réel pour fonder ses réponses.
À retenir : La stratégie d’intégration compte plus que le nombre d’intégrations. Mettez les 400+ outils n8n à la disposition de vos agents pour transformer des workflows statiques en systèmes dynamiques.
Modèles Claude, GPT, Gemini et Grok actuels, jusqu’à 75 % moins cher que le tarif public
Une seule clé API pour les modèles Claude, GPT, Gemini et Grok, via le SDK OpenAI. Les modèles Claude fonctionnent aussi avec le SDK Anthropic et Claude Code.
Le tarif de chaque modèle via le crédit AIGROW figure à côté du prix public de son éditeur, jamais au-dessus.
Questions fréquentes
