Puoi creare agenti AI con n8n combinando un modello di chat, una memoria e degli strumenti nel nodo visivo AI Agent. Questa guida spiega come implementare un sistema RAG in produzione, coordinare più agenti e riconoscere i limiti del modello di esecuzione di n8n nei ragionamenti complessi.
Sviluppi con modelli AI? Il credito API AIGROW ti permette di usare i modelli Claude, GPT, Gemini e Grok fino al 75% sotto il prezzo di listino.
- n8n offre un modo visivo e accessibile per creare agenti AI con il framework LangChain, collegando gli LLM a oltre 400 strumenti aziendali senza scrivere codice.
- I workflow AI pronti per la produzione richiedono un approccio ibrido: spesso n8n gestisce le integrazioni SaaS, mentre servizi personalizzati si occupano dei ragionamenti complessi per evitare problemi di latenza e di gestione dello stato.
- La Sustainable Use License limita i modi in cui le agenzie possono monetizzare n8n. Prima di offrirlo ai clienti come servizio gestito, è quindi essenziale conoscerne le condizioni.
- Per creare con n8n un sistema RAG pronto per la produzione, occorre separare i workflow di acquisizione dei dati e di interrogazione, così da mantenere velocità e affidabilità anche su larga scala.
Passaggio 1: conosci i componenti essenziali prima di creare agenti AI con n8n
Quando crei agenti AI con n8n, metti insieme quattro componenti distinti. Pensa alla cucina di un ristorante: il modello di chat è lo chef, la memoria è il suo ricettario e gli strumenti sono gli utensili. Il prompt di sistema, invece, è l’ordine specifico del cliente.
n8n implementa gli agenti AI con un nodo AI Agent dedicato, basato sul framework LangChain. Devi quindi configurare correttamente tutti e quattro i componenti. I modelli di chat supportati da n8n includono ChatGPT, Claude, Gemini e modelli locali eseguiti tramite Ollama.
Ollama esegue i modelli: scegline uno adatto alle esigenze di ragionamento e riservatezza del workflow. Per la memoria degli agenti, n8n può usare un semplice buffer a finestra oppure database come Postgres e Redis per le sessioni più lunghe.
Se non configuri la memoria, l’agente dimentica ciò che è successo. Se non aggiungi strumenti, può solo parlare, non agire. Prompt poco chiari, una gestione dello stato non progettata e strumenti senza restrizioni sono cause frequenti di errore.
Prima del deployment, verifica il comportamento della memoria, i permessi degli strumenti e il recupero dagli errori con casi rappresentativi. Prompt non strutturati e memoria assente hanno causato il 40% degli errori degli agenti. Chi gestisce i workflow spesso considera il prompt di sistema un dettaglio secondario.
In realtà, contiene le regole rigorose che governano il comportamento dello chef.
Questo è il flusso di un agente n8n di base. Prima di distribuire il tuo primo agente, ti consigliamo di seguire rigorosamente questa checklist: - [ ] Scegli un modello di chat (OpenAI, Anthropic o Ollama) - [ ] Configura un nodo di memoria (Postgres o Window Buffer) - [ ] Scrivi un prompt di sistema rigoroso che definisca le regole - [ ] Collega almeno uno strumento per eseguire azioni
Da ricordare: La qualità di un agente AI dipende dai suoi prompt e strumenti. Padroneggia i quattro componenti essenziali prima di ampliare il sistema.
Qual è la differenza tra n8n e LangGraph per i ragionamenti complessi?
Usa n8n quando le integrazioni visive e lo smistamento delle attività di routine soddisfano i requisiti. Scegli un framework scritto in codice che gestisca lo stato quando il workflow richiede diramazioni complesse, recupero dagli errori o test difficili da rappresentare nel grafo visivo. Verifica la scelta usando lo stesso workflow rappresentativo.
| Caratteristica | n8n | LangGraph |
|---|---|---|
| Curva di apprendimento | Bassa (visuale) | Alta (richiede codice) |
| Gestione dello stato | Sequenziale di base | Diramazioni cicliche complesse |
| Utilizzo ideale | Integrazioni SaaS, RAG | Cicli di ragionamento in più passaggi |
| Manutenzione dell’SDK | Nessuna | Elevata |
Ecco il confronto. Quando crei agenti AI con n8n, rinunci a parte del controllo approfondito via codice in cambio di una distribuzione più rapida.
Da ricordare: Non costringere n8n a gestire ragionamenti complessi per cui non è adatto. Usalo come punto di ingresso e affida a Python il lavoro più impegnativo.
Passaggio 2: configura un sistema RAG di produzione con due workflow
Usa lo strumento giusto per ogni compito. Un sistema RAG utilizzabile in produzione con n8n prevede due workflow: uno per l’acquisizione dei dati e uno per le interrogazioni. Chi è agli inizi spesso cerca di concentrare tutto in un unico flusso, causando elaborazioni duplicate dei documenti e indici vettoriali non funzionanti.
Devi separare queste attività. n8n supporta i principali database vettoriali, tra cui Pinecone, Qdrant e Supabase, oltre a un’opzione in memoria per i test. Non usare l’opzione in memoria in produzione: si azzera a ogni riavvio del server.
Configurare il workflow di acquisizione 1. Avvia il workflow quando un nuovo file arriva nello spazio di archiviazione (Google Drive o S3). 2. Estrai il testo con un nodo di caricamento dei documenti. 3. Suddividi il testo in blocchi con il nodo di suddivisione del testo. Mantieni i blocchi intorno ai 500 token. 4. Genera gli embedding con un nodo OpenAI o un modello locale. 5. Salva i vettori in Pinecone o Supabase.
Configurare il workflow di interrogazione 1. Parti da un trigger di chat o da un webhook per ricevere le domande degli utenti. 2. Collega al nodo AI Agent uno strumento per il recupero dei dati dal database vettoriale. 3. Passa la domanda dell’utente allo strumento, che cerca nel database vettoriale. 4. Rimanda il contesto recuperato al modello di chat. 5. Genera la risposta finale. Ecco un esempio di payload restituito dallo strumento di recupero.
{
 "query": "What is our remote work policy?",
 "matches": [
 {
 "score": 0.92,
 "text": "Employees can work remotely 3 days a week."
 }
 ]
}
Segui questi passaggi per creare con n8n agenti AI capaci di rispondere a domande sui tuoi dati proprietari. La separazione rende asincrona la pipeline di acquisizione e mantiene bassa la latenza delle interrogazioni. Quando un utente fa una domanda, l’agente interroga soltanto il database.
Da ricordare: Separare i workflow di acquisizione e interrogazione è essenziale per mantenere i sistemi RAG di produzione rapidi e gestibili.
Come si coordina davvero un sistema multiagente in n8n?
In n8n, coordinare più agenti significa collegare singoli agenti AI in pipeline sequenziali, nelle quali un agente può delegare attività a un altro tramite AI Agent Tool. Non si tratta di uno sciame completamente autonomo e capace di organizzarsi da sé.
Molti interpretano male questa funzione e si aspettano che gli agenti negozino dinamicamente tra loro. n8n non supporta gli sciami autonomi già pronti all’uso. Supporta invece una delega strutturata: un agente principale riceve un prompt, poi usa AI Agent Tool per chiamare un agente secondario.
Tra gli schemi più comuni in n8n ci sono agenti per l’assistenza clienti, la qualificazione dei lead, i sistemi RAG, la stesura di email, l’analisi dei dati e l’helpdesk interno. Per esempio, puoi creare un agente che qualifica i lead e passa il lavoro a un agente di analisi dei dati per arricchire le informazioni sul contatto.
Prima di creare agenti AI con n8n secondo questo schema, considera questi limiti: - Perdita di contesto: passare l’intero stato tra agenti richiede una progettazione attenta dei prompt. - Latenza: ogni chiamata a un agente aggiunge il tempo di andata e ritorno verso il fornitore dell’LLM. - Gestione degli errori: se l’agente secondario non riesce a completare il compito, quello principale spesso inventa una risposta.
Per distribuire il sistema in sicurezza, definisci protocolli di passaggio rigorosi. L’agente principale dovrebbe inviare a quello secondario solo JSON strutturato. L’agente secondario deve interpretare il JSON, svolgere il compito e restituire una risposta JSON con una struttura rigorosa.
{
  "task": "enrich_lead",
  "input_data": {
    "company_name": "Acme Corp",
    "domain": "acme.com"
  }
}
Senza questa struttura, gli agenti non riescono a capirsi. Consumano rapidamente token senza portare a termine le attività.
Da ricordare: Tieni conto dei limiti dei workflow multiagente. n8n funziona bene per la delega sequenziale, non per una collaborazione autonoma e dinamica.
Passaggio 3: integra il monitoraggio degli LLM con Langfuse
Consumano rapidamente token senza portare a termine le attività. La maggior parte dei tutorial per principianti trascura il monitoraggio. Se non puoi vedere i costi dei token e la latenza, il tuo agente è una scatola nera.
Devi monitorare gli input e gli output dell’LLM con lo stesso rigore con cui controlli i tassi di successo dei workflow. Il modello di esecuzione di n8n aggiunge un carico che, su larga scala, può creare problemi quando serve una latenza inferiore al secondo. Ogni nodo aggiunge millisecondi.
Tra l’invio della richiesta all’LLM, la risposta e l’elaborazione nei nodi visivi, i ritardi possono diventare inaccettabili. Langfuse è una piattaforma open source per lo sviluppo di applicazioni LLM.
Tiene traccia delle versioni dei prompt, dei costi dei token e della qualità degli output. Puoi inviare i log di esecuzione di n8n a Langfuse configurando un nodo di richiesta HTTP personalizzato che trasmetta i dati di tracciamento dopo ogni chiamata all’LLM. AI Workflow Builder di n8n può generare un agente iniziale a partire da un prompt testuale.
Questi agenti, però, non includono il monitoraggio necessario in produzione: devi aggiungerlo manualmente. Non affidarti a un prompt testuale per generare l’intera infrastruttura di produzione.
Calcolatore del costo mensile dei token
Stima la spesa mensile per le API LLM degli agenti n8n.
Calcola i potenziali costi dei token prima di ampliare il sistema. Quando crei agenti AI con n8n, il monitoraggio non è facoltativo.
Da ricordare: Integra subito Langfuse. Monitorare gli input e gli output dell’LLM è fondamentale per individuare problemi di latenza e costi eccessivi in produzione.
Il punto di vista controcorrente: perché n8n non è la soluzione per ogni workflow AI complesso
È la tua polizza assicurativa contro costi API fuori controllo ed errori che passano inosservati. Gli strumenti di sviluppo visuale non sono adatti a ogni carico di lavoro AI. Nel 2026 è diffusa l'idea che le piattaforme no-code possano sostituire del tutto i team di ingegneria, ma è un mito pericoloso.
Il modello di esecuzione visuale di n8n introduce un sovraccarico intrinseco, che su larga scala causa problemi di latenza. Ogni nodo corrisponde a un'operazione JavaScript interpretata durante l'esecuzione. Inoltre, la piattaforma fatica a gestire stati con diramazioni complesse.
Se il tuo agente deve tornare sui propri passi cinque volte in base a una logica articolata, l'interfaccia visuale diventa un groviglio.
Questa rigidità è frequente negli strumenti visuali. Quando la logica supera le possibilità dell'interfaccia, chi gestisce il sistema si trova bloccato. Devi sapere quando uscire da n8n.
Nei sistemi in produzione, n8n viene spesso usato per ricevere richieste e orchestrare i processi, mentre LangGraph o Python personalizzato gestiscono il ragionamento complesso. Non costringere l'interfaccia visuale a fare ciò che uno script Python fa meglio. Quando n8n mostra i suoi limiti?
- Flussi di dati ad alto volume: il parser dei nodi non riesce a elaborare in modo efficiente migliaia di eventi simultanei. - Ragionamento ciclico: i cicli con uscite condizionali complicano la logica del flusso visuale. - Logica matematica personalizzata: il nodo di codice esiste, ma è poco pratico per trasformazioni impegnative dei dati.
Quando crei agenti AI con n8n, trattalo come un router intelligente.
Punto chiave: Sappi quando uscire da n8n. Usalo per ricevere richieste e per l'orchestrazione di base, ma affida il ragionamento complesso a servizi Python personalizzati.
Come orientarsi nella Sustainable Use License: indicazioni per agenzie e consulenti
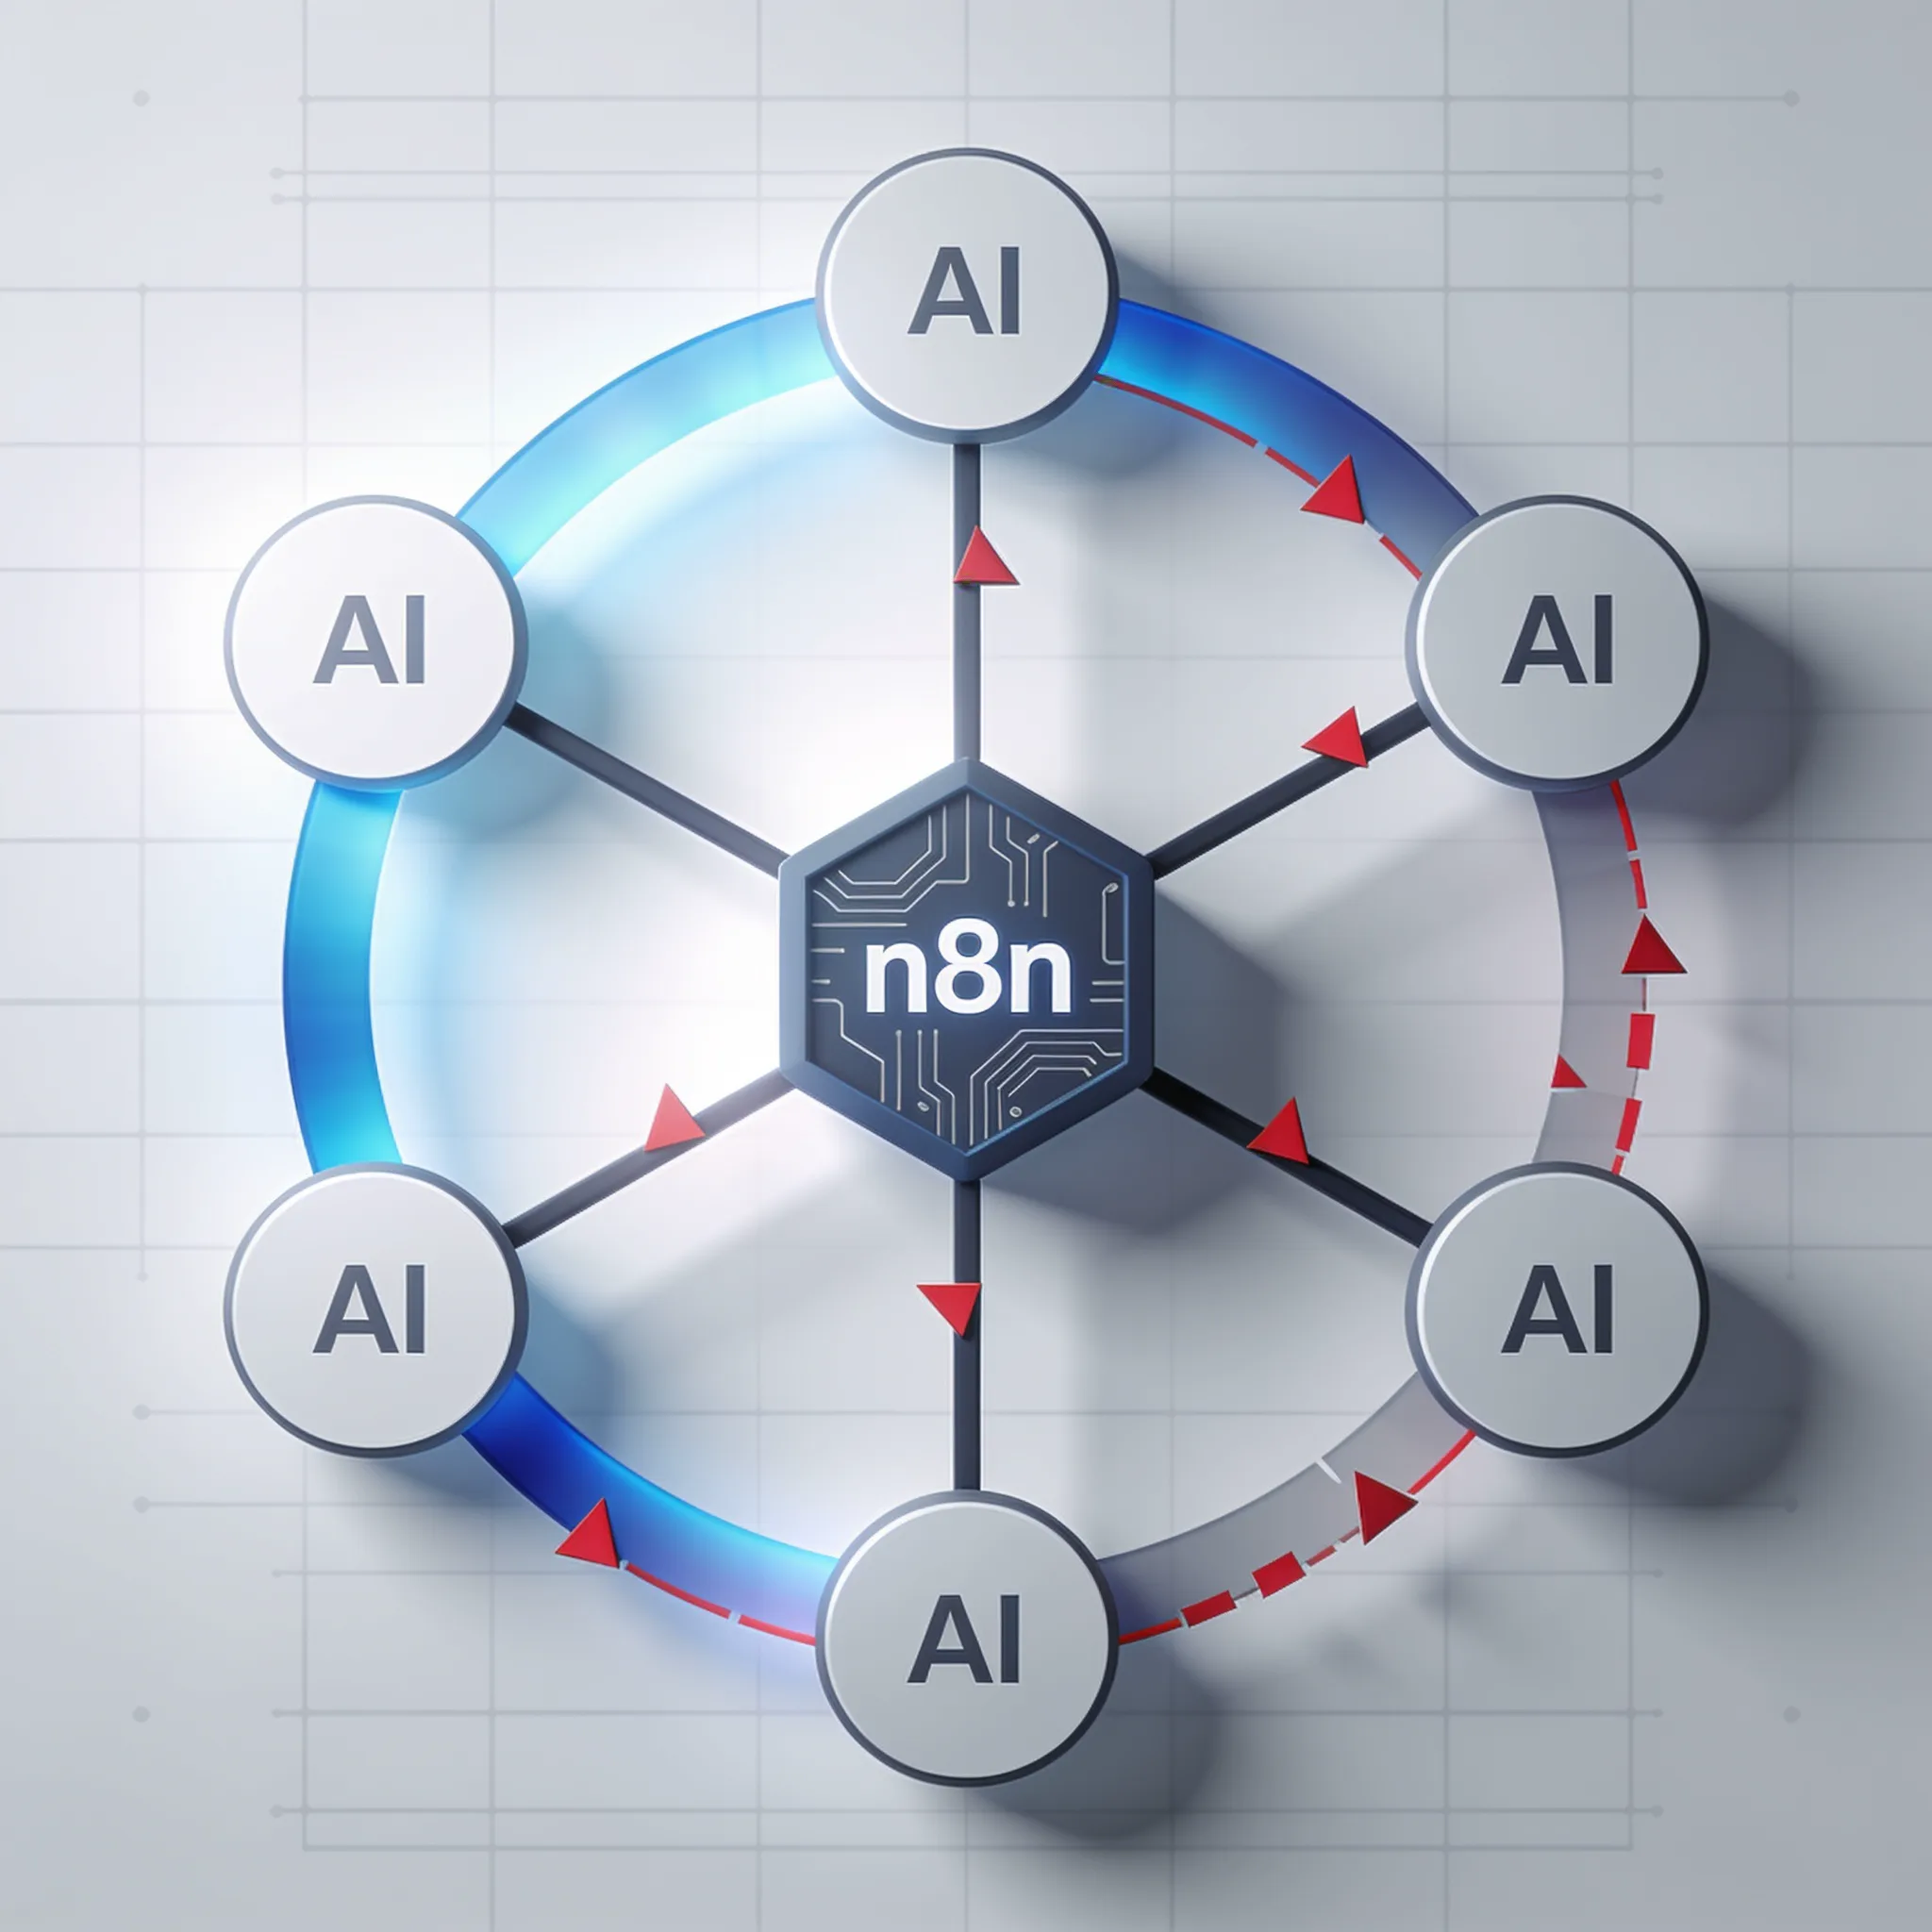
Riceve la richiesta, verifica l'autenticazione, registra l'evento e passa i dati a un servizio dedicato al ragionamento. n8n usa la Sustainable Use License, non una licenza open source standard riconosciuta dall'OSI. Per chi gestisce questi sistemi, la distinzione è fondamentale: la licenza limita la possibilità di offrire n8n come servizio gestito.
Non puoi ospitare n8n sui tuoi server, applicarvi un'interfaccia personalizzata e venderlo come un tuo SaaS. n8n è però fair-code e può essere ospitato autonomamente.
Questo consente alle aziende di eseguire gli agenti sulla propria infrastruttura e mantenere i dati al proprio interno. Agenzie e consulenti possono comunque sviluppare e distribuire legalmente agenti per i clienti. Non possono offrire n8n stesso come prodotto ospitato.
Se crei agenti AI con n8n per i tuoi clienti, ti consigliamo di seguire queste regole: - Installa n8n sull'infrastruttura del cliente (AWS, DigitalOcean o server presso la sua sede). - Trasferisci al cliente la proprietà dei flussi di lavoro. - Non addebitare ai clienti un canone mensile per accedere alla tua istanza n8n ospitata.
- Fai pagare il tempo dedicato allo sviluppo e alla manutenzione continuativa della loro istanza autonoma.
Punto chiave: Il rispetto della licenza non è facoltativo. Installa n8n sull'infrastruttura del cliente e fai pagare le tue competenze, non il noleggio del software.
Passaggio 4: fai crescere la tua attività con le integrazioni SaaS di n8n
Valuta se sei pronto ad affrontare le questioni legate alla licenza. n8n mette a disposizione degli agenti le sue oltre 400 integrazioni con app come strumenti. Gli agenti possono così leggere i dati di un CRM, inviare messaggi su Slack, interrogare database o chiamare direttamente le API.
Jahanzaib riferisce inoltre che n8n ha circa 1000 integrazioni in totale, Make circa 1,500 e Zapier oltre 8000. Non lasciarti ingannare dai numeri assoluti. Zapier offre quantità, n8n offre profondità, soprattutto quando crei agenti AI con n8n e rendi le integrazioni disponibili direttamente all'LLM come funzioni richiamabili.
Zapier non mette nativamente a disposizione dell'agente l'intero catalogo delle sue app come strumenti nello stesso modo.
La direzione è chiara: il futuro del software aziendale vede agenti AI che interagiscono con le API, anziché persone che fanno clic sulle interfacce. Ecco come collegare uno strumento CRM a un agente n8n. 1.
Aggiungi uno strumento HTTP Request al nodo AI Agent. 2. Chiamalo "Fetch_HubSpot_Contact".
3. Scrivi una descrizione chiara per l'LLM: "Usa questo strumento quando l'utente chiede i dettagli di un contatto specifico." 4.
Configura il nodo HTTP affinché chiami l'API di HubSpot. 5. Passa l'entità estratta dalla richiesta dell'utente (per esempio un'email) come parametro di query.
{
 "method": "GET",
 "url": "https://api.hubapi.com/crm/v3/objects/contacts",
 "authentication": "genericCredentialType",
 "genericAuthType": "httpHeaderAuth",
 "sendQuery": true,
 "queryParameters": {
 "parameters": [
 {
 "name": "email",
 "value": "={{ $json.email }}"
 }
 ]
 }
}
Questa è la configurazione del nodo HTTP. Ora il tuo agente può recuperare dati aggiornati per fondare le proprie risposte su informazioni reali.
Punto chiave: La strategia di integrazione conta più del numero di integrazioni. Metti gli oltre 400 strumenti di n8n a disposizione dei tuoi agenti per trasformare flussi di lavoro statici in sistemi dinamici.
Modelli Claude, GPT, Gemini e Grok attuali, fino al 75% sotto il prezzo di listino
Un'unica chiave API per i modelli Claude, GPT, Gemini e Grok sull'SDK di OpenAI. I modelli Claude funzionano anche con l'SDK di Anthropic e con Claude Code.
La tariffa di ogni modello tramite il credito AIGROW è indicata accanto al prezzo di listino del suo produttore e non lo supera mai.
Domande frequenti
