Puedes crear agentes de IA con n8n combinando un modelo de chat, memoria y herramientas en el nodo visual AI Agent. Esta guía explica cómo desplegar RAG en producción, coordinar varios agentes y reconocer cuándo el modelo de ejecución de n8n limita el razonamiento complejo.
¿Desarrollas con modelos de IA? El crédito de API de AIGROW ejecuta modelos de Claude, GPT, Gemini y Grok hasta un 75% por debajo del precio de lista.
- n8n ofrece una forma visual y accesible de crear agentes de IA con el framework LangChain. Permite conectar LLM con más de 400 herramientas empresariales sin escribir código.
- Los flujos de trabajo de IA para producción requieren un enfoque híbrido: suelen combinar n8n para integrar servicios SaaS con servicios personalizados para el razonamiento complejo y así evitar problemas de latencia y gestión del estado.
- La Sustainable Use License limita las formas en que las agencias pueden monetizar n8n. Por eso es fundamental conocer sus condiciones antes de ofrecerlo a clientes como servicio gestionado.
- Para crear un sistema RAG en n8n listo para producción, hay que separar los flujos de ingesta y consulta. Así se mantienen la velocidad y la fiabilidad a escala.
Paso 1: conoce los componentes básicos antes de crear agentes de IA con n8n
Al crear agentes de IA con n8n, en esencia ensamblas cuatro componentes distintos. Piensa en una cocina profesional. El modelo de chat es quien cocina, la memoria son sus notas con las recetas y las herramientas son los utensilios.
El prompt del sistema, por su parte, es el pedido concreto del cliente. n8n implementa los agentes de IA mediante un nodo AI Agent específico, basado en el framework LangChain. Por eso debes configurar bien los cuatro componentes.
Entre los modelos de chat compatibles con n8n están ChatGPT, Claude, Gemini y los modelos locales ejecutados mediante Ollama. Ollama ejecuta los modelos; elige uno que se ajuste a las necesidades de razonamiento y privacidad del flujo de trabajo. La memoria de los agentes en n8n puede usar un búfer de ventana sencillo o bases de datos como Postgres y Redis para sesiones más largas.
Si no configuras la memoria, tu agente olvidará lo ocurrido. Y si prescindes de las herramientas, solo podrá hablar: no podrá actuar. Los prompts poco claros, la falta de un diseño para gestionar el estado y las herramientas sin restricciones son causas habituales de fallo.
Antes del despliegue, prueba el comportamiento de la memoria, los permisos de las herramientas y la recuperación ante errores con casos representativos. Los prompts sin estructura y la falta de memoria causaron el 40% de los fallos de los agentes. Muchos equipos dejan el prompt del sistema para el final, cuando en realidad contiene las reglas estrictas que rigen el comportamiento de quien cocina.
Este es el flujo básico de un agente en n8n. Antes de desplegar tu primer agente, te recomendamos seguir esta lista al pie de la letra: - [ ] Elige un modelo de chat (OpenAI, Anthropic u Ollama) - [ ] Configura un nodo de memoria (Postgres o Window Buffer) - [ ] Escribe un prompt del sistema con reglas estrictas - [ ] Conecta al menos una herramienta que permita realizar acciones
Idea clave: La calidad de un agente de IA depende de su prompt y sus herramientas. Domina los cuatro componentes básicos antes de ampliar el sistema.
¿En qué se diferencian n8n y LangGraph para el razonamiento complejo?
Usa n8n cuando las integraciones visuales y el enrutamiento habitual cubran tus necesidades. Recurre a un framework con estado basado en código si el flujo requiere ramificaciones complejas, recuperación ante errores o pruebas difíciles de representar en un grafo visual. Evalúa ambas opciones con el mismo flujo de trabajo representativo.
| Característica | n8n | LangGraph |
|---|---|---|
| Curva de aprendizaje | Baja (visual) | Alta (requiere código) |
| Gestión del estado | Secuencial básica | Ramificaciones cíclicas complejas |
| Uso más adecuado | Integración SaaS, RAG | Bucles de razonamiento de varios pasos |
| Mantenimiento del SDK | Ninguno | Alto |
Así se comparan. Al crear agentes de IA con n8n, renuncias a parte del control mediante código a cambio de desplegarlos más rápido.
Idea clave: No fuerces a n8n a gestionar razonamientos complejos para los que no está preparado. Úsalo como punto de entrada y deja el trabajo pesado a Python.
Paso 2: configura un sistema RAG de producción con dos flujos de trabajo
Usa la herramienta adecuada para cada tarea. Un sistema RAG de producción viable en n8n tiene dos flujos de trabajo: uno para la ingesta y otro para las consultas. Quienes empiezan suelen intentar incluir ambas funciones en un solo flujo, lo que provoca que los documentos se procesen varias veces y que los índices vectoriales fallen.
Debes separarlas. n8n admite almacenes vectoriales importantes, como Pinecone, Qdrant y Supabase, además de una opción en memoria para pruebas. No uses esta última en producción: se reinicia cada vez que se reinicia el servidor.
Configurar el flujo de ingesta 1. Activa el flujo de trabajo cuando llegue un archivo nuevo a tu almacenamiento (Google Drive o S3). 2. Extrae el texto con un nodo de carga de documentos. 3. Divide el texto en fragmentos con el nodo de división de texto. Mantén los fragmentos en torno a 500 tokens. 4. Genera embeddings con un nodo de modelo OpenAI o local. 5. Guarda los vectores en Pinecone o Supabase.
Configurar el flujo de consultas 1. Comienza con un activador de chat o un webhook para recibir las preguntas de los usuarios. 2. Conecta una herramienta de recuperación del almacén vectorial al nodo AI Agent. 3. Envía la consulta del usuario a la herramienta. Esta buscará en la base de datos vectorial. 4. Devuelve el contexto recuperado al modelo de chat. 5. Genera la respuesta final. Este es un ejemplo de la carga útil de la herramienta de recuperación.
{
 "query": "What is our remote work policy?",
 "matches": [
 {
 "score": 0.92,
 "text": "Employees can work remotely 3 days a week."
 }
 ]
}
Sigue estos pasos para crear agentes de IA con n8n capaces de responder preguntas sobre tus datos propios. Al separar los flujos, la ingesta se ejecuta de forma asíncrona y la latencia de las consultas se mantiene baja. Cuando un usuario hace una pregunta, el agente solo consulta la base de datos.
Idea clave: Separar los flujos de ingesta y consulta es esencial para que los sistemas RAG de producción sigan siendo rápidos y fáciles de gestionar.
¿Cómo coordinar de verdad varios agentes en n8n?
En n8n, coordinar varios agentes consiste en encadenar agentes de IA individuales en procesos secuenciales, de modo que uno pueda delegar tareas en otro mediante AI Agent Tool. No es un conjunto de agentes plenamente autónomo que se organice por sí solo.
Muchos equipos esperan que los agentes negocien entre sí de forma dinámica. n8n no admite esa coordinación autónoma de forma nativa. Lo que ofrece es una delegación estructurada: un agente principal recibe un prompt y utiliza AI Agent Tool para llamar a un agente secundario.
Entre los usos habituales de agentes en n8n están la atención al cliente, la cualificación de leads, RAG, la redacción de borradores de correo, el análisis de datos y el soporte interno. Por ejemplo, puedes crear un agente que cualifique leads y después encargue a otro, especializado en análisis de datos, que amplíe la información de contacto.
Ten en cuenta estas limitaciones antes de crear agentes de IA con n8n siguiendo este patrón: - Pérdida de contexto: transferir todo el estado entre agentes exige diseñar los prompts con cuidado. - Latencia: cada llamada a un agente añade el tiempo de ida y vuelta al proveedor del LLM. - Gestión de errores: si falla el agente secundario, el principal suele inventar una respuesta.
Para desplegar este sistema con seguridad, define protocolos estrictos para el traspaso de tareas. El agente principal solo debe enviar JSON estructurado al secundario. Este debe interpretarlo, realizar su tarea y devolver una respuesta JSON con un formato estricto.
{
  "task": "enrich_lead",
  "input_data": {
    "company_name": "Acme Corp",
    "domain": "acme.com"
  }
}
Sin esta estructura, los agentes no se entienden. Consumen tokens rápidamente sin completar las tareas.
Idea clave: Ajusta tus expectativas sobre los flujos con varios agentes. n8n destaca en la delegación secuencial, no en la colaboración autónoma y dinámica.
Paso 3: incorpora observabilidad de LLM con Langfuse
Consumen tokens rápidamente sin completar las tareas. La mayoría de los tutoriales para principiantes pasan por alto la observabilidad. Si no puedes ver el coste en tokens y la latencia, tu agente es una caja negra.
Debes supervisar las entradas y salidas del LLM con el mismo rigor que las tasas de éxito del flujo de trabajo. El modelo de ejecución de n8n añade una carga que, a escala, puede causar problemas de latencia inferiores a un segundo. Cada nodo añade milisegundos.
Entre el envío de la solicitud al LLM, la recepción de la respuesta y su procesamiento por los nodos visuales, los retrasos pueden llegar a ser inaceptables. Langfuse es una plataforma de código abierto para la ingeniería de LLM.
Permite seguir las versiones de los prompts, el coste en tokens y la calidad de las respuestas. Puedes enviar los registros de ejecución de n8n a Langfuse configurando un nodo de solicitud HTTP personalizado que transmita datos de trazabilidad después de cada llamada al LLM. El AI Workflow Builder de n8n puede generar un agente inicial a partir de un prompt de texto, pero esos agentes no incluyen la observabilidad necesaria para producción.
Debes añadirla manualmente. No confíes en un prompt de texto para generar toda tu infraestructura de producción.
Calculadora del coste mensual en tokens
Estima tu gasto mensual en la API del LLM para agentes de n8n.
Calcula el posible coste en tokens antes de ampliar el sistema. Si creas agentes de IA con n8n, la observabilidad no es opcional.
Idea clave: Integra Langfuse desde el principio. Supervisar las entradas y salidas del LLM es fundamental para diagnosticar la latencia y los sobrecostes en producción.
La otra cara: por qué n8n no resuelve todos los flujos de IA complejos
Es tu protección frente a facturas descontroladas de API y fallos que pasan inadvertidos. Los editores visuales no sirven para todas las cargas de trabajo de IA. En 2026, se suele afirmar que las plataformas sin código pueden sustituir por completo a los equipos de ingeniería, pero es un mito peligroso.
El modelo de ejecución visual de n8n añade una sobrecarga inevitable que provoca problemas de latencia a gran escala. Cada nodo representa una operación de JavaScript que se interpreta en tiempo de ejecución. Además, la plataforma tiene dificultades para gestionar estados con ramificaciones complejas.
Si tu agente debe volver sobre sus pasos cinco veces según una lógica llena de matices, el lienzo visual se convierte en un enredo.
Esa rigidez suele venir de los editores visuales. Cuando la lógica supera lo que permite el lienzo, te encuentras con un límite. Debes saber cuándo dejar de usar n8n.
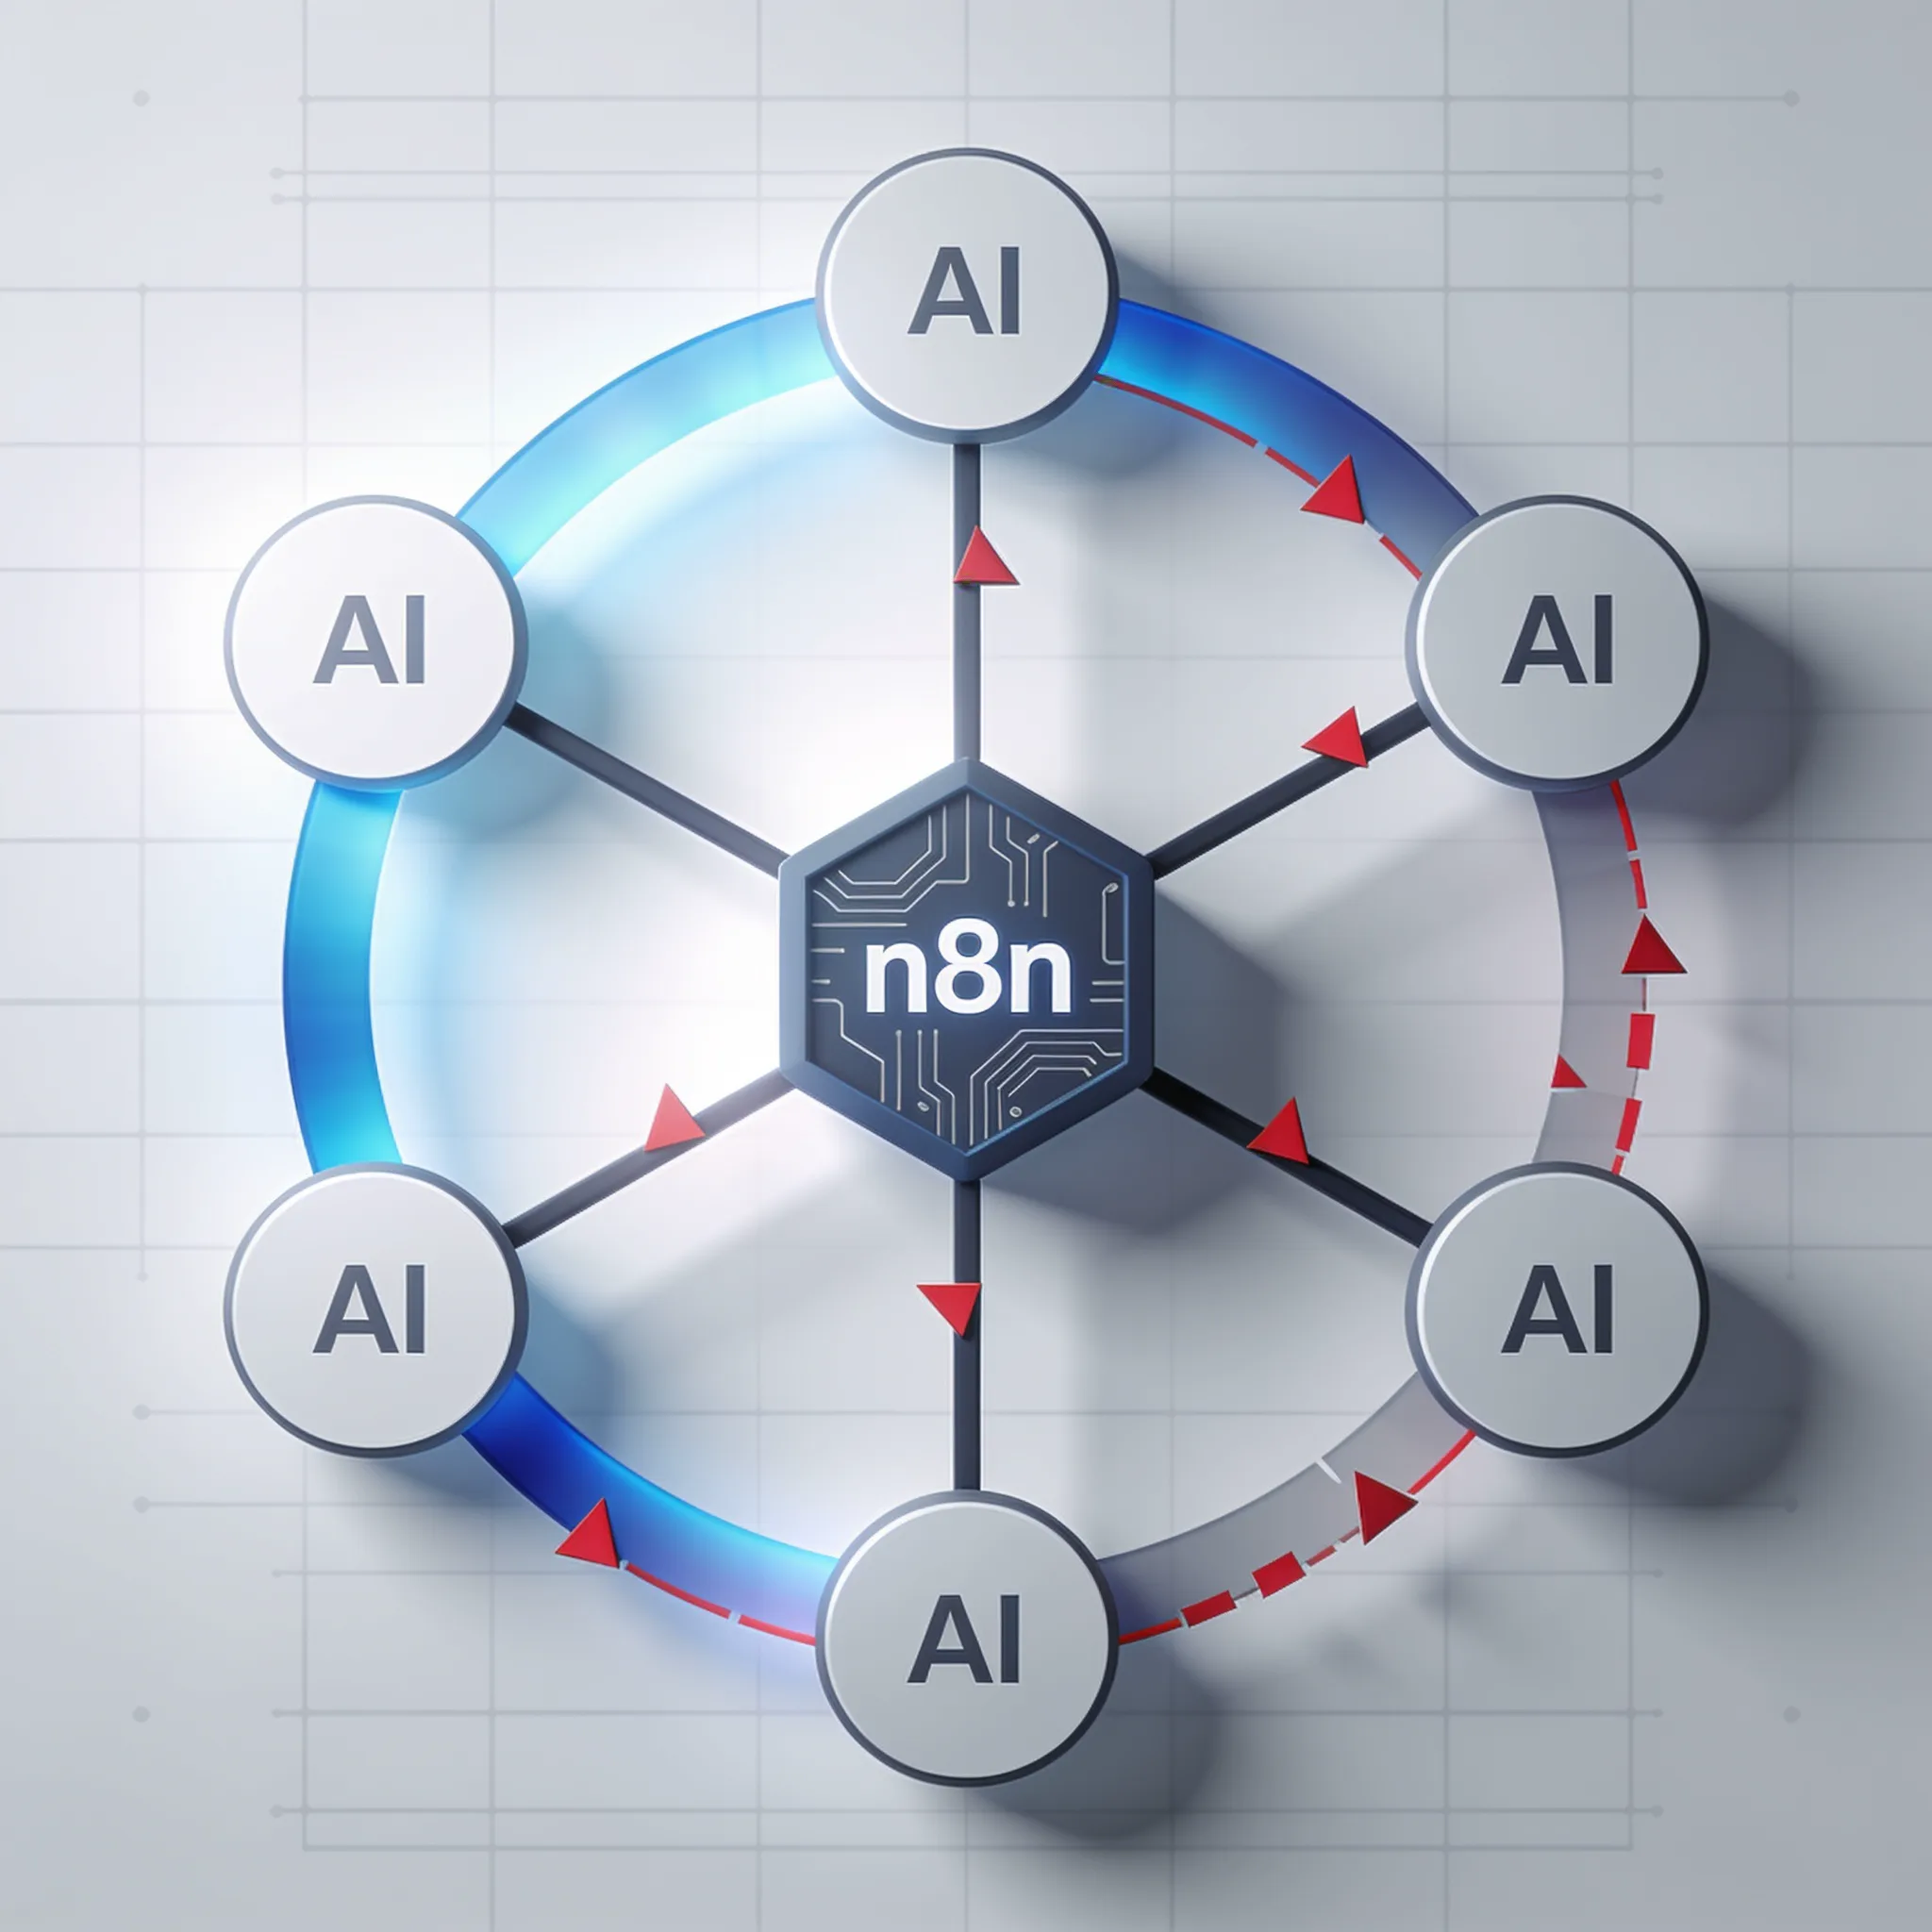
En los sistemas de producción, n8n suele servir como capa de entrada y orquestación. LangGraph o Python a medida se encargan del razonamiento complejo. No obligues al lienzo visual a hacer lo que un script de Python hace mejor.
¿Cuándo se queda corto n8n? - Flujos de datos de alto volumen: el intérprete de nodos no procesa eficazmente miles de eventos simultáneos. - Razonamiento cíclico: los bucles con salidas condicionales rompen la lógica del flujo visual.
- Lógica matemática personalizada: existe un nodo de código, pero resulta poco práctico para transformaciones de datos intensivas. Cuando crees agentes de IA con n8n, úsalo como un enrutador inteligente.
Idea clave: Debes saber cuándo dejar de usar n8n. Úsalo para la entrada y la orquestación básica, pero delega el razonamiento complejo en servicios de Python a medida.
Cómo cumplir la Sustainable Use License si eres una agencia o consultor
Recibe la solicitud, comprueba la autenticación, registra el evento y pasa los datos a un servicio dedicado al razonamiento. n8n utiliza la Sustainable Use License, no una licencia de código abierto estándar reconocida por la OSI. Esta distinción es fundamental para quienes lo implementan, ya que restringe su oferta como servicio gestionado.
No puedes alojar n8n, ponerle una interfaz personalizada y venderlo como si fuera tu propio SaaS. Pero n8n sigue un modelo de código justo y puedes alojarlo en tu propia infraestructura.
Así, las empresas pueden ejecutar agentes en su propia infraestructura y mantener los datos dentro de la organización. Las agencias y los consultores también pueden crear e implementar agentes para sus clientes legalmente. Lo que no pueden hacer es ofrecer n8n como producto alojado.
Si eres consultor y quieres crear agentes de IA con n8n, te recomendamos seguir estas reglas: - Implementa n8n en la infraestructura del cliente (AWS, DigitalOcean o sus servidores locales). - Transfiere al cliente la propiedad de los flujos de trabajo. - No cobres a los clientes una cuota mensual por acceder a tu instancia alojada de n8n.
- Cobra por tu trabajo de desarrollo y por el mantenimiento continuo de la instancia que aloja el cliente.
Idea clave: Cumplir la licencia es imprescindible. Implementa n8n en la infraestructura del cliente y cobra por tus conocimientos, no por alquilarle el software.
Paso 4: Haz crecer tu negocio con las integraciones SaaS de n8n
Evalúa si estás preparado para moverte dentro de los límites de esta licencia. n8n pone sus más de 400 integraciones con aplicaciones a disposición de los agentes como herramientas. Así pueden consultar un CRM, enviar mensajes de Slack, consultar bases de datos o llamar directamente a APIs.
Jahanzaib también señala que n8n tiene unas 1000 integraciones en total, Make unas 1,500 y Zapier más de 8000. No te dejes llevar por las cifras brutas. Zapier destaca por la cantidad.
n8n ofrece más profundidad, sobre todo cuando creas agentes de IA con n8n y presentas esas integraciones directamente al LLM como funciones que puede invocar. Zapier no pone de forma nativa todo su catálogo de aplicaciones a disposición del agente como herramientas del mismo modo que n8n.
La tendencia es clara: el futuro del software empresarial pasa por agentes de IA que interactúan con APIs, no por personas que hacen clic en interfaces. Así puedes conectar una herramienta de CRM a un agente de n8n. 1.
Añade una herramienta HTTP Request al nodo AI Agent. 2. Ponle el nombre "Fetch_HubSpot_Contact".
3. Escribe una descripción clara para el LLM. "Usa esta herramienta cuando el usuario pregunte por los datos de un contacto concreto".
4. Configura el nodo HTTP para que llame a la API de HubSpot. 5.
Pasa la entidad extraída de la solicitud del usuario (por ejemplo, un correo electrónico) como parámetro de consulta.
{
 "method": "GET",
 "url": "https://api.hubapi.com/crm/v3/objects/contacts",
 "authentication": "genericCredentialType",
 "genericAuthType": "httpHeaderAuth",
 "sendQuery": true,
 "queryParameters": {
 "parameters": [
 {
 "name": "email",
 "value": "={{ $json.email }}"
 }
 ]
 }
}
Esta es la configuración del nodo HTTP: tu agente ya puede actuar. Puede obtener datos en tiempo real para fundamentar sus respuestas.
Idea clave: La estrategia de integración importa más que el número de integraciones. Pon las más de 400 herramientas de n8n a disposición de tus agentes para convertir flujos de trabajo estáticos en sistemas dinámicos.
Modelos actuales de Claude, GPT, Gemini y Grok, hasta un 75 % por debajo del precio de lista
Una sola clave de API para los modelos de Claude, GPT, Gemini y Grok en el SDK de OpenAI. Los modelos de Claude también funcionan con el SDK de Anthropic y con Claude Code.
La tarifa de cada modelo con el crédito de AIGROW figura junto al precio de lista de su fabricante, nunca por encima.
Preguntas frecuentes
