Pode criar agentes de IA com n8n combinando um modelo de chat, memória e ferramentas no nó visual AI Agent. Este guia explica como implementar RAG em produção, coordenar vários agentes e reconhecer os limites do modelo de execução do n8n para raciocínio complexo.
A criar com modelos de IA? O crédito de API da AIGROW executa os modelos Claude, GPT, Gemini e Grok até 75% abaixo do preço de tabela.
- O n8n oferece uma forma visual e acessível de criar agentes de IA com o framework LangChain, permitindo ligar LLMs a mais de 400 ferramentas empresariais sem escrever código.
- Fluxos de trabalho de IA para produção exigem uma abordagem híbrida: muitas vezes, o n8n trata das integrações SaaS e serviços personalizados assumem o raciocínio complexo, evitando problemas de latência e de gestão de estado.
- A Sustainable Use License limita as formas como as agências podem rentabilizar o n8n. Por isso, é essencial conhecer os termos antes de o oferecer como serviço gerido aos clientes.
- Para criar um sistema RAG pronto para produção no n8n, é necessário separar os fluxos de ingestão e de consulta. Assim, mantém-se a rapidez e a fiabilidade à medida que o sistema cresce.
Passo 1: Conheça os componentes essenciais antes de criar agentes de IA com n8n
Ao criar agentes de IA com n8n, está a reunir quatro componentes distintos. Imagine uma cozinha profissional. O modelo de chat é o chef, a memória são as suas notas de receitas e as ferramentas são os utensílios.
Já o prompt de sistema é o pedido específico do cliente. O n8n implementa agentes de IA com um nó AI Agent dedicado, baseado no framework LangChain. É preciso configurar corretamente estes quatro componentes.
Os modelos de chat suportados pelo n8n incluem ChatGPT, Claude, Gemini e modelos locais executados através do Ollama. O Ollama executa os modelos; escolha um que responda às necessidades de raciocínio e privacidade do fluxo de trabalho. Para a memória dos agentes, o n8n permite usar um buffer de janela simples ou bases de dados como Postgres e Redis para sessões mais longas.
Sem memória configurada, o agente esquece o que aconteceu antes. Sem ferramentas, só consegue conversar, não agir. Prompts pouco claros, ausência de uma estratégia para gerir o estado e ferramentas sem restrições são causas frequentes de falhas.
Antes da implementação, teste a memória, as permissões das ferramentas e a recuperação perante casos representativos. Prompts sem estrutura e ausência de memória causaram 40% das falhas dos agentes. Quem gere operações tende a deixar o prompt de sistema para o fim.
Na verdade, é ele que define as regras rigorosas de comportamento do chef.
Este é o funcionamento básico de um agente no n8n. Antes de implementar o primeiro agente, recomendamos que siga rigorosamente esta lista: - [ ] Escolher um modelo de chat (OpenAI, Anthropic ou Ollama) - [ ] Configurar um nó de memória (Postgres ou Window Buffer) - [ ] Escrever um prompt de sistema com regras claras - [ ] Adicionar pelo menos uma ferramenta para executar ações
Ponto essencial: A qualidade de um agente de IA depende dos seus prompts e das suas ferramentas. Domine os quatro componentes essenciais antes de ampliar o sistema.
Qual é a diferença entre n8n e LangGraph para raciocínio complexo?
Use o n8n quando as integrações visuais e o encaminhamento de rotina forem suficientes. Recorra a um framework de código com gestão de estado quando o fluxo de trabalho exigir ramificações complexas, recuperação ou testes difíceis de representar no gráfico visual. Valide a escolha com o mesmo fluxo de trabalho representativo.
| Característica | n8n | LangGraph |
|---|---|---|
| Curva de aprendizagem | Baixa (visual) | Alta (exige código) |
| Gestão de estado | Sequencial básica | Ramificações cíclicas complexas |
| Melhor aplicação | Integração SaaS, RAG | Ciclos de raciocínio com vários passos |
| Manutenção do SDK | Nenhuma | Elevada |
É assim que se comparam. Ao criar agentes de IA com n8n, ganha rapidez de implementação, mas abdica de parte do controlo por código.
Ponto essencial: Não obrigue o n8n a tratar de raciocínio complexo para o qual não foi concebido. Use-o como ponto de entrada e deixe o trabalho mais exigente para o Python.
Passo 2: Configure um sistema RAG de produção com dois fluxos de trabalho
Escolha a ferramenta certa para cada tarefa. Um sistema RAG viável em produção no n8n tem dois fluxos de trabalho: um para a ingestão e outro para as consultas. É comum tentar juntar ambos num único fluxo, o que leva ao processamento duplicado de documentos e a índices vetoriais danificados.
Separe estas funções. O n8n suporta bases de dados vetoriais importantes, incluindo Pinecone, Qdrant e Supabase, além de uma opção em memória para testes. Não use a opção em memória em produção: os dados são repostos sempre que o servidor reinicia.
Configurar o fluxo de ingestão 1. Acione o fluxo quando um novo ficheiro chegar ao armazenamento (Google Drive ou S3). 2. Extraia o texto com um nó de carregamento de documentos. 3. Divida o texto em segmentos com o nó de divisão de texto. Mantenha cada segmento perto de 500 tokens. 4. Gere embeddings com um nó de modelo OpenAI ou local. 5. Guarde os vetores no Pinecone ou no Supabase.
Configurar o fluxo de consulta 1. Comece com um acionador de chat ou webhook para receber as perguntas dos utilizadores. 2. Ligue uma ferramenta de recuperação da base de dados vetorial ao nó AI Agent. 3. Envie a pergunta do utilizador à ferramenta. A ferramenta pesquisa a base de dados vetorial. 4. Devolva o contexto encontrado ao modelo de chat. 5. Gere a resposta final. Eis um exemplo de dados devolvidos pela ferramenta de recuperação.
{
 "query": "What is our remote work policy?",
 "matches": [
 {
 "score": 0.92,
 "text": "Employees can work remotely 3 days a week."
 }
 ]
}
Siga estes passos para criar agentes de IA com n8n capazes de responder a perguntas sobre os seus dados proprietários. Esta separação permite que a ingestão decorra de forma assíncrona e mantém baixa a latência das consultas. Quando um utilizador faz uma pergunta, o agente limita-se a consultar a base de dados.
Ponto essencial: Separar os fluxos de ingestão e de consulta é fundamental para manter os sistemas RAG de produção rápidos e fáceis de gerir.
Como coordenar vários agentes no n8n?
No n8n, coordenar vários agentes significa encadear agentes de IA individuais em sequências, nas quais um agente pode delegar tarefas a outro através do AI Agent Tool. Não se trata de um conjunto totalmente autónomo e auto-organizado.
É uma distinção que muitos gestores de operações não fazem. Esperam que os agentes negoceiem entre si de forma dinâmica, mas o n8n não suporta esse tipo de colaboração autónoma de origem. Em vez disso, oferece delegação estruturada.
Um agente principal recebe um prompt e usa o AI Agent Tool para chamar um agente secundário.
Entre os padrões comuns no n8n estão agentes de suporte ao cliente, qualificação de leads, RAG, redação de emails, análise de dados e apoio interno. Por exemplo, um agente de qualificação de leads pode passar a tarefa a um agente de análise de dados para enriquecer os dados de contacto.
Considere estas limitações antes de criar agentes de IA com n8n segundo este padrão: - Perda de contexto: Passar o estado completo entre agentes exige uma conceção cuidadosa dos prompts. - Latência: Cada chamada a um agente acrescenta tempo de ida e volta ao fornecedor do LLM. - Tratamento de erros: Se o agente secundário falhar, o agente principal pode inventar uma resposta.
Para implementar este padrão com segurança, defina protocolos de transferência rigorosos. O agente principal deve enviar ao agente secundário apenas JSON estruturado. O agente secundário deve interpretar esse JSON, executar a tarefa e devolver uma resposta em JSON com um formato rigoroso.
{
  "task": "enrich_lead",
  "input_data": {
    "company_name": "Acme Corp",
    "domain": "acme.com"
  }
}
Sem esta estrutura, os agentes deixam de se entender. Consomem tokens rapidamente sem concluir as tarefas.
Ponto essencial: Tenha expectativas realistas quanto aos fluxos com vários agentes. O n8n é eficaz na delegação sequencial, não na colaboração autónoma e dinâmica.
Passo 3: Integre a observabilidade dos LLMs com Langfuse
Consomem tokens rapidamente sem concluir as tarefas. A maioria dos tutoriais para principiantes ignora a observabilidade. Se não conseguir ver os custos em tokens e a latência, o seu agente torna-se uma caixa negra.
Acompanhe as entradas e saídas do LLM com o mesmo rigor com que acompanha as taxas de sucesso dos fluxos de trabalho. O modelo de execução do n8n acrescenta processamento que, em escala, pode causar problemas de latência inferiores a um segundo. Cada nó acrescenta milissegundos.
Até o pedido chegar ao LLM, regressar e passar pelos nós visuais, o atraso pode tornar-se inaceitável. Langfuse é uma plataforma de código aberto para engenharia de LLMs.
Acompanha versões de prompts, custos em tokens e qualidade das respostas. Pode enviar os registos de execução do n8n para Langfuse configurando um nó de pedido HTTP personalizado que envie dados de rastreio após cada chamada ao LLM. O AI Workflow Builder do n8n consegue gerar um agente inicial a partir de um prompt de texto, mas estes agentes iniciais não incluem observabilidade para produção.
Tem de a acrescentar manualmente. Não confie num prompt de texto para gerar toda a sua infraestrutura de produção.
Calculadora do custo mensal em tokens
Estime o gasto mensal com a API de LLM dos seus agentes n8n.
Calcule os potenciais custos em tokens antes de ampliar o sistema. Ao criar agentes de IA com n8n, a observabilidade não é opcional.
Ponto essencial: Integre Langfuse desde o início. Acompanhar as entradas e saídas do LLM é essencial para diagnosticar atrasos e derrapagens de custos em produção.
Uma perspetiva diferente: porque o n8n não resolve todos os desafios dos fluxos de trabalho de IA complexos
É a sua proteção contra contas de API descontroladas e falhas silenciosas. As ferramentas visuais não dão conta de todas as tarefas de IA. A ideia dominante em 2026 é que as plataformas sem código podem substituir por completo as equipas de engenharia, mas isso é um mito perigoso.
O modelo de execução visual do n8n acrescenta trabalho de processamento inevitável. Em grande escala, isso provoca problemas de latência. Cada nó corresponde a uma operação JavaScript interpretada durante a execução.
A plataforma também tem dificuldade em gerir estados com ramificações complexas. Se o seu agente precisar de voltar atrás cinco vezes conforme uma lógica cheia de nuances, a interface visual torna-se um emaranhado.
As ferramentas visuais muitas vezes impõem essa rigidez. Quando a lógica ultrapassa as capacidades da interface, chega-se a um limite. É preciso saber quando deixar o n8n de lado.
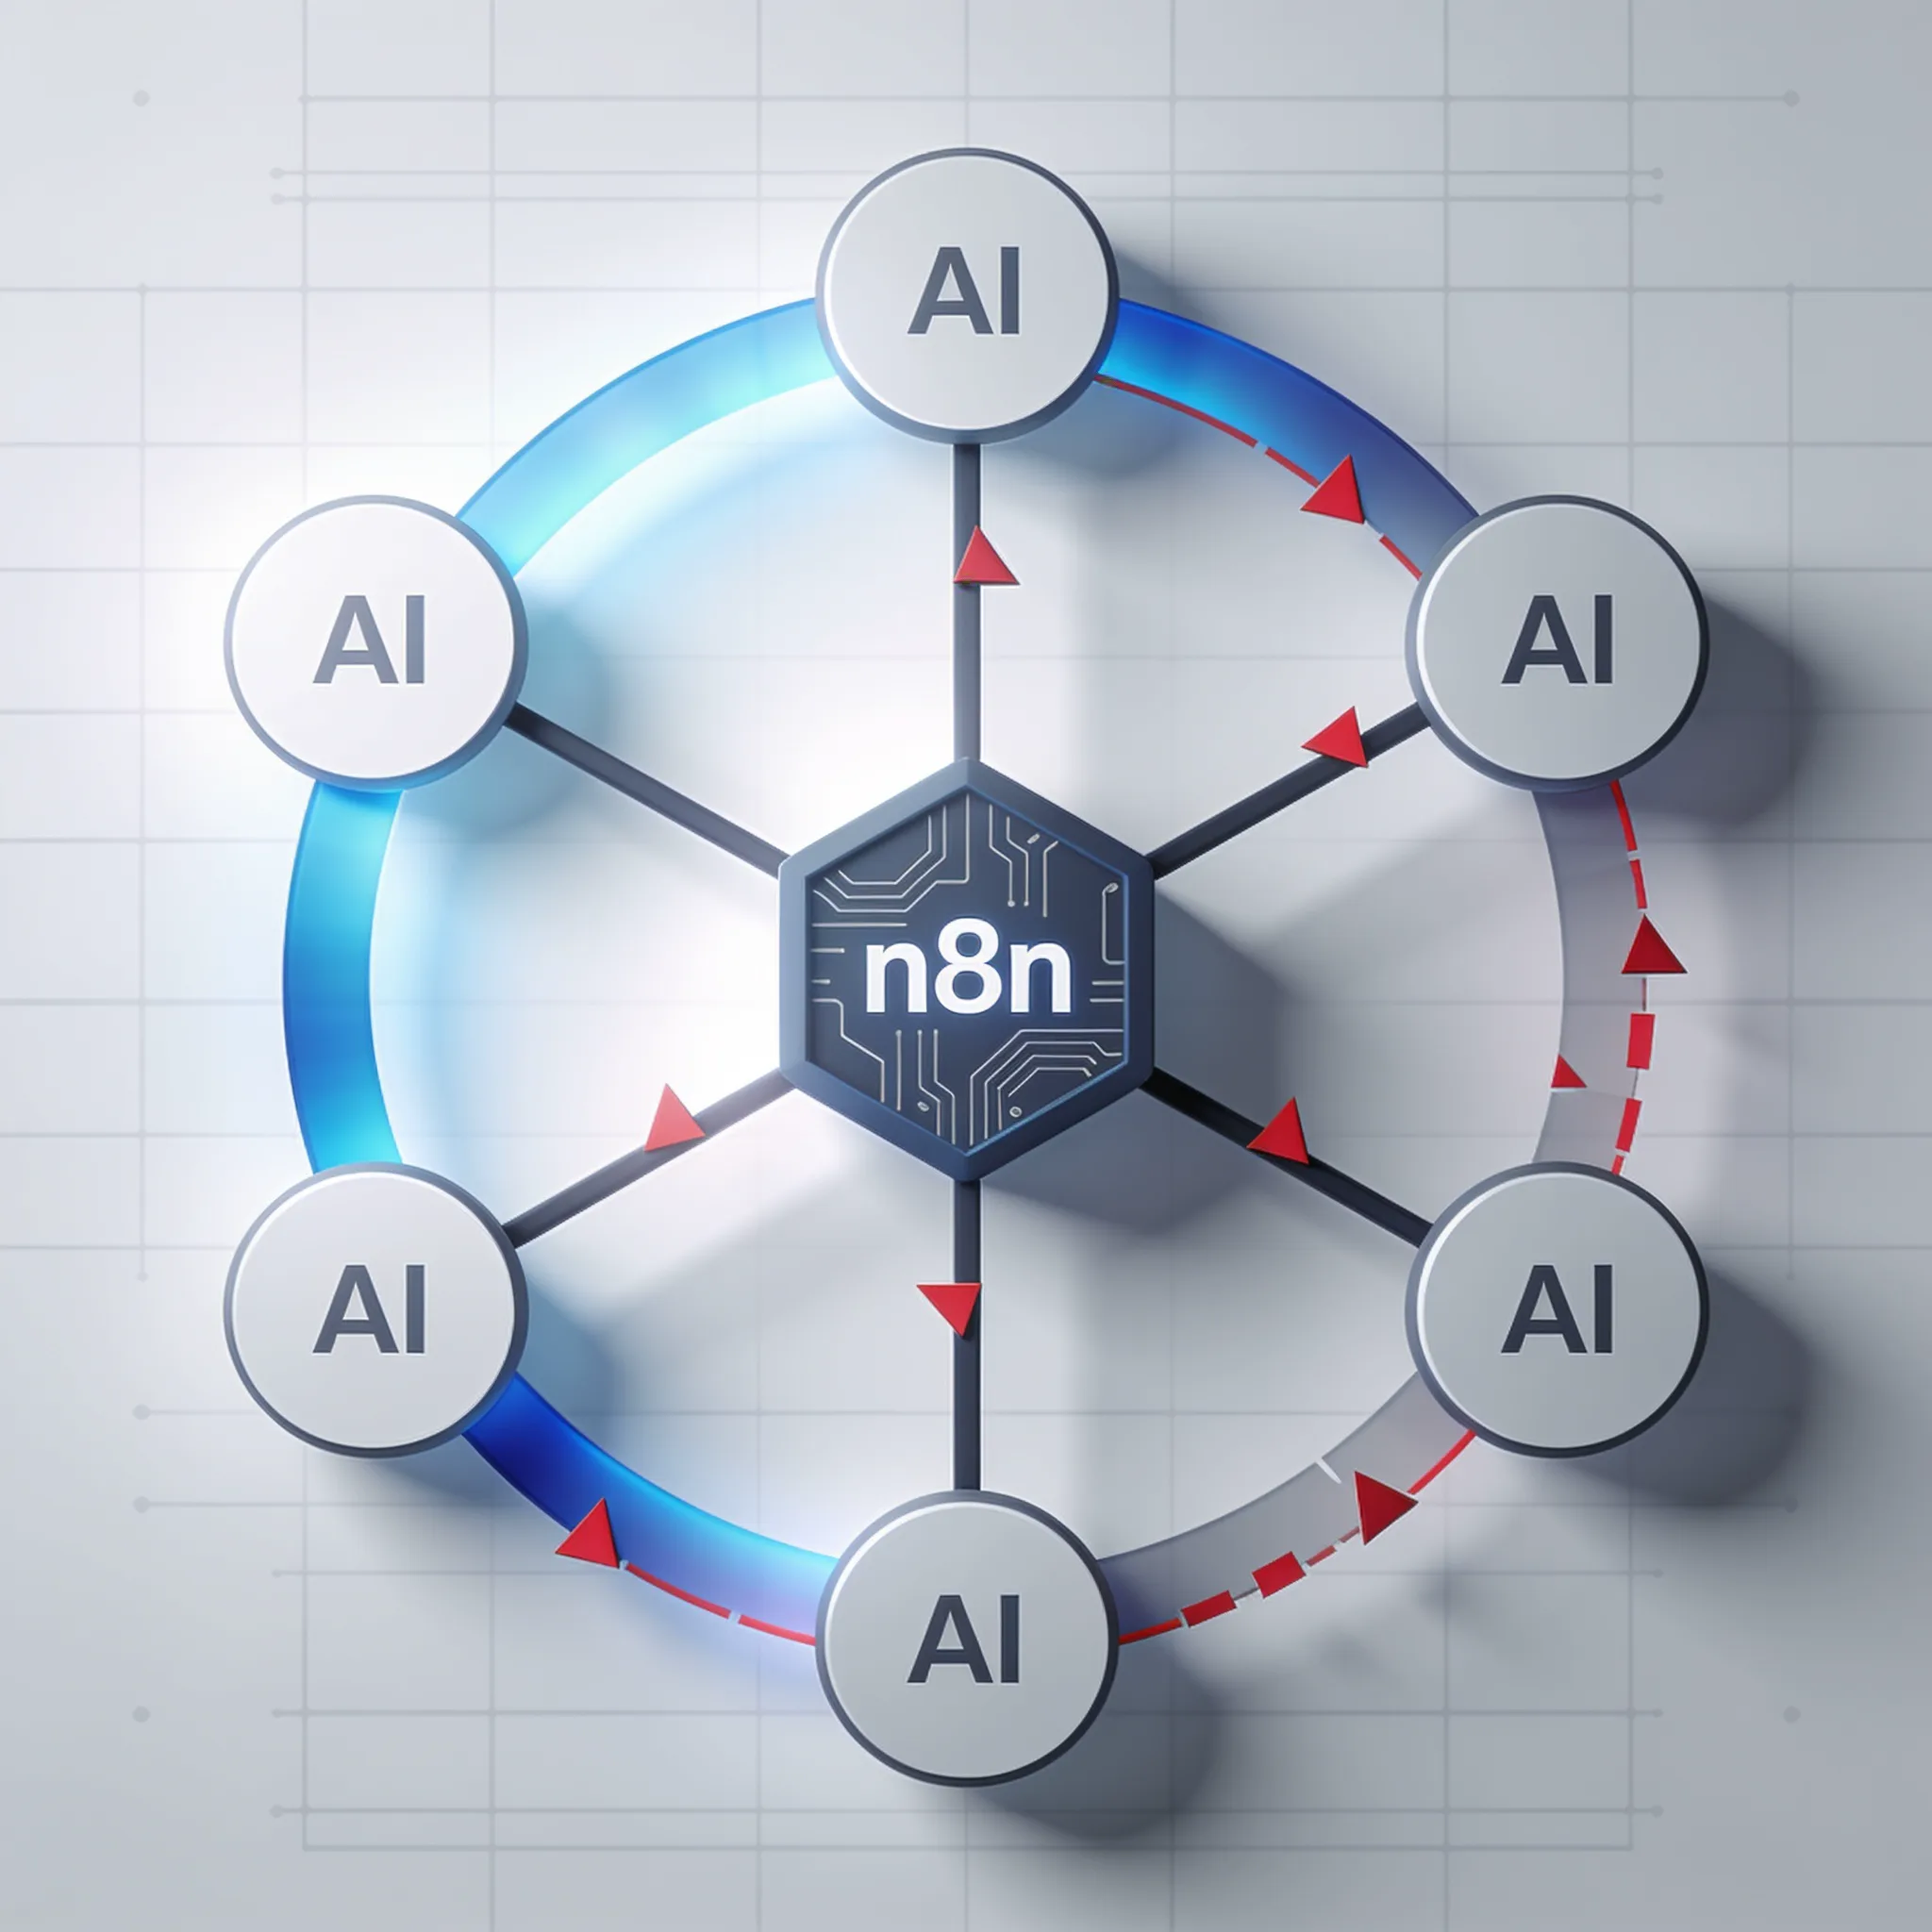
Em sistemas de produção, o n8n é frequentemente usado para receber pedidos e coordenar tarefas. O LangGraph ou um serviço Python personalizado trata do raciocínio complexo. Não obrigue a interface visual a fazer aquilo que um script Python faz melhor.
Em que situações o n8n falha? - Fluxos de dados de elevado volume: o interpretador de nós não consegue processar milhares de eventos em simultâneo de forma eficiente. - Raciocínio cíclico: os ciclos com saídas condicionais quebram a lógica do fluxo visual.
- Lógica matemática personalizada: existe um nó de código, mas é pouco prático para transformações de dados exigentes. Ao criar agentes de IA com n8n, use-o como um encaminhador inteligente.
Ideia principal: Saiba quando deixar o n8n de lado. Use-o para receber pedidos e coordenar tarefas básicas, mas entregue o raciocínio complexo a serviços Python personalizados.
Como cumprir a Sustainable Use License: guia para agências e consultores
O n8n recebe o pedido, verifica a autenticação, regista o evento e encaminha os dados para um serviço dedicado ao raciocínio. Usa a Sustainable Use License, não uma licença padrão de código aberto reconhecida pela OSI. Esta distinção é fundamental para quem opera estes sistemas.
A licença restringe a oferta do n8n como serviço gerido. Não pode alojar o n8n, acrescentar-lhe uma interface personalizada e vendê-lo como se fosse o seu próprio SaaS. Mas o n8n é fair-code e pode ser alojado na sua própria infraestrutura.
Isso permite às empresas executar agentes na sua própria infraestrutura e manter os dados internamente. Agências e consultores também podem criar e implementar agentes para clientes dentro da legalidade. O que não podem fazer é oferecer o próprio n8n como produto alojado.
Se presta consultoria para criar agentes de IA com n8n, recomendamos estas regras: - Implemente o n8n na infraestrutura do cliente (AWS, DigitalOcean ou servidores locais). - Transfira para o cliente a propriedade dos fluxos de trabalho. - Não cobre aos clientes uma mensalidade pelo acesso à sua instância alojada do n8n.
- Cobre pelo tempo de desenvolvimento e pela manutenção contínua da instância que o cliente aloja.
Ideia principal: Cumprir a licença é indispensável. Implemente o n8n na infraestrutura do cliente e cobre pelos seus conhecimentos, não pelo aluguer do software.
Passo 4: fazer crescer o negócio com as integrações SaaS do n8n
Avalie se está preparado para lidar com estas questões de licenciamento. O n8n disponibiliza as suas mais de 400 integrações com aplicações como ferramentas. Assim, os agentes podem consultar um CRM, enviar mensagens no Slack, consultar bases de dados ou chamar APIs diretamente.
Jahanzaib também refere que o n8n tem ~1.000 integrações no total, o Make tem ~1,500 e o Zapier tem 8.000+. Não se deixe impressionar apenas pelos números. O Zapier destaca-se pela quantidade.
O n8n oferece mais profundidade, sobretudo quando cria agentes de IA com n8n e disponibiliza essas integrações diretamente ao LLM como funções que pode chamar. O Zapier não disponibiliza de forma nativa todo o seu catálogo de aplicações ao agente como ferramentas da mesma forma que o n8n.
A tendência é clara: o futuro do software empresarial passa por agentes de IA a interagir com APIs, não por pessoas a clicar em interfaces." Veja como ligar uma ferramenta de CRM a um agente no n8n. 1.
Adicione uma ferramenta HTTP Request ao nó AI Agent. 2. Dê à ferramenta o nome "Fetch_HubSpot_Contact".
3. Escreva uma descrição clara para o LLM. "Use esta ferramenta quando o utilizador pedir informações sobre um contacto específico."
4. Configure o nó HTTP para chamar a API do HubSpot. 5.
Passe a entidade extraída do pedido do utilizador (como um email) como parâmetro de consulta.
{
 "method": "GET",
 "url": "https://api.hubapi.com/crm/v3/objects/contacts",
 "authentication": "genericCredentialType",
 "genericAuthType": "httpHeaderAuth",
 "sendQuery": true,
 "queryParameters": {
 "parameters": [
 {
 "name": "email",
 "value": "={{ $json.email }}"
 }
 ]
 }
}
Esta é a configuração do nó HTTP: o seu agente agora consegue agir. Pode consultar dados em tempo real para fundamentar as respostas.
Ideia principal: A estratégia de integração importa mais do que o número de integrações. Disponibilize as mais de 400 ferramentas do n8n aos seus agentes para transformar fluxos de trabalho estáticos em sistemas dinâmicos.
Modelos atuais Claude, GPT, Gemini e Grok, até 75% abaixo do preço de tabela
Uma única chave de API para os modelos Claude, GPT, Gemini e Grok no SDK da OpenAI. Os modelos Claude funcionam também com o SDK da Anthropic e o Claude Code.
A taxa de cada modelo através do crédito AIGROW surge ao lado do preço de tabela do respetivo fabricante, nunca acima dele.
Perguntas frequentes
