A melhor forma de medir a visibilidade na pesquisa em IA é acompanhar observações distintas: menções, citações, fundamentação das citações, precisão factual, variação entre motores, sessões de referência e resultados para o negócio. Mantenha estável o conjunto de prompts, documente cada execução, examine manualmente as páginas citadas e indique os limites da amostra, em vez de transformar um conjunto variável de respostas numa falsa pontuação universal.
- Acompanhe separadamente as menções, as citações, a fundamentação factual, as sessões de referência e os resultados para o negócio. Cada métrica responde a uma pergunta diferente e não deve ser fundida numa pontuação única.
- Use um conjunto documentado de prompts e registe o motor, o estado da sessão, a localização, a data e o modelo, quando disponíveis. As respostas geradas variam entre execuções.
- Reveja manualmente as páginas citadas. Uma citação só é útil se o link funcionar e a página sustentar a afirmação feita na resposta.
- Trate as mudanças como observações da sua amostra. Não prometa melhorias na classificação, nas citações, no tráfego ou na receita com base numa pontuação de visibilidade.
Crie um conjunto de prompts reutilizável
Comece pelas perguntas que um potencial cliente faria antes de conhecer a sua marca. Agrupe-as por intenção, como pesquisa de categorias, resolução de problemas, comparações, implementação e pesquisas diretas sobre a marca. Mantenha os prompts que mencionam a marca num grupo próprio, para que não aumentem artificialmente os resultados das pesquisas sem marca.
Não existe uma combinação universal de tipos de prompts. Uma empresa de serviços locais, um fornecedor de software e uma loja online têm percursos de compra diferentes. Documente por que razão incluiu cada prompt, quem representa e a que mercado ou idioma se aplica.
Mantenha o conjunto inalterado durante cada período de análise. Se adicionar ou remover prompts, mostre a alteração em vez de comparar diretamente a nova pontuação com a anterior.
Para cada execução, guarde o prompt exato, a resposta obtida, os URLs citados, o motor, a data, a localização, o estado da sessão e o modelo ou modo do produto, quando a interface o indicar. Repita o mesmo conjunto sempre que o orçamento permitir. As respostas dos assistentes podem mudar entre execuções, pelo que uma resposta é uma observação, não uma classificação estável.
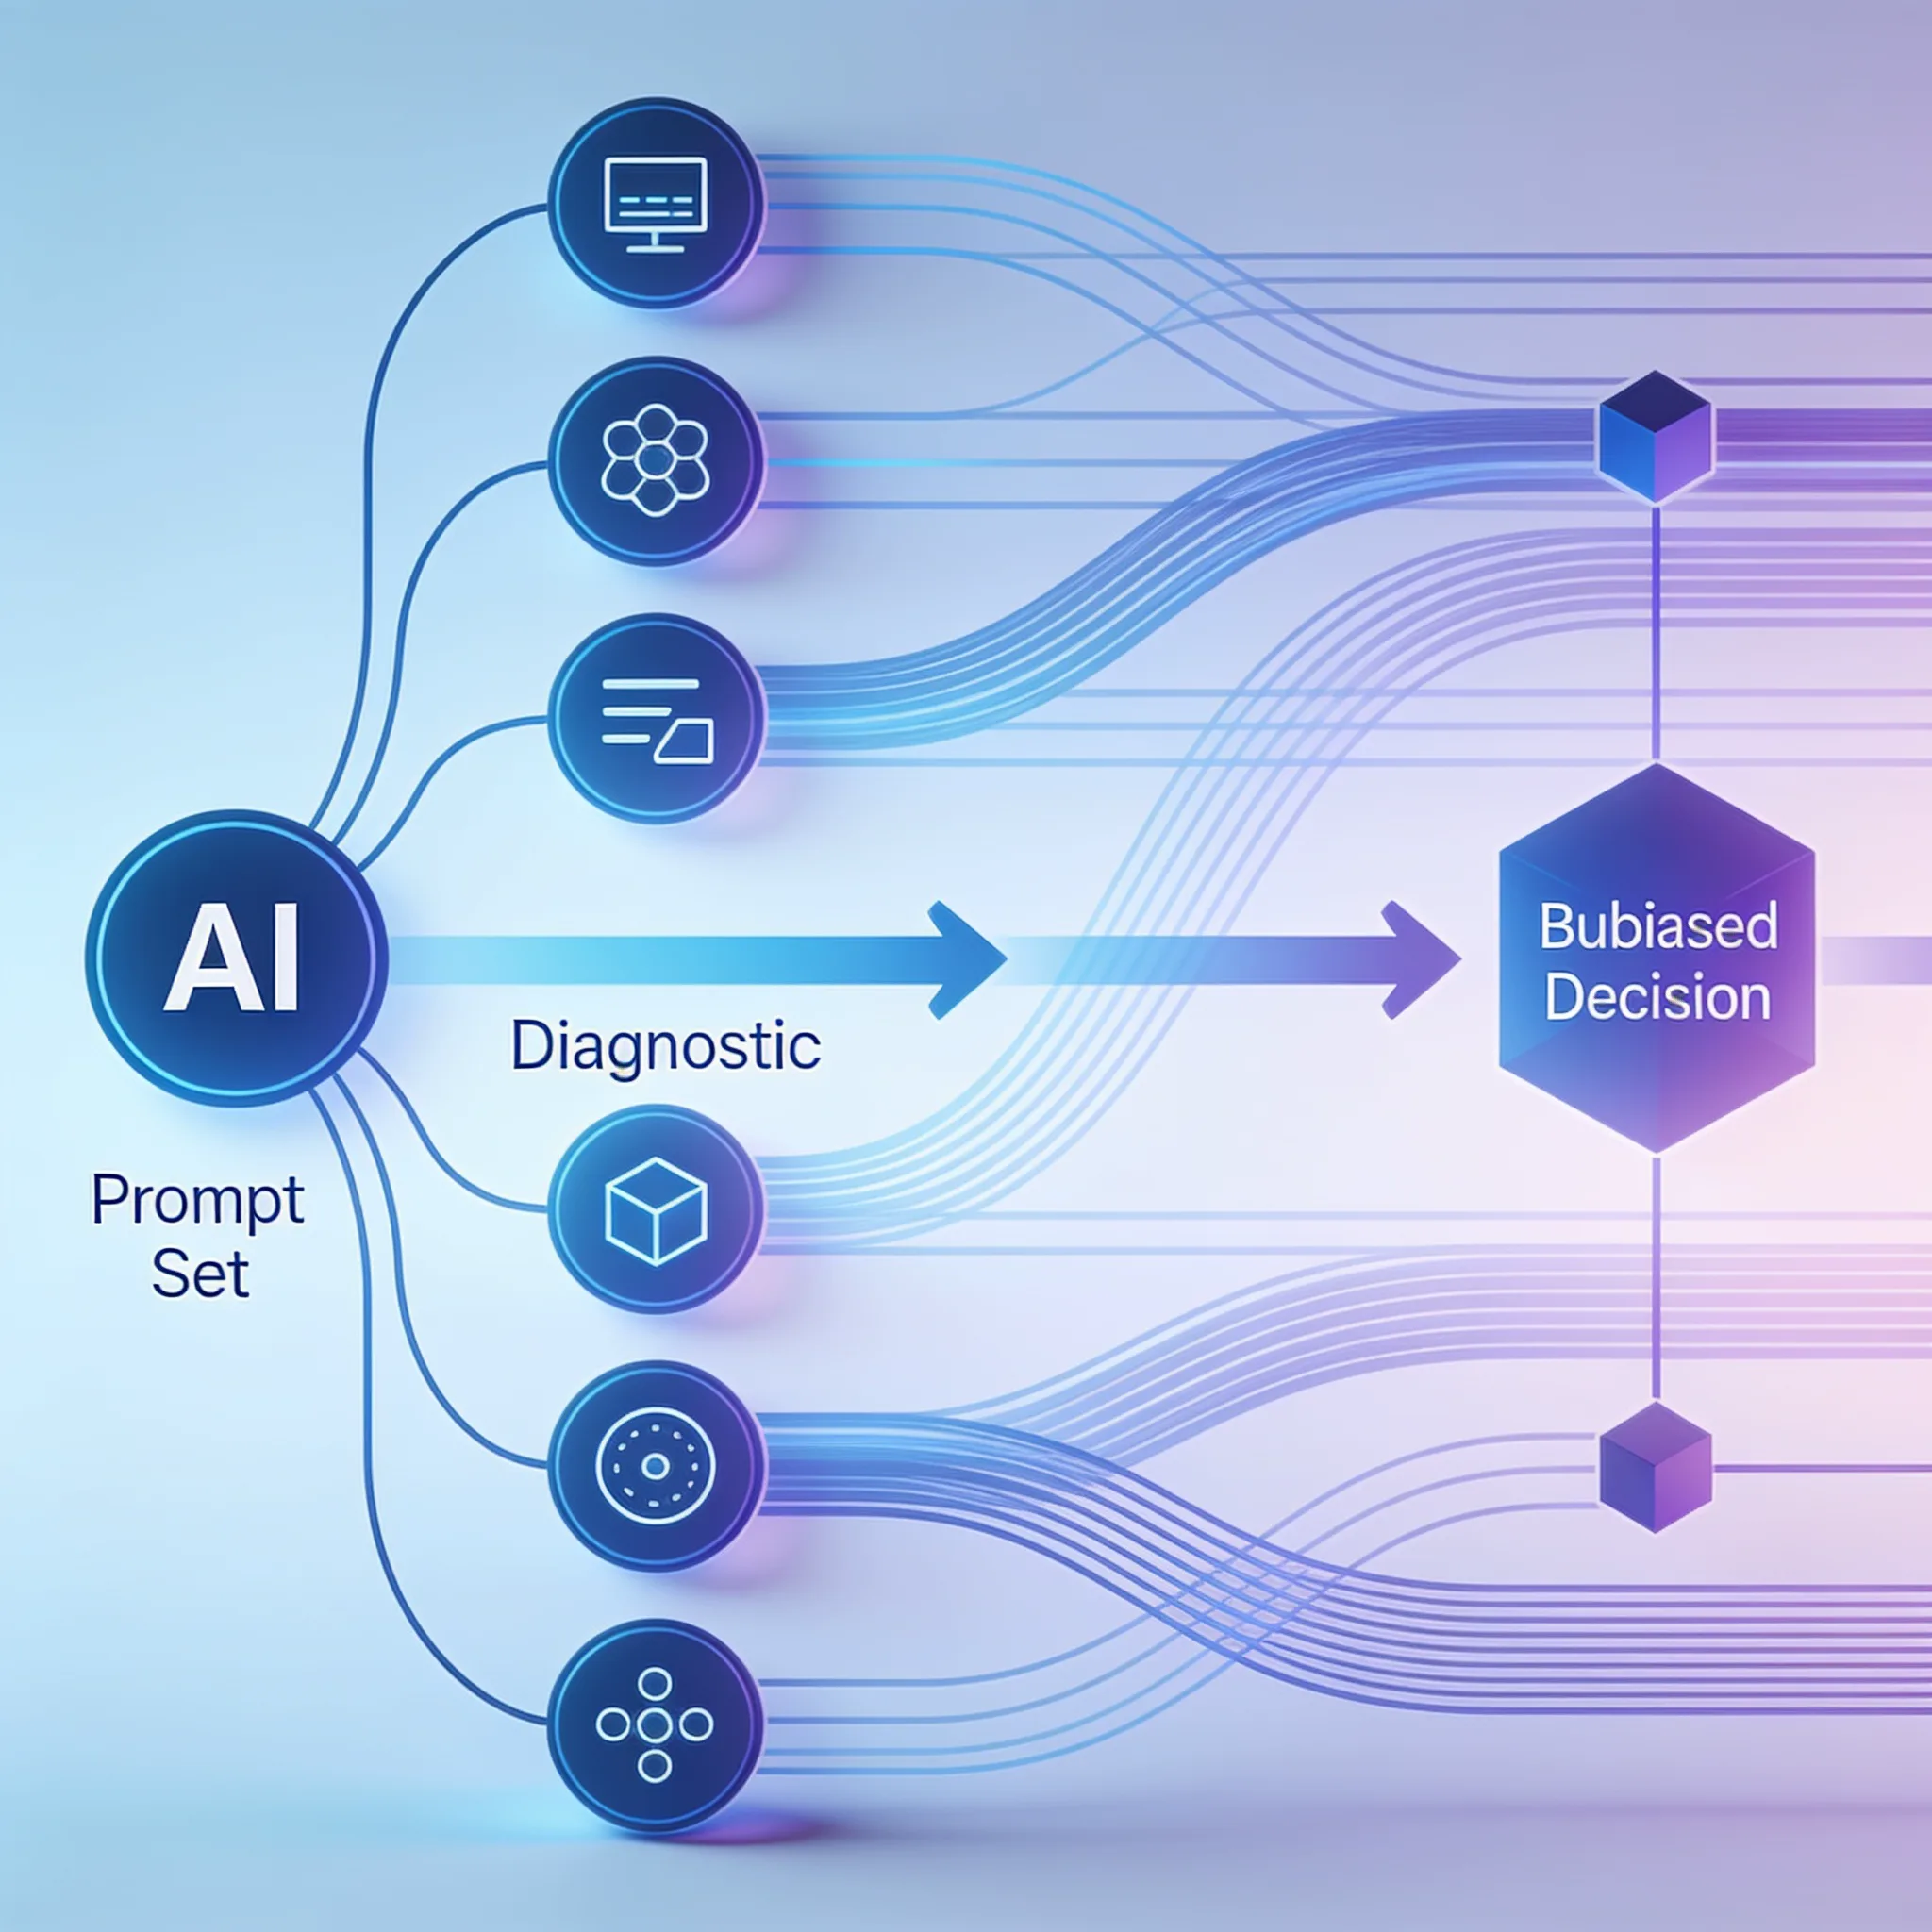
Use uma sequência simples de diagnóstico:
- A marca foi mencionada?
- O domínio da marca foi citado?
- A página citada sustentava a resposta?
- Os factos apresentados sobre a marca estavam corretos e atualizados?
- Seguiu-se uma visita ou conversão mensurável?
Cada pergunta aponta para um problema diferente. Poucas menções podem indicar fraca relevância para a categoria. Menções sem citações pedem uma revisão das fontes.
Citações com links quebrados ou que não sustentam a resposta exigem a verificação das páginas e afirmações. Tráfego sem resultados úteis é uma questão de análise de dados ou conversão.
Use métricas com definições operacionais claras
Um relatório prático não precisa de catorze pontuações sobrepostas. Comece por métricas que a sua equipa consiga calcular e auditar:
- Cobertura de prompts: número de execuções válidas concluídas dividido pelo número de execuções planeadas.
- Taxa de menções à marca: número de respostas válidas que mencionam a marca dividido pelo número de respostas válidas no mesmo grupo de prompts.
- Taxa de citações do domínio: número de respostas válidas que citam o domínio da marca dividido pelo número de respostas válidas no mesmo grupo.
- Taxa de citações fundamentadas: número de citações revistas cuja página de destino sustenta a afirmação correspondente dividido pelo número de citações revistas.
- Taxa de precisão factual: número de afirmações verificadas sobre a marca consideradas corretas e atualizadas dividido pelo total de afirmações verificadas.
- Distribuição dos URLs citados: páginas e tipos de página que aparecem nas citações.
- Variação entre motores: diferença entre observações comparáveis de cada motor. Descreva-a sem recorrer a conclusões estatísticas, a menos que a amostra e o método justifiquem essa análise.
- Sessões de referência de IA: visitas atribuídas a um assistente ou a uma fonte de pesquisa em IA nas ferramentas de análise de dados. Algumas visitas terão dados de referência incompletos ou em falta.
- Resultados atribuídos: leads, registos, compras ou outros eventos selecionados provenientes de sessões atribuídas. Indique o período e o modelo de atribuição.
Mostre sempre os denominadores. Uma taxa de citações baseada em seis respostas utilizáveis não deve parecer tão fiável como uma baseada numa amostra maior e repetida. Distinga também uma menção à marca de um link para o domínio da marca. Uma coisa não comprova a outra.
Evite uma pontuação composta única, a menos que os pesos estejam documentados e sejam úteis para uma decisão específica. Pontuações compostas podem esconder o problema exato que a equipa precisa de resolver.
Verifique as citações e a elegibilidade técnica
Abra cada citação de uma amostra de dimensão gerível e registe três resultados: se o URL funciona, se a página sustenta a afirmação e se a informação está atualizada. Assinale os casos incertos para uma segunda revisão. Um link funcional não prova que a resposta representou corretamente a fonte.
Mantenha uma ficha breve com informações que os assistentes muitas vezes apresentam incorretamente, como os nomes atuais dos produtos, a localização da página de preços, as regiões abrangidas, os contactos e as datas das políticas. Avalie apenas factos que possam ser verificados numa fonte identificada. Não preencha lacunas com suposições.
As verificações técnicas devem seguir os requisitos publicados por cada plataforma. Segundo a Google, para aparecerem como links de apoio nas suas experiências de pesquisa em IA, as páginas têm de estar indexadas e ser elegíveis para apresentar um excerto. As orientações da Google não exigem marcação especial para IA.
As orientações da OpenAI para editores explicam como o OAI-SearchBot controla a descoberta de conteúdos para a pesquisa do ChatGPT, separadamente dos controlos de treino do GPTBot.
Verifique as diretivas para robôs, a possibilidade de indexação, os URLs canónicos, as respostas do servidor, o conteúdo visível das páginas e os links internos. Use dados estruturados apenas quando corresponderem ao conteúdo que os leitores podem ver e seguirem a documentação de pesquisa pertinente. Estas verificações melhoram a elegibilidade e a clareza.
Não garantem a inclusão nem a citação.
Escolha as ferramentas pelo método, não pela pontuação
A cobertura das ferramentas e o funcionamento dos produtos mudam rapidamente. Avalie o produto atual em vez de se basear numa tabela de comparação antiga. Peça a cada fornecedor que mostre:
- os motores, mercados, idiomas e modos de produto abrangidos;
- como os prompts são agendados e se é possível repetir as execuções;
- as respostas originais e as citações que fundamentam cada pontuação;
- como são tratadas as execuções falhadas, as citações em falta e as fontes duplicadas;
- se os resultados podem ser exportados com datas, horas e versões dos prompts;
- o que muda quando um motor atualiza o modelo ou a interface;
- as condições atuais de conservação de dados, privacidade e faturação.
Faça um pequeno teste de aceitação antes de se comprometer. Use o mesmo conjunto de prompts em cada ferramenta e verifique manualmente uma amostra das respostas e dos links guardados. Se a plataforma apresentar apenas uma pontuação, sem as evidências que a sustentam, será difícil auditá-la e pouco útil para tomar decisões.
Uma folha de cálculo basta para estabelecer uma referência inicial. A automação torna-se útil quando preserva as evidências originais, repete o método de forma consistente e reduz o trabalho de recolha sem ocultar falhas. Reserve tempo de análise para rever citações e factos, mesmo quando a recolha é automatizada.
Os assistentes a que os seus potenciais clientes recorrem mencionam você ou um concorrente?
Lê o seu site e depois faz a quatro assistentes as perguntas dos seus clientes.
Interprete com cuidado a variação entre motores
Assistentes diferentes podem dar respostas diferentes porque usam sistemas de recuperação de informação, índices, interfaces e modelos distintos, além de variarem na personalização e na disponibilidade da pesquisa. Encare essa variação como um motivo para examinar as evidências, não como prova de que um motor prefere permanentemente um tipo de fonte.
Compare situações equivalentes. Sempre que possível, use a mesma formulação dos prompts, o mesmo mercado, idioma, período e estado de sessão iniciada. Apresente os resultados de cada motor separadamente antes de mostrar um total agregado.
Se um produto não apresentar citações numa resposta, registe esse resultado em vez de tentar adivinhar que fonte a influenciou.
As referências do setor podem ajudar a formular perguntas, mas não substituem a sua própria referência inicial. Antes de usar uma referência, verifique o conjunto de prompts, as datas de recolha, a seleção da amostra, a geografia, a configuração dos motores e a definição de menção ou citação. Pontuações de fornecedores diferentes não são diretamente comparáveis quando os métodos diferem.
Quando um resultado mudar, reveja as respostas e os URLs citados. Uma taxa de menções mais alta pode incluir afirmações incorretas. Uma taxa de citações mais baixa pode resultar de uma mudança na interface, de uma execução de recolha falhada ou de uma alteração real nas fontes.
As evidências originais ajudam a perceber qual explicação é plausível.
Ligue a visibilidade às decisões sem afirmar causalidade
Uma menção oferece contexto útil sobre a marca, mas não comprova autoridade, tráfego ou receita. Uma citação é uma evidência mais forte de que uma página foi apresentada como fonte, mas também não prova que alguém clicou ou converteu.
Use ferramentas de análise de dados para registar as sessões de referência que identificam uma fonte de IA. Associe-lhes os mesmos eventos de lead, registo ou compra usados nos outros canais. Documente o modelo e o período de atribuição.
Alguns utilizadores regressam por acesso direto ou por outro canal, e alguns assistentes podem não transmitir uma origem de referência útil. Por isso, as visitas de referência de IA registadas são apenas a parte observável, não uma contagem completa.
Ao alterar conteúdos ou configurações técnicas, registe a data da intervenção e mantenha estável o conjunto de prompts. Compare as observações anteriores e posteriores à mudança e verifique se houve atualizações dos produtos, efeitos sazonais, campanhas ou outras explicações. Descreva uma correlação como correlação.
Uma experiência controlada pode sustentar uma conclusão mais forte, mas a tendência de um painel, por si só, não.
Termine o relatório com ações fundamentadas nas evidências. Corrija páginas com links quebrados, retifique afirmações sem fundamento, atualize factos desatualizados, melhore páginas que já recebem citações relevantes e investigue grupos de prompts com erros factuais recorrentes. Não prometa um aumento das citações.
Meça a amostra seguinte e mostre o que mudou.
Descubra o que o ChatGPT diz sobre você antes do seu próximo comprador.
Gratuito, sem conta. A auditoria paga custa $490 e demora 3-5 dias úteis.
Perguntas frequentes
