Lagene i AI-automatisering strækker sig fra et solidt datagrundlag til autonome, hændelsesstyrede processer. Hvert lag fungerer kun, hvis laget nedenunder gør det. De fleste teams går i stå ved lag 3, hvor AI skal gå fra at rådgive til at handle. Årsagen er næsten altid datakvalitet snarere end modellens evner.
- Branchen mangler fælles standarder, men når modellerne med 3, 5 og 6 lag samles, tegner der sig en klar udvikling fra datagrundlag til autonome processer.
- 80% af alle teams går i stå ved lag 3 (beslutningslogik) på grund af ustrukturerede data fra lag 1 og 2. Det viser, at datakvalitet er en større hindring end teknologi.
- At skalere fra niveau 1 med individuelle værktøjer ($45-$120/md.) til niveau 3 med processer drevet af flere agenter ($400-$800/md.) kræver bevidste ændringer i arkitekturen og stram styring.
Hvad er den samlede model for lag i AI-automatisering?
Den samlede model for lag i AI-automatisering beskriver en udvikling, der er uafhængig af leverandører. Den samler de forskellige arkitekturer med 3, 5 og 6 lag i én overskuelig vej frem for dem, der står for driften. Vi kobler automatiseringsløsningen med 5 lag til agentarkitekturen med 6 lag for at beskrive AI-modenhed fra datagrundlag til autonome processer.
På den måde udvikler den tekniske udførelse og de kognitive evner sig i takt. Begge sider skal være på linje.
Automatiseringsløsningen med 5 lag består af dataindsamling, koordinering af datapipelines, beslutningslogik, intelligente handlinger og autonome agenter. Vi kobler disse driftskomponenter til agentarkitekturen med 6 lag, som beskriver AI-modenhed fra datagrundlag til autonome processer. Det sikrer, at den tekniske udførelse og de kognitive evner udvikler sig i takt.
Traditionelt har dataingeniører arbejdet efter modellen med 5 lag, mens machine learning-teams har bygget efter modellen med 6 lag. Det har skabt en stor kløft i kommunikationen.
Datateams har fokuseret på at flytte data, mens machine learning-teams har fokuseret på agenternes ræsonnement. Når modellerne samles, får begge grupper det samme krav, før de kan gå videre: Hvis datateamet ikke kan dokumentere, at koordineringen af pipelines i modellen med 5 lag håndterer undtagelsestilfælde, kan machine learning-teamet ikke gå videre til værktøjsudførelse i modellen med 6 lag.
Lag 1 (datagrundlag) er stadiet, hvor data ligger i adskilte siloer uden et fælles lag, som AI kan forespørge. Teams bruger uger på at skrive særlige scripts for at besvare enkle spørgsmål om driften, og denne manuelle tilgang er udgangspunktet for de fleste virksomheder. Fejlen er at tro, at et data warehouse løser problemet.
Vi ser virksomheder lægge rå CSV-filer i Snowflake og stolt kalde det lag 1. Det er en fælde. Hvis en AI-agent skal skrive særlig SQL for at gennemgå ustrukturerede tekstfelter blot for at finde et kunde-id, ligger jeres data stadig i siloer.
En agent, der handler på forældede lagerdata, kan bestille varer, som ikke er tilgængelige, eller overse en pludselig stigning i salget. Test kravene til dataenes aktualitet, forsinkede hændelser og afstemning, før systemet får lov til at afgive en ordre.
Lag 3 (værktøjslaget) omfatter AI, der kan forespørge data, men ikke udføre handlinger i eksterne systemer. Derfor kan den rådgive, men ikke handle. Det er her, de fleste teams møder en mur.
Lag 4 (hukommelseslaget) giver agenter vedvarende kontekst på tværs af sessioner, så de kan lære af tidligere resultater og undgå at gentage kendte fejl. De husker brugerpræferencer og tidligere fejl. Den undtagelse, der kan få laget til at svigte, er, når oplysninger flyder mellem sessioner.
Det kan ske, hvis en agent husker én brugers rabatkode og ved en fejl anvender den i en ny brugers session. Resultatet er et datalæk. Hukommelseslag kræver streng adskillelse af navnerum for hver bruger.
Lag 5 (koordineringslaget) gør det muligt for flere specialiserede agenter at løse komplekse opgaver sammen, enten efter hinanden, parallelt eller i et hierarki. Det er en arkitektur med flere agenter. Teams forsøger ofte at springe lag 4 over og gå direkte til lag 5.
Så kan deres agenter ikke bevare tilstanden mellem deres egne opgaver, der udføres efter hinanden. Resultatet er koordineringssløjfer, hvor agenterne hele tiden beder hinanden om data, de allerede har hentet. Det kan tidoble jeres tokenomkostninger og ødelægge jeres investeringsafkast.
Lag 6 (autonome processer) omfatter AI-agenter, der løbende overvåger data, registrerer hændelser, ræsonnerer på tværs af datasæt og handler uden at afvente et menneske. Det er slutmålet.
Trin 1: Find ud af, hvilket lag jeres AI-automatisering er på
De fleste automatiseringsprojekter mislykkes, fordi teams springer de grundlæggende lag over eller starter det forkerte sted i automatiseringsløsningen. I skal kende jeres udgangspunkt, før I tilføjer agenter.
Vi bruger en fast tjekliste til at finde ud af, hvor et team bør begynde. Den forebygger, at I bygger en unødigt kompleks løsning, før det grundlæggende fungerer. Gå listen igennem for at vurdere, om I er klar.
- Dataforsinkelse: Undersøg, hvor lang tid det tager at samle de vigtigste driftsdata. Tager det timer? Så sidder I fast i lag 1.
- Forespørgsler: Undersøg, om det kræver spørgsmål fra et menneske at få indsigt i jeres data. Hvis AI ikke selv kan forespørge databasen, er I i lag 2.
- Rettigheder til handling: Gennemgå jeres API-rettigheder. Hvis jeres AI kan læse data, men ikke har skriveadgang til eksterne systemer, er I nået til grænsen for lag 3.
- Vedvarende kontekst: Test hukommelsen på tværs af sessioner. Hvis jeres agent glemmer tidligere interaktioner, når en ny session begynder, mangler I helt funktionerne fra lag 4.
En pipeline, der ser tilstrækkelig ud til rapportering, kan stadig svigte, når software skal handle på dens data. Test ændringer i dataskemaet, manglende felter, forældede poster, dublerede hændelser og fejl i efterfølgende API-kald, før I giver skriveadgang.
Brug vurderingen nedenfor til at fastslå jeres organisations udgangspunkt.
Hvorfor automatiserede beslutninger går i stå på grund af dårlige data
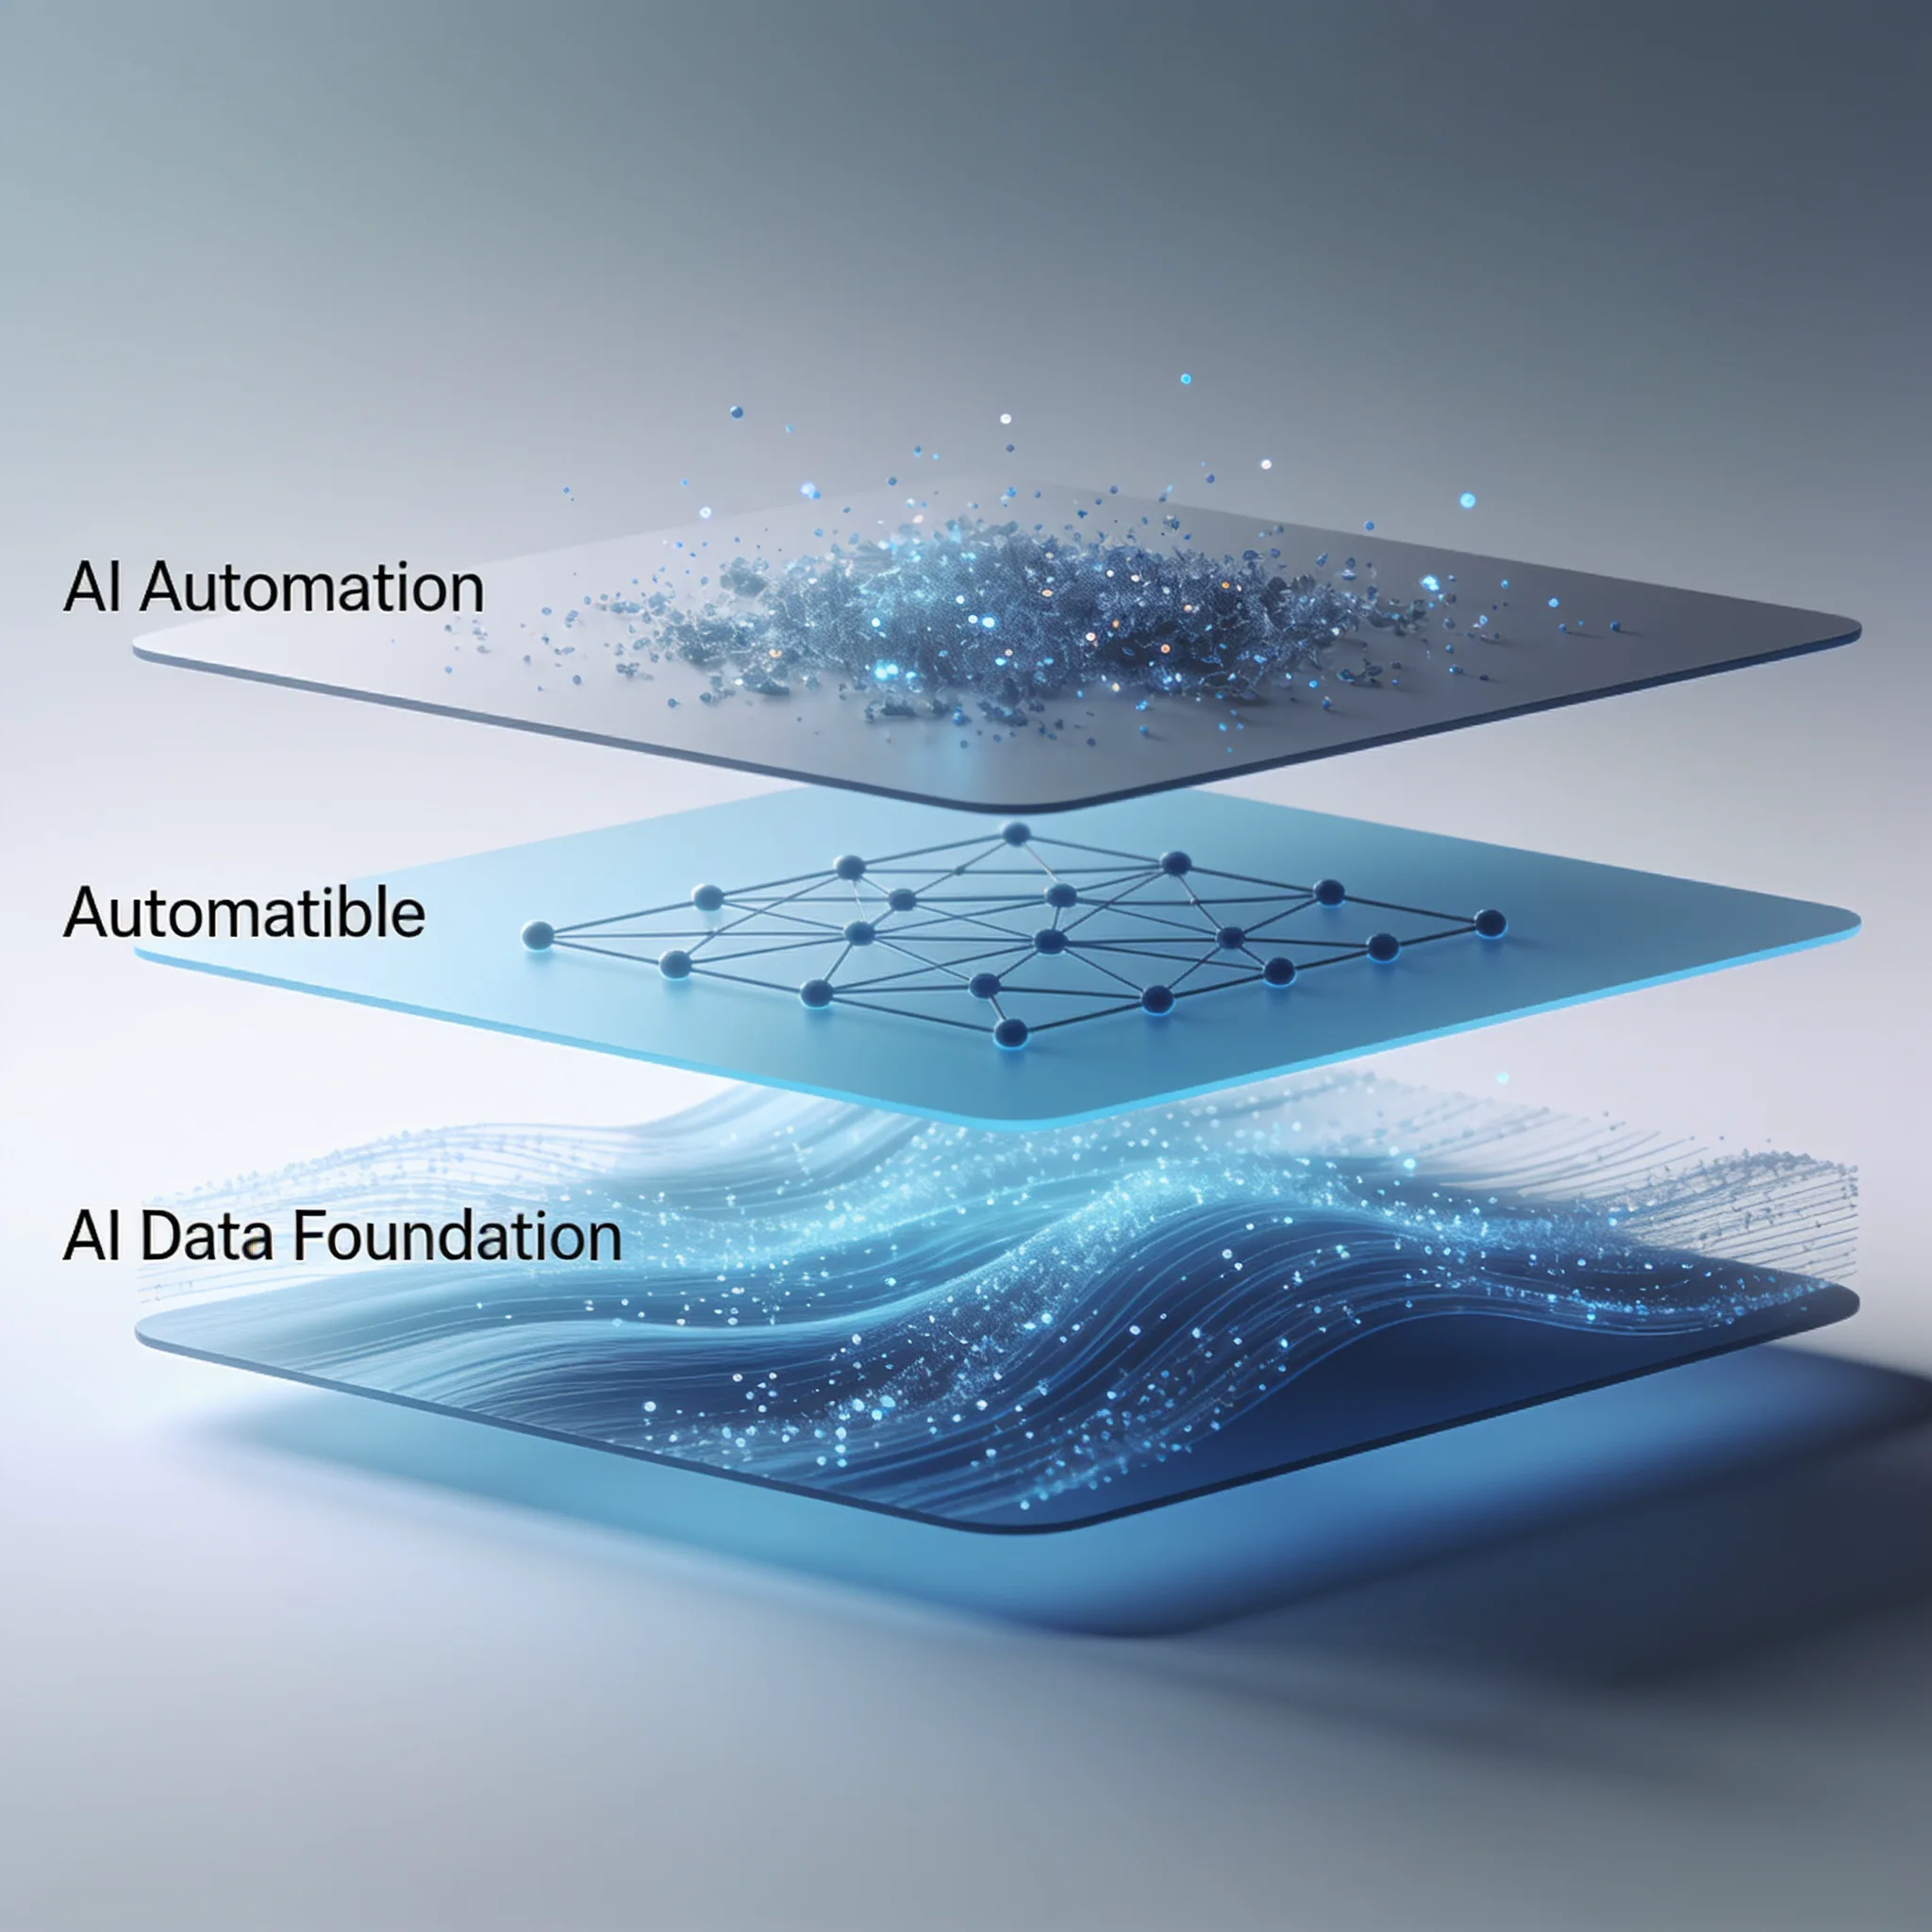
Flaskehalsen i lag 3 opstår, når teams forsøger at bygge automatiseret beslutningslogik uden først at rydde op i deres grundlæggende data. En betydelig andel af alle teams går i stå her, fordi datakvaliteten er for dårlig til, at AI kan ræsonnere pålideligt på grundlag af dataene. Strukturerede data er derfor den egentlige forudsætning for at komme videre.
Den mest almindelige hindring for at gå fra lag 2 til lag 3 i AI-automatisering er datakvalitet, ikke teknologi. At så mange går i stå, afslører en udbredt misforståelse.
Teams køber automatiseringsværktøjer til store virksomheder, før de rydder op i deres datasøer. De går fejlagtigt ud fra, at AI-modellen nok skal finde ud af rodede dataskemaer. Det gør den ikke.
AI kan ikke ræsonnere på grundlag af rodede, ustrukturerede data uden et massivt tokenforbrug og risiko for hallucinationer. Flaskehalsen i lag 3 er i virkeligheden et problem med dataarkitekturen, der ligner en begrænsning i AI.
| Modenhedslag | Fejltype | Primær årsag | Løsning |
|---|---|---|---|
| Lag 1 | Forespørgsler får timeout | Databaser i siloer | Saml dataindsamlingen |
| Lag 2 | Irrelevant output | Statiske rapporter | Tilføj vektorindlejringer |
| Lag 3 | Handlinger baseret på hallucinationer | Ustrukturerede input | Stil faste krav til datakvalitet |
| Lag 4 | Tab af kontekst | Manglende lagring af tilstand | Opbyg vedvarende hukommelse |
Hvis jeres AI handler med stor sikkerhed, men tager fejl, er problemet ikke modellen. Det er dataene. Ret inputtene, før I finjusterer outputtene.
Trin 2: Opbyg den tekniske arkitektur på tværs af leverandørernes økosystemer
AI-automatisering kan opdeles i fire niveauer: trigger, datainput, AI-behandling og routing af output. Efterhånden som du bevæger dig gennem niveauerne, får du brug for forskellige værktøjer.
På niveau 1 bruger man typisk Claude Pro eller ChatGPT Plus med et fælles arbejdsområde som Teams. Her kan du lave enkle udkast og opsummeringer, men der er reelt ingen systemarkitektur. Arbejdet bygger på kopiering og indsættelse, så den største risiko er tab af kontekst.
En bruger indsætter en lang samtale i sprogmodellen, men værktøjet afkorter historikken. Resultatet er ufuldstændige opsummeringer.
Niveau 2 bruger API-værktøjer og automatiseringsplatforme som Make Business eller Zapier Professional. Platformene forbinder dit CRM-system med din AI-model. Niveauet koster cirka $150 til $350 om måneden.
Zapier virker som det oplagte valg, fordi platformen har indbyggede integrationer til alt. Den skjulte ulempe er intervallet mellem API-forespørgsler. På standardabonnementer tjekker Zapier API'er hvert 15.
minut. Hvis dine kundedata ændrer sig, opdager din AI-agent det derfor først op til 15 minutter senere. Det bryder kravet på lag 1 om en forsinkelse på under 5 minutter.
Brug webhook-baserede triggere frem for gentagne API-forespørgsler, hvis agenten skal have opdateret kontekst i realtid.
Niveau 3 omfatter forbundne operationer med flere agenter og kræver agentframeworks med flere trin samt automatiseringsværktøjer til større virksomheder, såsom n8n. Det giver mulighed for forgrenet logik og kompleks routing. n8n kræver egen hosting eller et enterprise-abonnement i skyen.
Dermed flytter omkostningerne sig fra softwarelicenser til udviklingstid i DevOps. Risikoen er at antage, at dit almindelige IT-team kan vedligeholde en selvhostet n8n-instans uden dedikeret overvågning af infrastrukturen bag dine automatiseringsnoder. Uden den overvågning kan en hukommelseslækage i én arbejdsgang lægge hele agentplatformen ned.
Her er et standardformat for en JSON-webhook, der sender data videre til en AI-behandlingsnode på niveau 2:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Når AI-behandlingsnoden modtager disse data, bruger den parameteren `task` til at vælge en bestemt promptskabelon. Hvis Stripe ændrer strukturen i sine API-data og lægger `amount_due` i et indlejret objekt, kan AI-modellen finde på et beløb og skrive en e-mail, hvor der står $0. Derfor kræver vi semantisk versionsstyring af promptskabeloner for at undgå fejl ved opdateringer.
Når du opdaterer en prompt, så den kan håndtere den nye datastruktur fra Stripe, øger du versionsnummeret.
Hvis den nye prompt begynder at finde på oplysninger i produktion, kan du straks rulle tilbage til den tidligere version uden at ændre kodebasen. AI-behandlingsnoden skal også isoleres bag en kø som RabbitMQ. Hvis Sendgrid går ned, må din webhook ikke fejle.
Køen opbevarer dataene og forsøger at sende output igen, indtil det eksterne API virker.
Brug beregneren nedenfor til at anslå dine basisomkostninger ved at bygge en løsning på niveau 3.
Beregner til omkostninger ved AI-automatisering
Anslå de månedlige omkostninger på forskellige lag af AI-automatisering.
Vil du se, hvad AI kan gøre for dine arbejdsgange?
Leveres inden for 3-5 arbejdsdage. Ingen forpligtelser.
Trin 3: Indfør sikkerhed og styring af autonome operationer
På lag 3 (værktøjslaget) kan AI søge i data, men ikke udføre handlinger i eksterne systemer. Den kan altså rådgive, men ikke handle. På lag 6 (autonome operationer) overvåger AI-agenter løbende data, opdager hændelser, analyserer datasæt og handler uden først at blive sat i gang af et menneske.
Springet fra rådgivning til handling medfører betydelige sikkerhedsrisici. Du skal have klare regler for, hvornår AI-agenter må udføre handlinger i eksterne systemer.
Sammenligningen med elektricitet ligger lige for. Selv et elektrisk anlæg kræver et sikringsskab med jordforbindelse. Dine autonome agenter har brug for en tilsvarende sikkerhedsmekanisme.
Vi kræver menneskelig godkendelse af alle handlinger, der omfatter finansielle transaktioner eller sletning af data. Systemet skal sætte handlingen på pause og kontrollere den.
Indfør strenge grænser for antal forespørgsler og rollebaseret adgangskontrol for dine agenters tokens. En agent, der kan udstede refusioner, skal ikke have skriveadgang til dit kildekodelager. Brug API-nøgler med begrænsede rettigheder, som udløber hver 24. time.
En overset pointe: Hukommelse og orkestrering er overvurderet uden rene data
Markedet fremstiller avancerede løsninger med flere agenter som det ultimative mål for AI-automatisering. Det er vi stærkt uenige i. Det er spild af ressourcer at investere i lag 4 og lag 5, hvis lag 1 stadig ikke fungerer.
Lag 4 (hukommelseslaget) giver agenter vedvarende kontekst på tværs af sessioner, så de kan lære af tidligere resultater. Men hvis de underliggende data er fejlbehæftede, lærer agenten blot af fejlene. Et system med flere agenter og dårlige data spreder fejl hurtigere, end en enkelt agent nogensinde kunne.
Den hyppigste hindring for at gå fra lag 2 til lag 3 i AI-automatisering er datakvalitet, ikke teknologi. Problemet forplanter sig opad. Dårlige data forringer alle lag ovenover.
Dataarkitekturen skal på plads før AI-arkitekturen. Hold op med at købe orkestreringsværktøjer, før du har rettet op på strukturen i dit CRM-system. Et enkelt script med rene data slår hver gang et system med flere agenter, der arbejder med dårlige data.
Byg en bedre sammenhængende løsning ved at få fundamentet på plads først.
Sammenhængen mellem lagene i AI-automatisering, afkast og forandringsledelse
Automatiseringsløsningen med 5 lag omfatter dataindsamling, orkestrering af arbejdsgange, beslutningslogik, intelligente handlinger og autonome agenter. Når du kobler de tekniske lag til forretningsresultater, bliver det lettere at få ledelsens opbakning.
Alene hastigheden reducerer den tid, det tager at løse kundesupportsager, markant.
Brug et tænkt eksempel med visitering af supportsager til at modellere løsningen før et pilotprojekt. Indtast organisationens egne tal for antal sager, behandlingsomkostninger, softwareudgifter, modelforbrug, tid til gennemgang og omkostninger ved fejl. Beregn break-even ud fra faktiske input, og fremstil det ikke som et opnået kunderesultat.
For de fleste større virksomheder tager det i gennemsnit 14 måneder at gå fra lag 1 til lag 5. Forvent ikke en forandring fra den ene dag til den anden. Lav en plan for forandringsledelse, som lærer dit team at bruge den nye automatiseringsløsning.
Et pilotprojekt for visitering kan møde modstand blandt medarbejderne, hvis succes kun måles på, hvor mange sager der behandles. I en tænkt udrulning kunne teamet måle, hvor mange komplekse sager der bliver løst, og hvor gode rettelserne er, mens systemet står for rutinemæssig klassificering. Spørg medarbejderne, og offentliggør først de faktiske resultater efter pilotprojektet.
En udrulningsplan bør fastlægge, hvilke sager medarbejderne fortsat skal håndtere, og hvilke kompetencer de har brug for til validering, håndtering af undtagelser og ansvar for systemet. Registrér oplæringstid og ændringer i rollerne under den faktiske udrulning i stedet for at opfinde et resultat for bemandingen.
Hvis du springer forandringsledelsen over, risikerer du, at dit team undergraver datagrundlaget. Medarbejderne skriver ustrukturerede noter i stedet for at bruge rullemenuer. De går uden om CRM-systemet og holder styr på salgsforløb i regneark.
Et system med flere agenter vil hurtigt fejle, når det bygger på data, der er blevet undergravet på den måde. Sådan ser lag i AI-automatisering ud i praksis.
Slip for gætværk. Kom i gang med en klar plan.
Hurtig levering. Målbare resultater. Sikkerhed først.
Ofte stillede spørgsmål
