Lagren i AI-automatisering sträcker sig från en stabil datagrund till autonom, händelsestyrd verksamhet. Varje lager fungerar bara om det underliggande lagret gör det. De flesta team kör fast på lager 3, där rådgivande AI ska börja utföra åtgärder. Orsaken är nästan alltid datakvaliteten, inte modellens förmåga.
- Branschen saknar en gemensam standard, men om man förenar modellerna med 3, 5 och 6 lager framträder en tydlig väg från datagrund till autonom verksamhet.
- 80 % av teamen kör fast på lager 3 (beslutslogik) på grund av ostrukturerade data från lager 1 och 2. Det visar att datakvalitet är ett större hinder än tekniken.
- Att gå från nivå 1 med enskilda verktyg ($45-$120/mån) till nivå 3 med verksamhet som drivs av flera agenter ($400-$800/mån) kräver medvetna arkitekturförändringar och strikt styrning.
Vad är det samlade ramverket för AI-automatiseringens lager?
Det samlade ramverket för AI-automatiseringens lager är en leverantörsoberoende modell för utveckling. Det förenar uppdelade arkitekturer med 3, 5 och 6 lager till en tydlig väg för verksamhetsansvariga. Vi kopplar automatiseringsstackens 5 lager till agentstackens 6 lager för att beskriva AI-mognad från datagrund till autonom verksamhet.
På så sätt utvecklas det tekniska genomförandet och förmågan att fatta beslut i takt med varandra. Båda grupperna måste arbeta mot samma mål.
Automatiseringsstackens 5 lager omfattar datainsamling, pipelineorkestrering, beslutslogik, intelligenta åtgärder och autonoma agenter. Vi kopplar dessa operativa delar till ramverket för agentstackens 6 lager, som beskriver AI-mognad från datagrund till autonom verksamhet. Syftet är att det tekniska genomförandet och förmågan att fatta beslut ska utvecklas tillsammans.
Historiskt har datateam arbetat utifrån modellen med 5 lager, medan maskininlärningsteam har byggt efter modellen med 6 lager. Det har skapat en stor kommunikationsklyfta.
Datateamen fokuserade på att flytta data, medan maskininlärningsteamen fokuserade på hur agenter resonerar i upprepade steg. När modellerna förenas får båda grupperna samma kontrollpunkt. Om datateamen inte kan visa att pipelineorkestreringen i modellen med 5 lager hanterar undantagsfall, får maskininlärningsteamen inte gå vidare till verktygsanvändning i modellen med 6 lager.
Lager 1 (datagrund) innebär att data finns i åtskilda silor, utan ett gemensamt frågelager för AI. Teamen lägger veckor på att skriva egna skript för att besvara grundläggande verksamhetsfrågor. För de flesta företag är detta utgångsläget.
Misstaget här är att tro att ett datalager löser problemet. Vi ser företag lägga in råa CSV-filer i Snowflake och stolt kalla det lager 1. Det är en fälla.
Om en AI-agent måste skriva egen SQL för att tolka ostrukturerade textfält bara för att hitta ett kund-id, arbetar ni fortfarande i silor.
En agent som agerar utifrån inaktuella lageruppgifter kan beställa varor som inte finns eller missa en försäljningstopp. Testa kraven på aktualitet, sent inkomna händelser och avstämning innan systemet får lägga en beställning.
Lager 3 (verktygslager) innebär att AI kan söka i data men inte utföra åtgärder i externa system. Intelligensen kan alltså ge råd, men inte omsättas i handling. Här tar det stopp för de flesta team.
Lager 4 (minneslager) ger agenter bestående kontext mellan sessioner. De kan lära sig av tidigare resultat och sluta upprepa kända misstag. De kommer ihåg användarnas preferenser och tidigare fel.
Ett undantagsfall som kan slå sönder detta lager är att information läcker mellan sessioner: en agent minns en viss användares rabattkod och använder den av misstag i en ny användares session. Det blir en dataläcka. Minneslager kräver strikt separering av namnrymder per användare.
Lager 5 (orkestreringslager) gör det möjligt för flera specialiserade agenter att samarbeta kring komplexa uppgifter, i sekvens, parallellt eller hierarkiskt. Det är en arkitektur med flera agenter. Team försöker ofta hoppa över lager 4 och gå direkt till lager 5.
Då kan agenterna inte behålla information mellan sina egna uppgifter i en sekvens. Resultatet blir orkestreringsloopar där agenter ständigt ber varandra om data som de redan har hämtat. Det kan öka era tokenkostnader med en faktor på 10 och rasera avkastningen på investeringen.
Lager 6 (autonom verksamhet) innebär att AI-agenter löpande övervakar data, upptäcker händelser, analyserar datamängder och agerar utan att en människa behöver sätta igång dem. Det är slutmålet.
Steg 1: Ta reda på var ni befinner er i AI-automatiseringen
Många automatiseringsprojekt misslyckas för att teamen hoppar över grundläggande lager eller börjar på fel ställe i automatiseringsstacken. Kartlägg nuläget innan ni lägger till agenter.
Vi använder en tydlig checklista för självutvärdering för att hitta rätt utgångspunkt. Den hjälper er att undvika att bygga en onödigt komplex lösning innan grunderna fungerar. Gå igenom punkterna för att se hur redo ni är.
- Datafördröjning: Kontrollera hur lång tid det tar att sammanställa centrala verksamhetsdata. Tar det flera timmar? Då sitter ni fast på lager 1.
- Möjlighet att söka i data: Undersök om en människa måste ställa frågor för att få fram insikter ur era data. Om AI inte kan söka självständigt i databasen befinner ni er på lager 2.
- Behörighet att agera: Granska behörigheterna för era API:er. Om er AI kan läsa data men saknar skrivbehörighet i externa system har ni nått taket för lager 3.
- Bestående kontext: Testa minnet mellan sessioner. Om agenten glömmer tidigare interaktioner när en ny session börjar saknar ni helt förmågan som krävs för lager 4.
En pipeline som duger för rapportering kan ändå fallera när programvara ska agera utifrån dess data. Testa schemaändringar, saknade fält, inaktuella poster, dubbletter av händelser och API-fel i nedströms system innan ni ger skrivbehörighet.
Använd bedömningen nedan för att kartlägga organisationens mognad.
Varför automatiserade beslut kör fast på bristfälliga data
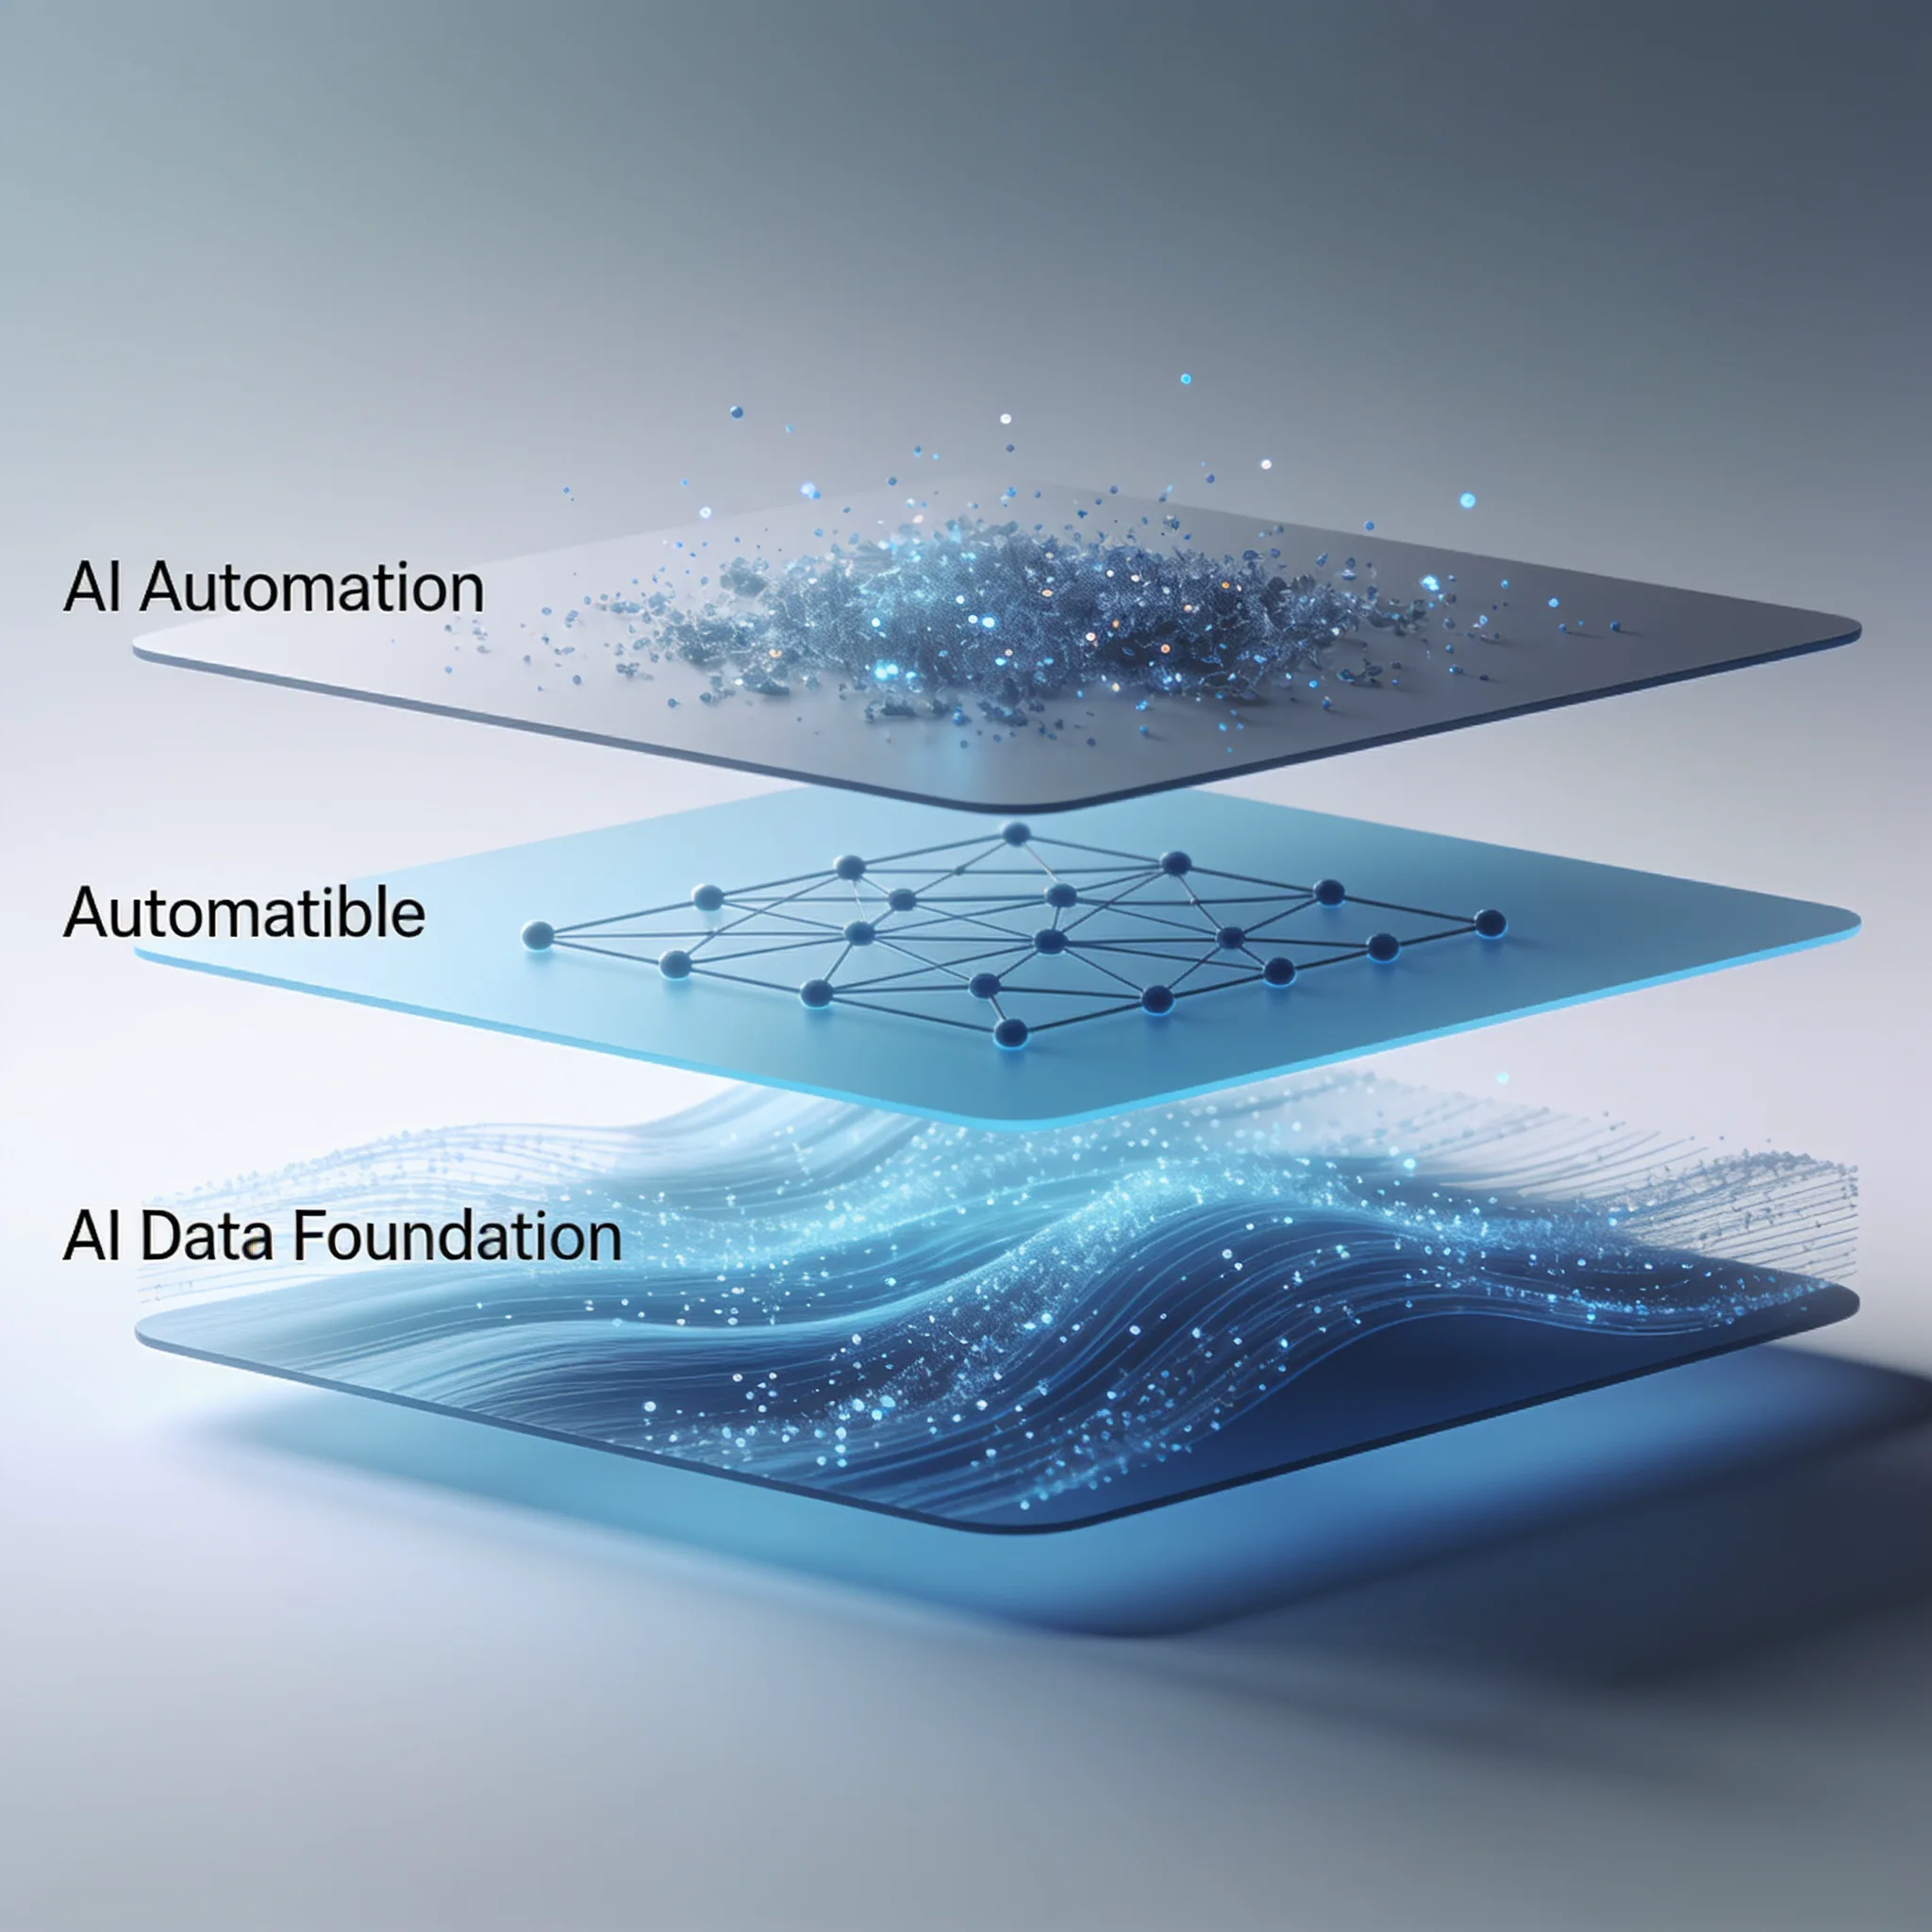
Stoppet på lager 3 uppstår när team försöker bygga automatiserad beslutslogik utan att först rensa upp i sina grundläggande data. En betydande andel av teamen misslyckas här eftersom datakvaliteten är för låg för att AI ska kunna dra tillförlitliga slutsatser. Strukturerade data är alltså det verkliga villkoret för att komma vidare.
Det vanligaste hindret för att ta sig från lager 2 till lager 3 i AI-automatisering är datakvalitet, inte teknik. Att så många kör fast avslöjar en utbredd missuppfattning.
Team köper automatiseringsverktyg för stora företag innan de har rensat upp i sina datasjöar. De utgår felaktigt från att AI-modellen ska reda ut röriga datascheman. Det gör den inte.
AI kan inte dra tillförlitliga slutsatser ur ostrukturerat skräp utan enorm tokenförbrukning och risk för hallucinationer. Stoppet på lager 3 är i själva verket ett problem med dataarkitekturen som ser ut som en begränsning hos AI.
| Mognadslager | Problem | Huvudorsak | Åtgärd |
|---|---|---|---|
| Lager 1 | Tidsgränsen för frågor överskrids | Databaser i silor | Samla datainsamlingen centralt |
| Lager 2 | Irrelevanta resultat | Statiska rapporter | Lägg till vektorinbäddningar |
| Lager 3 | Påhittade åtgärder | Ostrukturerade indata | Inför servicenivåkrav för datakvalitet |
| Lager 4 | Förlorad kontext | Saknad lagring av tillstånd | Bygg ett bestående minne |
Om er AI utför felaktiga åtgärder med stor säkerhet är det inte modellen som är problemet. Det är era data. Rätta till indata innan ni finjusterar resultaten.
Steg 2: Utforma teknikstacken för olika leverantörsekosystem
Nivåerna i en AI-automatiseringsstack kan delas upp i utlösare, datainmatning, AI-bearbetning och vidarebefordran av resultat. Du behöver olika verktyg i takt med att du bygger ut de här delarna.
AI-automatisering på nivå 1 använder vanligtvis Claude Pro eller ChatGPT Plus tillsammans med en gemensam arbetsyta som Teams. På den här nivån handlar det främst om att skriva utkast och sammanfatta. Någon egentlig arkitektur finns inte.
Du förlitar dig på att kopiera och klistra in, vilket gör förlorad kontext till den största risken. En användare klistrar in en lång konversation i språkmodellen, men verktyget kapar historiken och sammanfattningen blir ofullständig.
AI-automatisering på nivå 2 använder API-verktyg och automatiseringsplattformar som Make Business eller Zapier Professional. Plattformarna kopplar ditt CRM till din AI-modell. Den här nivån kostar cirka $150 till $350 per månad.
Zapier kan verka som det självklara valet eftersom det har inbyggda integrationer för allt. Nackdelen som lätt missas är intervallet för API-kontroller. Med standardabonnemang kontrollerar Zapier API:er var 15:e minut.
Om dina kunddata ändras får AI-agenten alltså inte veta det på 15 minuter, vilket bryter mot nivå 1:s krav på en fördröjning under 5 minuter. För att behålla kontexten i realtid måste du använda webhook-baserade utlösare i stället för återkommande API-kontroller.
Nivå 3, sammankopplade arbetsflöden med flera agenter, kräver agentramverk med flera steg och avancerade automatiseringsverktyg som n8n. Här kan du hantera förgrenad logik och komplex vidarebefordran. n8n kräver egen drift eller företagsabonnemang i molnet, vilket flyttar kostnaden från programvarulicenser till DevOps-arbete.
Risken är att anta att ditt vanliga IT-team kan underhålla en egen n8n-instans utan särskild övervakning av automatiseringsnoderna. Annars kan en minnesläcka i ett enda arbetsflöde slå ut hela agentplattformen.
Här är ett standardexempel på en JSON-payload för en webhook som leder automatisering på nivå 2 till en AI-bearbetningsnod:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
När AI-bearbetningsnoden tar emot denna payload använder den parametern `task` för att välja en viss promptmall. Om Stripe ändrar strukturen i sin API-payload och lägger `amount_due` i ett nästlat objekt kan din AI-modell hitta på ett värde och skriva ett mejl om $0. Vi kräver semantisk versionshantering av promptmallar för att förhindra regressioner.
När du uppdaterar en prompt för att hantera Stripes nya payload-struktur höjer du versionsnumret.
Om den nya prompten börjar hallucinera i produktion kan du direkt återgå till föregående version utan att röra koden. Du isolerar också AI-bearbetningsnoden bakom en kö som RabbitMQ. Om Sendgrid ligger nere ska din webhook inte misslyckas.
Kön behåller payloaden och försöker vidarebefordra resultatet på nytt tills det externa API:et fungerar igen.
Beräkna dina grundkostnader för att bygga en stack på nivå 3 med kalkylatorn nedan.
Kostnadskalkylator för AI-automatisering
Uppskatta månadskostnaden för olika nivåer av AI-automatisering.
Vill du se vad AI kan göra för din verksamhet?
Levereras inom 3-5 arbetsdagar. Inga förpliktelser.
Steg 3: Inför säkerhet och styrning för autonoma arbetsflöden
Nivå 3 (verktygslagret) innebär att AI kan söka i data men inte utföra åtgärder i externa system. Den kan ge råd, men inte agera. På nivå 6 (autonoma arbetsflöden) övervakar AI-agenter data kontinuerligt, upptäcker händelser, analyserar datamängder och agerar utan att en människa behöver sätta igång dem.
Steget från rådgivning till handling medför stora säkerhetsrisker. Du måste införa styrningsrutiner för när AI-agenter får utföra åtgärder i externa system.
En vanlig jämförelse är elektricitet. Även el behöver en jordad elcentral med säkringar. Dina autonoma agenter behöver motsvarande nödstopp.
Vi kräver att en människa granskar och godkänner alla åtgärder som rör finansiella transaktioner eller radering av data. Systemet måste pausa och invänta kontroll.
Sätt strikta hastighetsbegränsningar och rollbaserad åtkomstkontroll för agenternas åtkomsttoken. En agent som kan utfärda återbetalningar ska inte ha skrivbehörighet till ditt källkodsförråd. Använd API-nycklar med begränsade behörigheter som löper ut var 24:e timme.
En mindre uppenbar insikt: Därför är minne och orkestrering överskattade utan rena data
Marknaden framställer avancerade lösningar med flera agenter som det yttersta målet för AI-automatisering. Vi håller inte med. Det är meningslöst att investera i nivå 4 och nivå 5 om nivå 1 fortfarande brister.
Nivå 4 (minneslagret) ger agenter bestående kontext mellan sessioner så att de kan lära sig av tidigare resultat. Men om underliggande data är felaktiga lär sig agenten bara av misstagen. Ett system med flera agenter som arbetar med dåliga data skalar upp felen snabbare än en enskild agent någonsin skulle kunna göra.
Det vanligaste hindret för att gå från nivå 2 till nivå 3 inom AI-automatisering är datakvalitet, inte teknik. Problemet följer med uppåt. Dåliga data påverkar varje nivå ovanför.
Dataarkitekturen måste komma före AI-arkitekturen. Sluta köpa orkestreringsverktyg innan du har rättat till strukturen i ditt CRM. Ett enkelt skript med rena data slår alltid ett system med flera agenter som arbetar med undermåliga data. Börja med grunden för att bygga en bättre kedja.
Koppla nivåerna av AI-automatisering till affärsnytta och förändringsledning
Automatiseringsstackens 5 nivåer omfattar datainsamling, orkestrering av pipelines, beslutslogik, intelligenta åtgärder och autonoma agenter. Genom att koppla de tekniska nivåerna till affärsresultat kan du få ledningens stöd.
Bara den här snabbheten kan korta tiden det tar att lösa kundsupportärenden avsevärt.
Utgå från en tänkt arbetsbelastning för prioritering av supportärenden för att modellera stacken före en pilot. Ange organisationens egen ärendevolym, handläggningskostnad, programvaruavgifter, modellanvändning, granskningstid och kostnad för fel. Brytpunkten ska beräknas utifrån observerade värden, inte framställas som ett kundresultat.
Att gå från nivå 1 till nivå 5 tar i genomsnitt 14 månader för de flesta större företag. Räkna inte med att förändringen sker över en natt. Ta fram en plan för förändringsledning som lär teamet att arbeta med den nya automatiseringsstacken.
En pilot för ärendeprioritering kan väcka motstånd hos personalen om framgång bara mäts i antal hanterade ärenden. I en tänkt utrullning skulle teamet kunna mäta hur många komplexa problem som löses och kvaliteten på korrigeringar, medan systemet sköter rutinmässig klassificering. Fråga personalen och publicera det faktiska resultatet först efter piloten.
En utrullningsplan bör ange vilka ärenden som även fortsättningsvis ska hanteras av personalen och vilka färdigheter de behöver för validering, undantagshantering och ansvar för systemet. Dokumentera utbildningstid och förändrade roller utifrån den faktiska utrullningen i stället för att hitta på ett personalresultat.
Om du hoppar över förändringsledningen riskerar teamet att underminera datagrunden. De skriver ostrukturerade anteckningar i stället för att använda rullgardinsfält, går förbi CRM-systemet och följer affärer i kalkylblad. Ett system med flera agenter som arbetar med dessa försämrade data kommer då snabbt att misslyckas.
Så fungerar nivåer av AI-automatisering i praktiken.
Sluta gissa. Börja bygga utifrån en tydlig plan.
Snabb leverans. Mätbara resultat. Säkerhet från start.
Vanliga frågor
