I livelli dell’automazione AI vanno da una base di dati affidabile fino alle operazioni autonome basate su eventi. Ogni livello funziona solo se quello sottostante è solido. La maggior parte dei team si blocca al Livello 3, quando l’AI deve passare dai consigli alle azioni. La causa è quasi sempre la qualità dei dati, non la capacità del modello.
- Nel settore manca uno standard, ma unificando i modelli a 3, 5 e 6 livelli emerge un percorso chiaro, dalle basi dei dati alle operazioni autonome.
- L’80% dei team si blocca al Livello 3 (logica decisionale) a causa dei dati non strutturati provenienti dai Livelli 1 e 2. È la prova che la qualità dei dati è un ostacolo maggiore della tecnologia.
- Passare dagli strumenti individuali del Livello 1 ($45-$120/mese) alle operazioni multiagente del Livello 3 ($400-$800/mese) richiede scelte architetturali deliberate e una governance rigorosa.
Che cos’è il framework unificato dei livelli dell’automazione AI?
Il framework unificato dei livelli dell’automazione AI è un modello di progressione indipendente dai fornitori. Riunisce le architetture frammentate a 3, 5 e 6 livelli in un percorso chiaro per chi gestisce le operazioni. Mettiamo in relazione l’Automation Stack a 5 livelli con lo stack degli agenti a 6 livelli per descrivere la maturità dell’AI, dalle basi dei dati alle operazioni autonome.
Così, l’esecuzione tecnica e la maturità delle capacità decisionali avanzano insieme. I due ambiti devono essere allineati.
L’Automation Stack a 5 livelli comprende acquisizione dei dati, orchestrazione delle pipeline, logica decisionale, azioni intelligenti e agenti autonomi. Colleghiamo questi componenti operativi al framework dello stack degli agenti a 6 livelli, che descrive la maturità dell’AI dalle basi dei dati alle operazioni autonome, affinché l’esecuzione tecnica e le capacità decisionali progrediscano insieme. Storicamente, i team di data engineering seguivano il modello a 5 livelli, mentre i team di machine learning sviluppavano in base a quello a 6 livelli.
Ne derivava un forte divario di comunicazione.
I team dei dati si concentravano sul trasferimento dei dati, quelli di ML sui cicli di ragionamento. Unificando i modelli, imponiamo a entrambi una stessa tappa di verifica: se il team dei dati non riesce a dimostrare che l’orchestrazione delle pipeline del modello a 5 livelli gestisce i casi limite, il team di ML non può procedere all’esecuzione degli strumenti del modello a 6 livelli.
Il Livello 1 (basi dei dati) è quello in cui i dati esistono in silos scollegati, senza un livello unificato che permetta all’AI di interrogarli. I team passano settimane a scrivere script personalizzati per rispondere a semplici domande operative. Questo approccio manuale è il punto di partenza della maggior parte delle aziende.
L’errore è pensare che basti un data warehouse. Vediamo aziende caricare file CSV grezzi su Snowflake e definirlo con orgoglio Livello 1. È una trappola.
Se un agente AI deve scrivere SQL personalizzato per analizzare campi di testo non strutturati solo per trovare l’ID di un cliente, i dati sono ancora in silos.
Un agente che agisce su dati di inventario obsoleti può ordinare prodotti non disponibili o non cogliere un picco delle vendite. Verifica i requisiti di aggiornamento dei dati, gli eventi che arrivano in ritardo e la riconciliazione prima di consentire al sistema di effettuare un ordine.
Al Livello 3 (livello degli strumenti), l’AI può interrogare i dati ma non agire nei sistemi esterni. Le sue indicazioni restano quindi consultive, anziché tradursi in azioni. È qui che la maggior parte dei team si blocca.
Il Livello 4 (livello della memoria) offre agli agenti un contesto persistente tra una sessione e l’altra. Possono così imparare dai risultati precedenti ed evitare di ripetere errori noti. Ricordano le preferenze degli utenti e gli insuccessi passati.
Il caso limite che compromette questo livello è la contaminazione dello stato: un agente ricorda il codice sconto di un utente e lo applica per errore alla sessione di un altro, causando una fuga di dati. I livelli di memoria richiedono un isolamento rigoroso degli spazi dei nomi per ciascun utente.
Il Livello 5 (livello dell’orchestrazione) permette a più agenti specializzati di collaborare su attività complesse secondo schemi sequenziali, paralleli o gerarchici. Questa è l’architettura multiagente. Spesso i team cercano di saltare il Livello 4 e passare direttamente al Livello 5.
I loro agenti, però, non riescono a conservare lo stato tra le proprie attività sequenziali. Il risultato sono cicli di orchestrazione in cui gli agenti continuano a chiedersi dati che hanno già recuperato, moltiplicando per 10 i costi in token e azzerando il ritorno sull’investimento.
Il Livello 6 (operazioni autonome) prevede agenti AI che monitorano continuamente i dati, rilevano eventi, analizzano i dataset e agiscono senza che una persona debba avviarli. È l’obiettivo finale.
Passaggio 1: individua il livello di automazione AI in cui ti trovi
Molti progetti di automazione falliscono perché i team saltano i livelli fondamentali o partono da quello sbagliato dello stack. Prima di aggiungere agenti, devi valutare la situazione attuale.
Usiamo una checklist rigorosa di autovalutazione per individuare il punto di partenza ed evitare di complicare la soluzione prima ancora che le basi siano operative. Segui questi controlli per capire se sei pronto.
- Latenza dei dati: verifica quanto tempo serve per aggregare i principali dati operativi. Servono ore? Allora sei fermo al Livello 1.
- Struttura delle interrogazioni: controlla se, per ottenere informazioni dai dati, una persona deve inserire un prompt. Se l’AI non può interrogare il database in autonomia, sei al Livello 2.
- Permessi di azione: verifica gli ambiti di autorizzazione delle API. Se l’AI può leggere i dati ma non ha accesso in scrittura ai sistemi esterni, hai raggiunto il limite del Livello 3.
- Persistenza del contesto: metti alla prova la memoria tra le sessioni. Se l’agente dimentica le interazioni precedenti all’avvio di una nuova sessione, ti mancano del tutto le capacità del Livello 4.
Una pipeline adeguata per il reporting può comunque fallire quando un software usa i suoi dati per agire. Prima di abilitare le operazioni di scrittura, verifica le modifiche agli schemi, i campi mancanti, i record obsoleti, gli eventi duplicati e gli errori delle API a valle.
Usa la valutazione qui sotto per stabilire il livello di maturità della tua organizzazione.
Perché l’automazione delle decisioni si blocca quando i dati sono inaffidabili
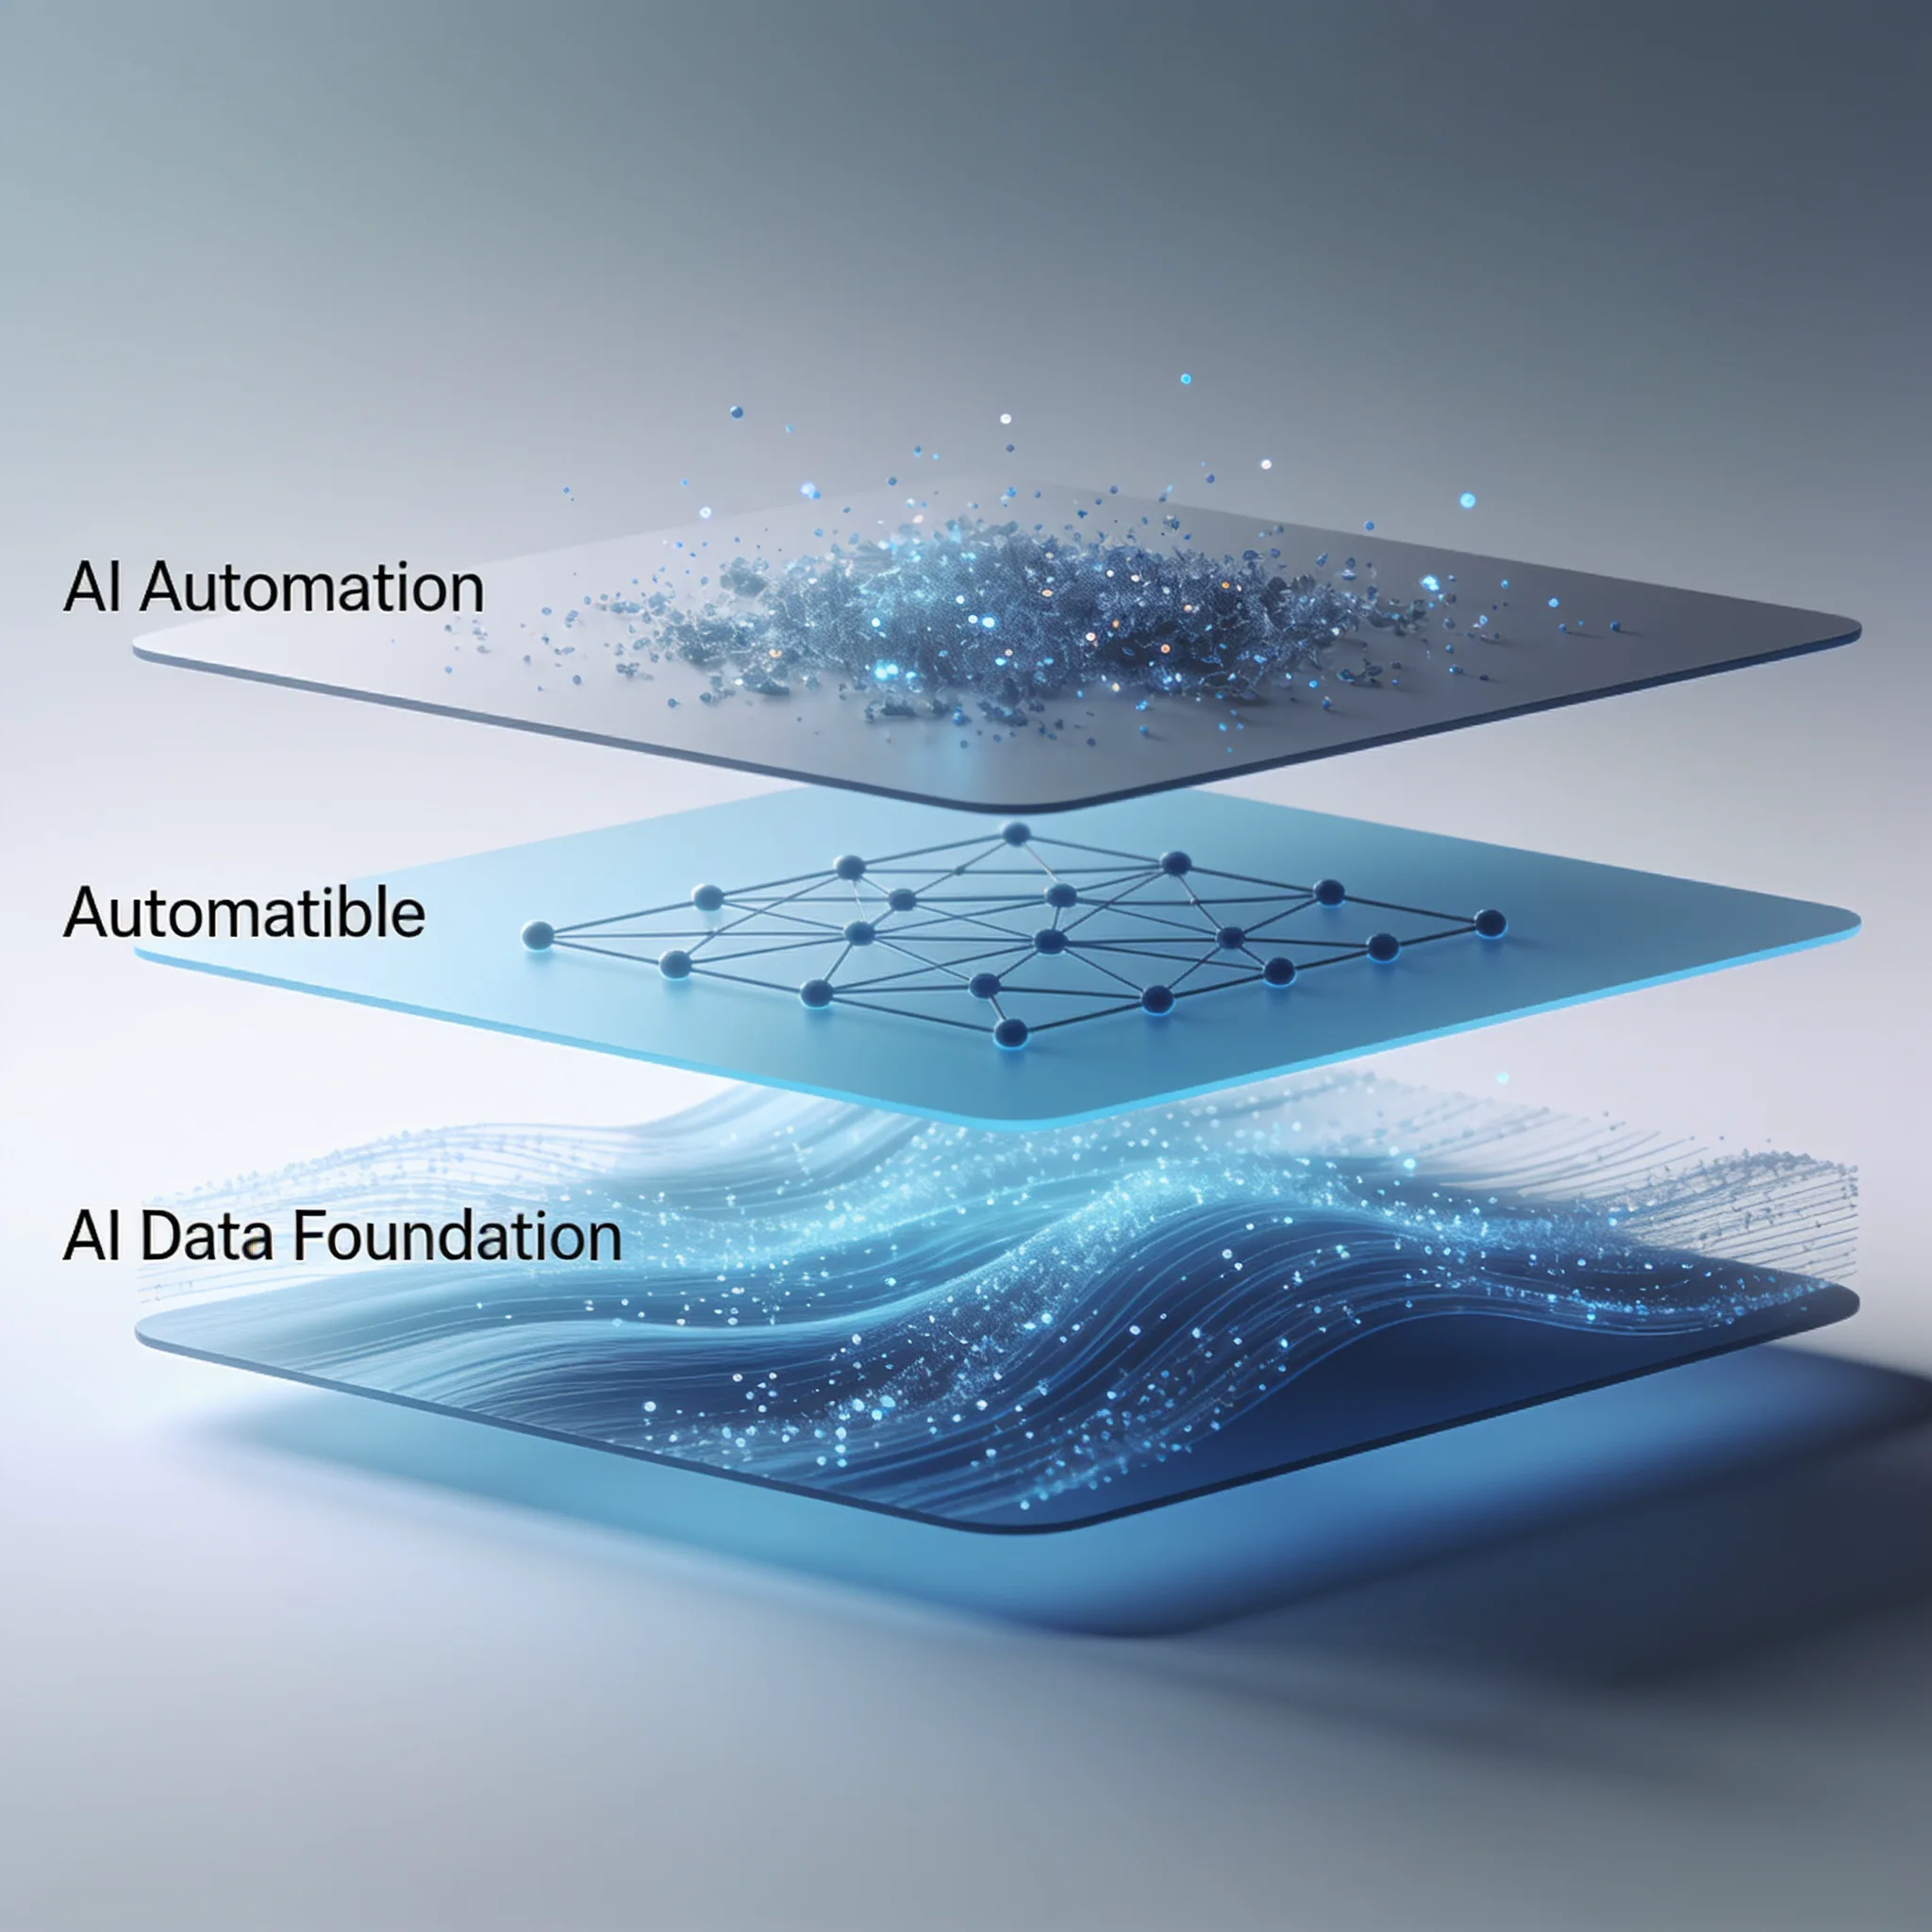
Lo stallo al Livello 3 si verifica quando i team cercano di automatizzare la logica decisionale senza prima ripulire i dati di base. Una percentuale significativa di team fallisce in questa fase perché la qualità dei dati è troppo scarsa perché l’AI possa analizzarli in modo affidabile. Il vero ostacolo al progresso è quindi la mancanza di dati strutturati.
Nel passaggio dal Livello 2 al Livello 3 dell’automazione AI, l’ostacolo più comune è la qualità dei dati, non la tecnologia. Questo tasso di insuccesso rivela una convinzione errata molto diffusa.
I team acquistano strumenti di automazione aziendali prima di ripulire i propri data lake, presumendo che il modello AI saprà interpretare schemi disordinati. Non è così. L’AI non può ragionare su dati non strutturati e inutilizzabili senza consumare enormi quantità di token e rischiare allucinazioni.
Lo stallo al Livello 3 è in realtà un problema di architettura dei dati che sembra un limite dell’AI.
| Livello di maturità | Problema | Causa principale | Come risolvere |
|---|---|---|---|
| Livello 1 | Timeout delle interrogazioni | Database in silos | Centralizzare l’acquisizione dei dati |
| Livello 2 | Risultati irrilevanti | Report statici | Aggiungere embedding vettoriali |
| Livello 3 | Azioni basate su allucinazioni | Input non strutturati | Imporre SLA sulla qualità dei dati |
| Livello 4 | Perdita del contesto | Archivi di stato mancanti | Creare una memoria persistente |
Se la tua AI esegue azioni sbagliate con apparente sicurezza, il problema non è il modello. Sono i dati. Correggi gli input prima di perfezionare gli output.
Passaggio 2: progetta lo stack tecnico nei diversi ecosistemi dei fornitori
Lo stack dell’automazione AI si può suddividere in attivazione, acquisizione dei dati, elaborazione AI e instradamento dei risultati. Man mano che passi da una fase all’altra, ti servono strumenti diversi.
L’automazione AI di livello 1 usa in genere Claude Pro o ChatGPT Plus con uno spazio di lavoro condiviso come Teams. A questo livello si preparano bozze e riepiloghi semplici, senza una vera architettura. Si lavora copiando e incollando, quindi il rischio principale è la perdita di contesto.
Un utente incolla una lunga conversazione nell’LLM, ma lo strumento ne tronca la cronologia e produce un riepilogo incompleto.
L’automazione AI di livello 2 usa API e piattaforme di automazione come Make Business o Zapier Professional. Queste piattaforme collegano il tuo CRM al modello AI. Il costo è di circa $150-$350 al mese.
Zapier sembra la scelta ovvia perché offre integrazioni native praticamente per tutto, ma nasconde un compromesso: la frequenza di polling. Nei piani standard, Zapier interroga le API ogni 15 minuti. Se i dati dei clienti cambiano, il tuo agente AI potrebbe non saperlo per 15 minuti, violando il requisito di latenza inferiore a 5 minuti del livello 1.
Per mantenere il contesto aggiornato in tempo reale, devi usare trigger basati su webhook anziché sul polling.
Il livello 3, con operazioni multiagente connesse, richiede framework per agenti articolati in più passaggi e strumenti di automazione aziendale come n8n. Gestisce diramazioni logiche e instradamenti complessi. n8n richiede un’installazione autogestita o piani cloud enterprise: il costo si sposta quindi dalle licenze software alle ore di lavoro DevOps.
Il rischio è presumere che il tuo normale team IT possa gestire un’istanza autogestita di n8n senza un monitoraggio dedicato dell’infrastruttura dei nodi di automazione. Senza quel monitoraggio, una perdita di memoria in un solo workflow può bloccare l’intera piattaforma di agenti.
Ecco un payload JSON standard inviato tramite webhook per instradare un’automazione di livello 2 verso un nodo di elaborazione AI:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Quando il nodo di elaborazione AI riceve questo payload, usa il parametro `task` per scegliere un template di prompt specifico. Se Stripe modifica la struttura del payload della sua API e inserisce `amount_due` in un oggetto annidato, il modello AI potrebbe inventare il valore e preparare un’email per $0. Per evitare regressioni, richiediamo il versionamento semantico dei template di prompt.
Quando aggiorni un prompt per gestire la nuova struttura del payload di Stripe, incrementi il numero di versione.
Se il nuovo prompt produce valori inventati in produzione, puoi ripristinare immediatamente la versione precedente senza toccare il codice. Inoltre, isoli il nodo di elaborazione AI dietro una coda come RabbitMQ. Se Sendgrid non è disponibile, il webhook non deve fallire.
La coda conserva il payload e ritenta l’instradamento del risultato finché l’API esterna non torna disponibile.
Calcola i costi di base per realizzare uno stack di livello 3 con il calcolatore qui sotto.
Calcolatore dei costi dell’automazione AI
Stima i costi mensili dei diversi livelli di automazione AI.
Vuoi scoprire cosa può fare l’AI per le tue attività operative?
Consegna in 3-5 giorni lavorativi. Nessun impegno richiesto.
Passaggio 3: implementa sicurezza e governance per le operazioni autonome
Al livello 3 (livello degli strumenti), l’AI può interrogare i dati ma non agire nei sistemi esterni: offre indicazioni, senza poterle eseguire. Al livello 6 (operazioni autonome), gli agenti AI monitorano continuamente i dati, rilevano eventi, analizzano i dataset e intervengono senza che una persona debba avviare l’azione.
Il passaggio dalle indicazioni alle azioni eseguibili comporta enormi rischi per la sicurezza. Devi definire protocolli di governance per le azioni che gli agenti AI eseguono nei sistemi esterni.
Il paragone più immediato è con l’elettricità. Anche un impianto elettrico ha bisogno di un quadro con messa a terra e interruttori di protezione. I tuoi agenti autonomi hanno bisogno di un’architettura equivalente.
Richiediamo controlli con intervento umano per qualsiasi azione che comporti transazioni finanziarie o cancellazione di dati. Il sistema deve fermarsi e chiedere una verifica.
Imposta limiti rigorosi alla frequenza delle richieste e un controllo degli accessi basato sui ruoli per i token dei tuoi agenti. Un agente che può emettere rimborsi non dovrebbe avere accesso in scrittura al repository del codice sorgente. Usa chiavi API con autorizzazioni limitate che scadano ogni 24 ore.
Un aspetto trascurato: perché memoria e orchestrazione sono sopravvalutate senza dati puliti
Il mercato presenta le configurazioni multiagente avanzate come il traguardo dell’automazione AI. Noi non siamo d’accordo. Investire nei livelli 4 e 5 è del tutto inutile se il livello 1 ha ancora problemi.
Il livello 4 (livello della memoria) dà agli agenti un contesto persistente tra una sessione e l’altra, permettendo loro di apprendere dai risultati precedenti. Ma se i dati di partenza sono corrotti, l’agente si limita a memorizzare gli errori. Un sistema multiagente alimentato con dati scadenti amplifica i problemi più rapidamente di quanto potrebbe fare un singolo agente.
L’ostacolo più comune nel passaggio dal livello 2 al livello 3 dell’automazione AI è la qualità dei dati, non la tecnologia. E il problema si ripercuote su tutti i livelli successivi.
L’architettura dei dati deve venire prima di quella dell’AI. Smetti di comprare strumenti di orchestrazione finché non hai sistemato lo schema del tuo CRM: uno script semplice che usa dati puliti batte ogni volta un sistema multiagente alimentato con dati spazzatura. Per costruire una catena più solida, parti dalle fondamenta.
Collegare i livelli di automazione AI al ritorno sull’investimento e alla gestione del cambiamento
Lo stack di automazione a 5 livelli comprende acquisizione dei dati, orchestrazione della pipeline, logica decisionale, azioni intelligenti e agenti autonomi. Collegare questi livelli tecnici ai risultati aziendali è il modo per ottenere il sostegno della dirigenza.
Questa velocità, da sola, riduce drasticamente i tempi di risoluzione delle richieste di assistenza clienti.
Prima di avviare un progetto pilota, usa un carico di lavoro ipotetico di classificazione dei ticket per modellare lo stack. Inserisci il volume, il costo di gestione, i costi del software, l’utilizzo del modello, il tempo di revisione e il costo degli errori della tua organizzazione. Il punto di pareggio va calcolato con i dati rilevati, non presentato come un risultato ottenuto da un cliente.
Per la maggior parte delle grandi aziende, passare dal livello 1 al livello 5 richiede in media 14 mesi. Non aspettarti una trasformazione da un giorno all’altro. Prepara un piano di gestione del cambiamento che formi il team all’uso del nuovo stack di automazione.
Un progetto pilota per la classificazione dei ticket può incontrare resistenze tra il personale se il successo viene misurato solo in base al numero di ticket gestiti. In un’implementazione ipotetica, il team potrebbe misurare i casi complessi risolti e la qualità delle correzioni, mentre il sistema gestisce la classificazione ordinaria. Raccogli le opinioni del personale e pubblica i risultati effettivi solo dopo il progetto pilota.
Il piano di implementazione dovrebbe precisare quali casi restano al personale e quali competenze servono per la validazione, la gestione delle eccezioni e la responsabilità del sistema. Registra il tempo dedicato alla formazione e i cambiamenti nei ruoli durante l’implementazione effettiva, invece di inventare risultati relativi all’organico.
Se salti questa fase di gestione del cambiamento, il tuo team finirà per compromettere la base dati: inserirà note non strutturate invece di usare i campi a tendina, aggirerà il CRM e terrà traccia delle trattative nei fogli di calcolo. Un sistema multiagente alimentato con dati così compromessi fallirà subito. È così che si presentano, nella pratica, i livelli di automazione AI.
Basta andare a tentativi. Inizia a costruire con un piano chiaro.
Consegna rapida. Risultati misurabili. Sicurezza al primo posto.
Domande frequenti
