De lagen van AI-automatisering lopen van een betrouwbare databasis tot autonome, gebeurtenisgestuurde bedrijfsvoering. Elke laag werkt alleen als de laag eronder goed functioneert. De meeste teams lopen vast bij laag 3, waar adviserende AI zelfstandig handelingen moet gaan uitvoeren. De oorzaak is vrijwel altijd de datakwaliteit, niet wat het model kan.
- De sector kent geen standaardmodel, maar door de modellen met 3, 5 en 6 lagen samen te brengen, ontstaat een duidelijk groeipad van databasis naar autonome bedrijfsvoering.
- 80% van de teams loopt vast bij laag 3 (beslislogica) door ongestructureerde data uit laag 1 en 2. Dat laat zien dat datakwaliteit een grotere hindernis is dan technologie.
- Opschalen van individuele tools op niveau 1 ($45-$120/mnd) naar bedrijfsvoering met meerdere agents op niveau 3 ($400-$800/mnd) vraagt om bewuste architectuurkeuzes en strikt beheer.
Wat is het geïntegreerde model voor de lagen van AI-automatisering?
Het geïntegreerde model voor de lagen van AI-automatisering beschrijft een groeipad dat onafhankelijk is van leveranciers. Het brengt de versnipperde architecturen met 3, 5 en 6 lagen samen in één helder traject voor operationele teams. We koppelen de automatiseringsstack met 5 lagen aan de agentstack met 6 lagen.
Zo beschrijven we de ontwikkeling van AI, van databasis tot autonome bedrijfsvoering, en zorgen we dat technische uitvoering en de ontwikkeling van het redeneervermogen gelijk opgaan. Beide teams moeten op één lijn zitten.
De automatiseringsstack met 5 lagen bestaat uit dataverzameling, pipeline-orkestratie, beslislogica, intelligente acties en autonome agents. We koppelen deze operationele onderdelen aan het model van de agentstack met 6 lagen, dat de ontwikkeling van AI van databasis tot autonome bedrijfsvoering beschrijft. Zo gaan technische uitvoering en de ontwikkeling van het redeneervermogen gelijk op.
Van oudsher werkten datateams met het model van 5 lagen, terwijl machinelearningteams systemen bouwden volgens het model van 6 lagen. Daardoor ontstond een grote communicatiekloof.
Datateams richtten zich op het verplaatsen van data, terwijl machinelearningteams zich bezighielden met redeneerlussen. Door beide modellen te combineren, laten we beide teams werken naar hetzelfde controlemoment: als het datateam niet kan aantonen dat de pipeline-orkestratie van het model met 5 lagen uitzonderingssituaties aankan, mag het machinelearningteam niet doorgaan met het uitvoeren van tools in het model met 6 lagen.
In laag 1 (databasis) staat data in afzonderlijke silo's, zonder een gezamenlijke manier waarop AI die data kan bevragen. Teams besteden weken aan maatwerkscripts om eenvoudige operationele vragen te beantwoorden. Voor de meeste bedrijven is deze handmatige aanpak het vertrekpunt.
De fout is denken dat een datawarehouse dit oplost. We zien bedrijven onbewerkte CSV-bestanden in Snowflake zetten en dat trots laag 1 noemen. Dat is een valkuil.
Als een AI-agent zelf SQL moet schrijven om ongestructureerde tekstvelden te doorzoeken en alleen al een klant-ID te vinden, zitten je gegevens nog steeds in silo's.
Een agent die handelt op basis van verouderde voorraadgegevens kan niet-beschikbare voorraad bestellen of een verkooppiek missen. Controleer hoe actueel de data moet zijn, hoe je omgaat met gebeurtenissen die later binnenkomen en hoe gegevens worden afgestemd voordat je het systeem bestellingen laat plaatsen.
In laag 3 (toollaag) kan AI data bevragen, maar geen acties uitvoeren in externe systemen. De AI kan dus advies geven, maar dat niet zelf uitvoeren. Hier lopen de meeste teams vast.
Laag 4 (geheugenlaag) geeft agents blijvende context tussen sessies. Daardoor kunnen ze leren van eerdere resultaten en bekende fouten vermijden. Ze onthouden gebruikersvoorkeuren en eerdere mislukkingen.
Deze laag gaat mis als gegevens tussen sessies doorlekken. Een agent kan bijvoorbeeld de kortingscode van een gebruiker onthouden en die per ongeluk toepassen in de sessie van een nieuwe gebruiker. Dat veroorzaakt een datalek.
Geheugenlagen vereisen daarom een strikt gescheiden naamruimte per gebruiker.
Laag 5 (orkestratielaag) laat meerdere gespecialiseerde agents samenwerken aan complexe taken. Ze kunnen achtereenvolgens, parallel of hiërarchisch werken. Dit is een architectuur met meerdere agents.
Teams proberen vaak laag 4 over te slaan en meteen naar laag 5 te gaan. Hun agents kunnen dan geen context bewaren tussen hun eigen opeenvolgende taken. Zo ontstaan orkestratielussen waarin agents elkaar steeds opnieuw vragen om data die ze al hebben opgehaald.
Je tokenkosten worden 10 keer zo hoog en je rendement verdwijnt.
Laag 6 (autonome bedrijfsvoering) houdt in dat AI-agents voortdurend data bewaken, gebeurtenissen herkennen, datasets analyseren en handelen zonder dat een mens het initiatief neemt. Dit is het einddoel.
Stap 1: bepaal bij welke laag van AI-automatisering je nu staat
Veel automatiseringsprojecten mislukken omdat teams basislagen overslaan of bij de verkeerde laag in de automatiseringsstack beginnen. Breng je uitgangssituatie in kaart voordat je agents toevoegt.
Wij gebruiken een strikte checklist om te bepalen waar een team staat. Zo voorkom je dat je een oplossing onnodig ingewikkeld maakt voordat de basis werkt. Loop deze punten langs om te zien of je klaar bent voor de volgende stap.
- Vertraging in de data: Controleer hoe lang het duurt om belangrijke operationele data samen te brengen. Kost dat uren? Dan zit je vast in laag 1.
- Opvraagbaarheid van data: Kijk of iemand eerst een vraag aan AI moet stellen om inzichten te krijgen. Als AI de database niet zelfstandig kan bevragen, zit je in laag 2.
- Rechten om acties uit te voeren: Controleer de rechten van je API's. Kan je AI data lezen, maar niet schrijven naar externe systemen? Dan heb je het plafond van laag 3 bereikt.
- Context tussen sessies: Test het sessiegeheugen. Als je agent eerdere interacties vergeet zodra een nieuwe sessie begint, ontbreken de mogelijkheden van laag 4 volledig.
Een pipeline kan prima lijken voor rapportages, maar alsnog tekortschieten wanneer software op basis van die data actie onderneemt. Test wijzigingen in het schema, ontbrekende velden, verouderde records, dubbele gebeurtenissen en fouten in gekoppelde API's voordat je schrijfacties toestaat.
Gebruik de onderstaande beoordeling om vast te stellen hoe ver je organisatie is.
Waarom geautomatiseerde beslissingen vastlopen op gebrekkige data
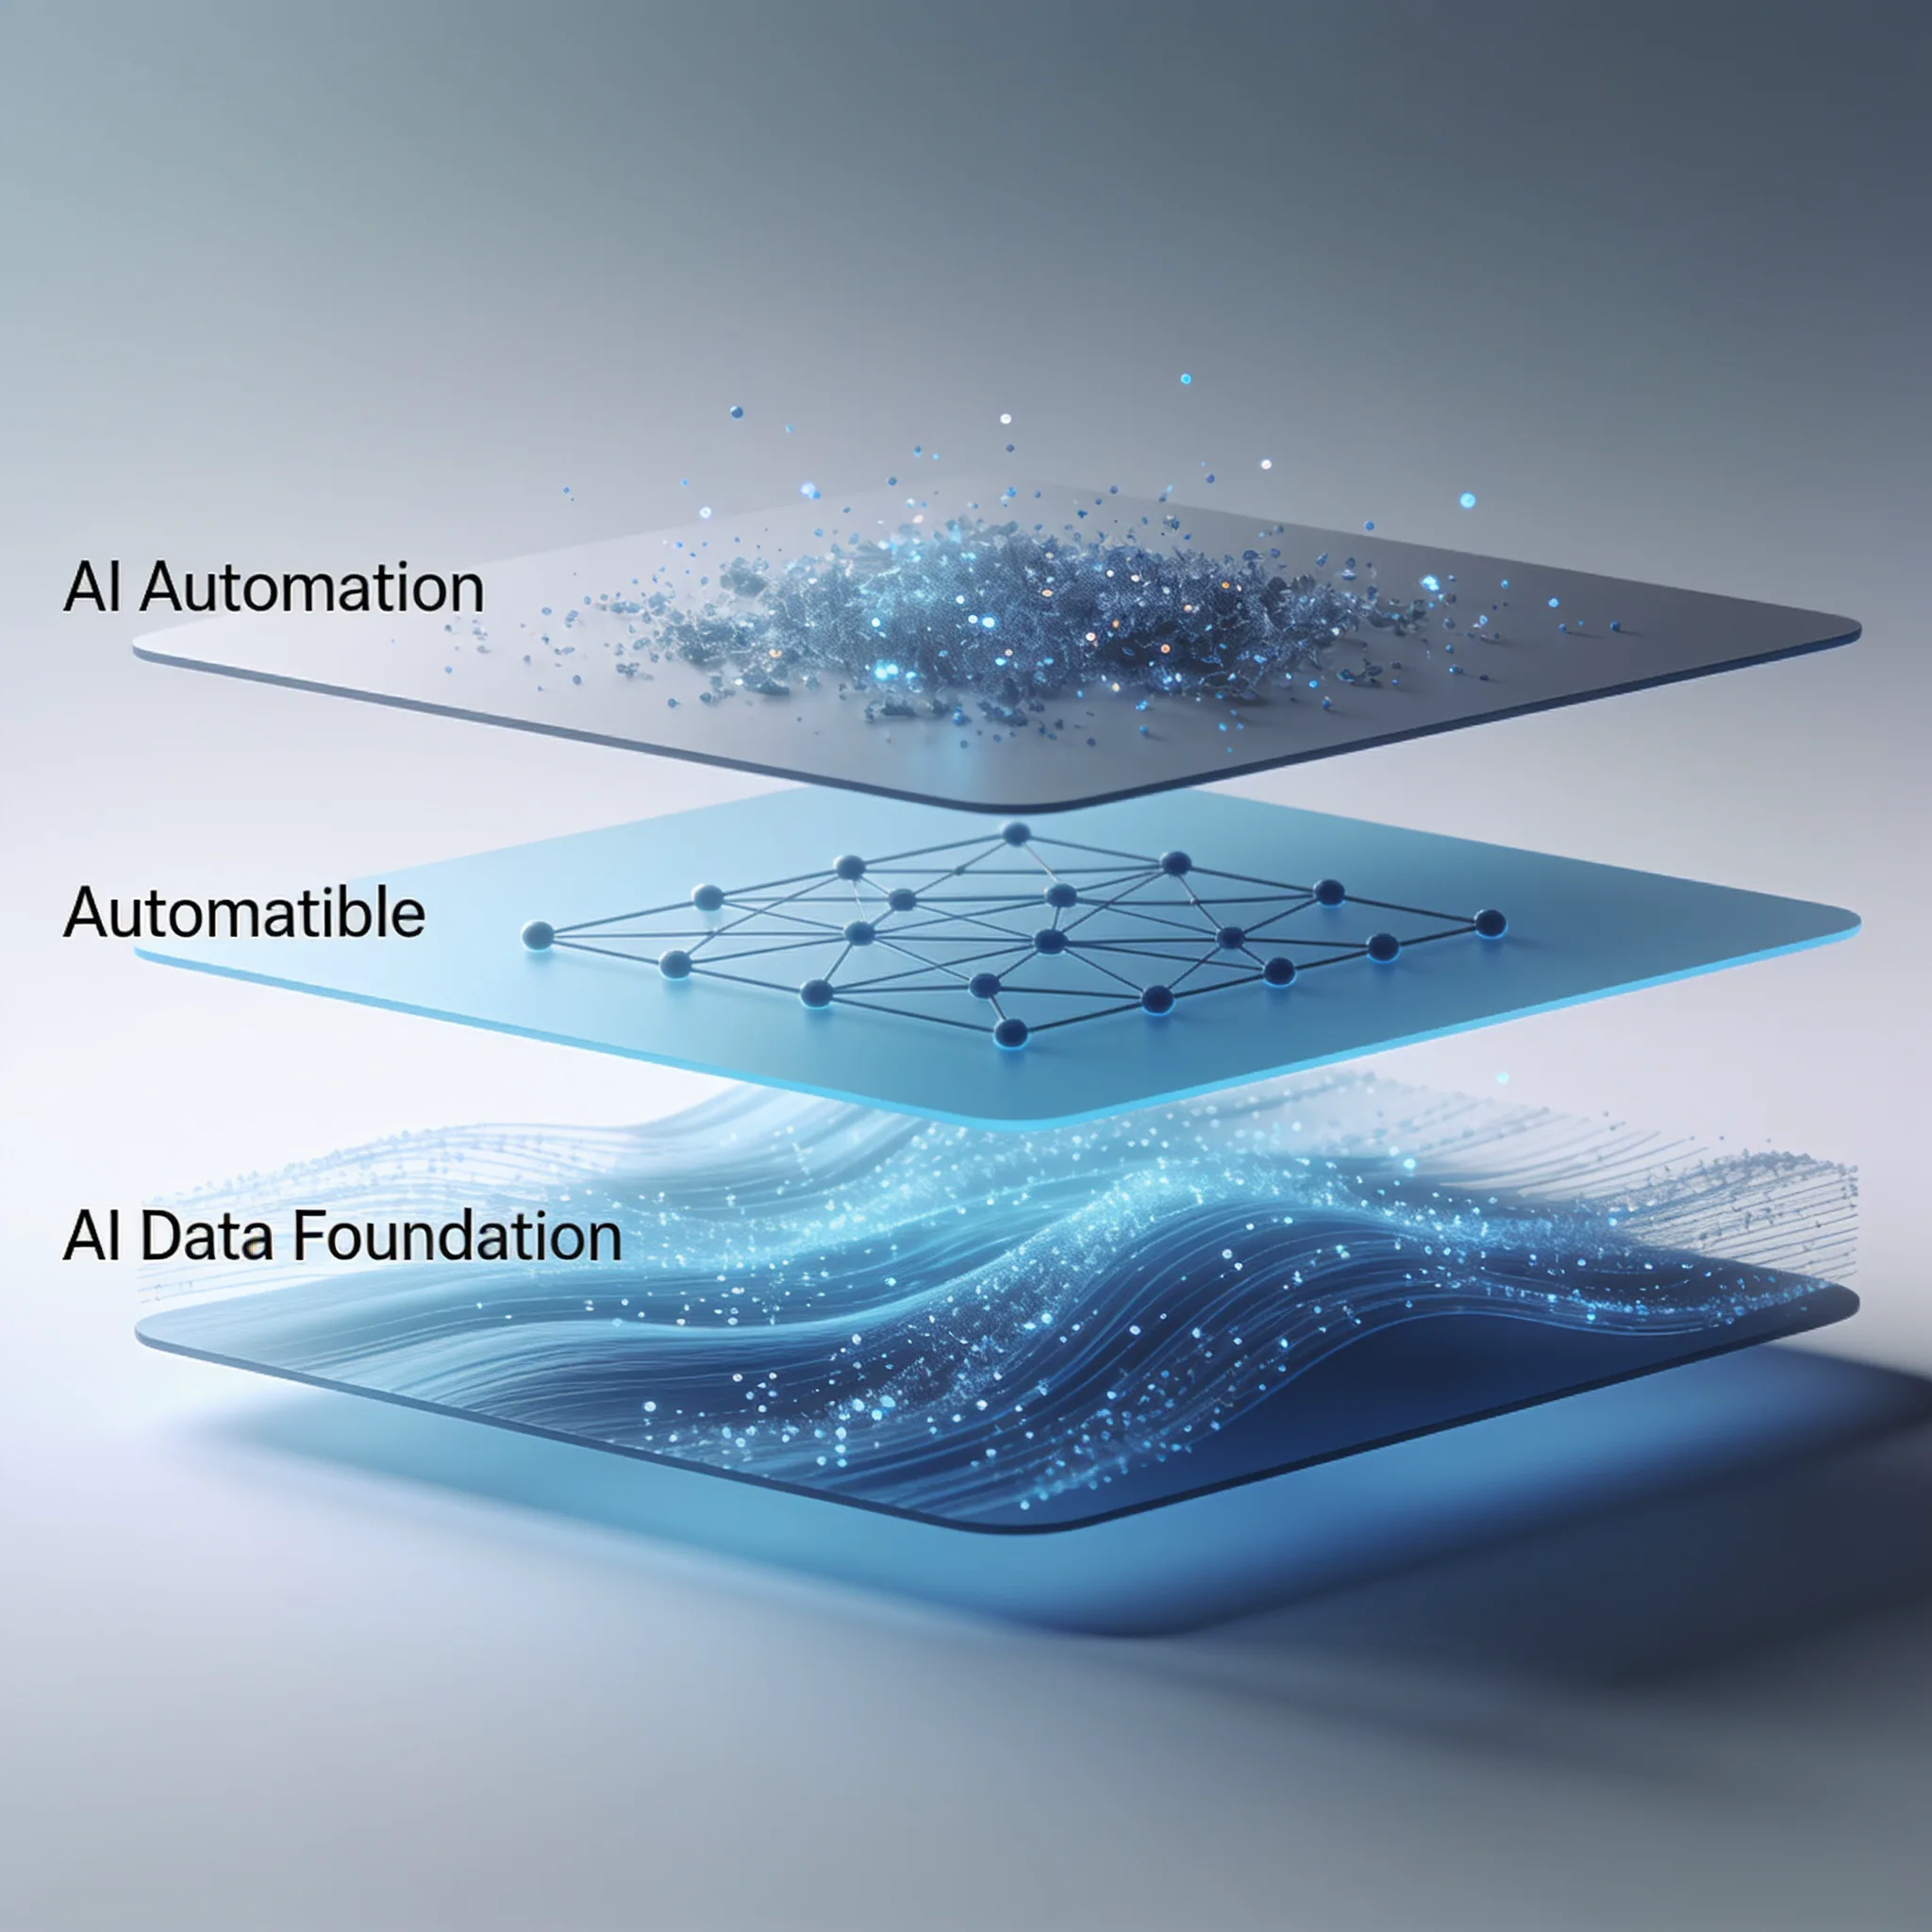
Teams lopen vast bij laag 3 wanneer ze geautomatiseerde beslislogica proberen te bouwen zonder eerst hun basisdata op te schonen. Een aanzienlijk deel van de teams strandt in deze fase omdat de datakwaliteit te laag is om AI betrouwbaar te laten redeneren. Gestructureerde data is daarmee de echte voorwaarde om verder te komen.
De meest voorkomende hindernis bij de overstap van laag 2 naar laag 3 in AI-automatisering is datakwaliteit, niet technologie. Dat zoveel teams hier vastlopen, legt een wijdverbreide misvatting bloot.
Teams kopen zakelijke automatiseringstools voordat ze hun datalakes opschonen. Ze gaan er ten onrechte van uit dat het AI-model rommelige dataschema's zelf wel begrijpt. Dat doet het niet.
AI kan niet betrouwbaar redeneren op basis van ongestructureerde rommel zonder enorm veel tokens te verbruiken en het risico op hallucinaties te vergroten. Wat op een beperking van AI lijkt, is in werkelijkheid een probleem met de data-architectuur.
| Ontwikkelingslaag | Wat gaat mis | Belangrijkste oorzaak | Aanpak |
|---|---|---|---|
| Laag 1 | Zoekopdrachten verlopen | Databases in silo's | Breng dataverzameling samen |
| Laag 2 | Irrelevante resultaten | Statische rapporten | Voeg vector-embeddings toe |
| Laag 3 | AI verzint acties | Ongestructureerde input | Stel kwaliteitseisen aan data vast |
| Laag 4 | Context gaat verloren | Geen opslag voor statusgegevens | Bouw een blijvend geheugen |
Als je AI vol overtuiging verkeerde acties uitvoert, heb je geen modelprobleem. Je hebt een dataprobleem. Verbeter de input voordat je de output gaat bijstellen.
Stap 2: ontwerp de technische stack voor verschillende leveranciersplatforms
De niveaus van een AI-automatiseringsstack kun je opdelen in triggers, gegevensinvoer, AI-verwerking en het routeren van uitvoer. Naarmate je deze niveaus doorloopt, heb je andere tools nodig.
Op niveau 1 gebruik je voor AI-automatisering meestal Claude Pro of ChatGPT Plus, met een gedeelde werkruimte zoals Teams. Dit niveau is geschikt voor eenvoudige conceptteksten en samenvattingen. Van een architectuur is hier nauwelijks sprake.
Je kopieert en plakt, waardoor contextverlies het grootste risico is. Een gebruiker plakt een lange conversatie in het taalmodel, maar de tool kapt de geschiedenis af. Het resultaat is een onvolledige samenvatting.
Niveau 2 draait om API-tools en automatiseringsplatforms zoals Make Business of Zapier Professional. Deze platforms koppelen je CRM aan je AI-model. Dit niveau kost ongeveer $150 tot $350 per maand.
Zapier lijkt hier de logische keuze, omdat het voor vrijwel alles een ingebouwde integratie heeft. De verborgen keerzijde is de pollingfrequentie. Bij standaardabonnementen controleert Zapier API's elke 15 minuten.
Als je klantgegevens veranderen, weet je AI-agent dat dus mogelijk 15 minuten lang niet. Daarmee haal je de responstijdeis van minder dan 5 minuten voor laag 1 niet. Gebruik triggers op basis van webhooks in plaats van polling om de context actueel te houden.
Op niveau 3 heb je voor gekoppelde processen met meerdere agents agentframeworks met meerdere stappen en zakelijke automatiseringstools zoals n8n nodig. Daarmee kun je vertakkende logica en complexe routering afhandelen. Voor n8n heb je zelfhosting of een zakelijk cloudabonnement nodig.
Daardoor verschuiven je kosten van softwarelicenties naar de tijd van DevOps-engineers. Het risico is dat je ervan uitgaat dat je reguliere IT-team een zelfgehoste n8n-instantie kan beheren zonder aparte infrastructuurmonitoring voor je automatiseringsnodes. Zonder die monitoring kan een geheugenlek in één workflow je hele agentplatform platleggen.
Dit is een standaard JSON-payload die een webhook gebruikt om een automatisering op niveau 2 naar een AI-verwerkingsnode te routeren:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Wanneer de AI-verwerkingsnode deze payload ontvangt, gebruikt die de parameter `task` om een specifieke prompttemplate te kiezen. Als Stripe de structuur van zijn API-payload wijzigt en `amount_due` in een genest object plaatst, kan je AI-model een waarde verzinnen en een e-mail opstellen voor $0. Daarom schrijven we semantische versiebeheer voor prompttemplates voor, om regressies te voorkomen.
Wanneer je een prompt aanpast aan de nieuwe payloadstructuur van Stripe, verhoog je het versienummer.
Als de nieuwe prompt in productie verkeerde informatie verzint, kun je onmiddellijk teruggaan naar de vorige versie zonder de codebase aan te raken. Plaats de AI-verwerkingsnode ook achter een wachtrij zoals RabbitMQ. Als Sendgrid uitvalt, mag je webhook niet mislukken.
De wachtrij bewaart de payload en probeert het routeren van de uitvoer opnieuw totdat de externe API is hersteld.
Bereken met de onderstaande calculator de basiskosten voor een stack op niveau 3.
Kostencalculator voor AI-automatisering
Schat de maandelijkse kosten voor verschillende lagen van AI-automatisering.
Benieuwd wat AI voor je bedrijfsprocessen kan betekenen?
Opgeleverd binnen 3-5 werkdagen. Geen verplichtingen.
Stap 3: Regel beveiliging en governance voor autonome processen
In laag 3 (toollaag) kan AI gegevens opvragen, maar geen acties uitvoeren in externe systemen. De AI geeft dus advies zonder zelf te kunnen handelen. In laag 6 (autonome processen) houden AI-agents voortdurend gegevens in de gaten, signaleren ze gebeurtenissen, analyseren ze datasets en ondernemen ze actie zonder dat een mens het initiatief neemt.
De overstap van adviseren naar handelen brengt grote beveiligingsrisico's met zich mee. Daarom heb je governanceprotocollen nodig voor de acties die AI-agents in externe systemen uitvoeren.
De vergelijking met elektriciteit ligt voor de hand. Ook daarvoor heb je een geaarde groepenkast nodig. Je autonome agents hebben een vergelijkbare stroomonderbreker nodig.
Voor elke actie met financiële transacties of het verwijderen van gegevens vereisen we menselijke controle. Het systeem moet pauzeren en om bevestiging vragen.
Stel strikte limieten voor het aantal verzoeken en rolgebaseerd toegangsbeheer in voor de tokens van je agents. Een agent die terugbetalingen mag uitvoeren, hoort geen schrijfrechten voor je broncoderepository te hebben. Gebruik API-sleutels met beperkte rechten die elke 24 uur verlopen.
Een minder voor de hand liggend inzicht: waarom geheugen- en orkestratielagen weinig opleveren zonder schone data
De markt presenteert geavanceerde systemen met meerdere agents als de heilige graal van AI-automatisering. Wij zijn het daar absoluut niet mee eens. Investeren in laag 4 en laag 5 heeft geen enkele zin als laag 1 nog gebreken vertoont.
Laag 4 (geheugenlaag) geeft agents blijvende context tussen sessies, zodat ze van eerdere resultaten kunnen leren. Maar als de onderliggende gegevens niet kloppen, onthoudt de agent alleen fouten. Een systeem met meerdere agents dat op slechte data draait, vergroot fouten simpelweg sneller dan één agent ooit zou kunnen.
De grootste hindernis bij de overstap van laag 2 naar laag 3 in AI-automatisering is de kwaliteit van de data, niet de technologie. Dat geldt ook voor de volgende lagen. Slechte data ondermijnt elke laag erboven.
Je data-architectuur moet op orde zijn voordat je aan je AI-architectuur begint. Koop geen orkestratietools voordat je het schema van je CRM hebt verbeterd. Een eenvoudig script met schone data werkt altijd beter dan een systeem met meerdere agents dat op rommeldata draait.
Begin bij de basis als je een betere keten wilt bouwen.
AI-automatiseringslagen koppelen aan bedrijfsrendement en verandermanagement
De automatiseringsstack met 5 lagen bestaat uit gegevensvastlegging, pipeline-orkestratie, beslislogica, intelligente acties en autonome agents. Door deze technische lagen te koppelen aan bedrijfsresultaten, krijg je het management mee.
Alleen al die snelheid verkort de afhandeltijd van supportvragen aanzienlijk.
Gebruik vóór een pilot een hypothetische werklast voor de triage van supporttickets om de stack door te rekenen. Vul de eigen aantallen, afhandelingskosten, softwarekosten, het modelgebruik, de beoordelingstijd en de kosten van fouten van de organisatie in. Bereken het break-evenpunt op basis van waargenomen gegevens in plaats van het als resultaat bij een klant te presenteren.
Voor de meeste grote organisaties duurt de overgang van laag 1 naar laag 5 gemiddeld 14 maanden. Verwacht dus geen verandering van de ene op de andere dag. Maak een verandermanagementplan waarmee je team leert werken met de nieuwe automatiseringsstack.
Een triagepilot kan weerstand bij medewerkers oproepen als je succes alleen afmeet aan het aantal afgehandelde tickets. Bij een hypothetische uitrol kan het team meten hoeveel complexe problemen het oplost en hoe goed correcties zijn, terwijl het systeem de routinematige classificatie verzorgt. Vraag medewerkers naar hun ervaringen en publiceer de werkelijke uitkomst pas na de pilot.
Leg in een uitrolplan vast welke gevallen bij medewerkers blijven en welke vaardigheden zij nodig hebben voor validatie, het afhandelen van uitzonderingen en het beheer van het systeem. Registreer de trainingstijd en veranderingen in functies tijdens de daadwerkelijke uitrol in plaats van een uitkomst voor de personeelsbezetting te verzinnen.
Sla je deze stap in het verandermanagement over, dan zal je team de databasis actief ondermijnen. Medewerkers voeren dan ongestructureerde notities in in plaats van keuzelijsten te gebruiken. Ze omzeilen het CRM en houden deals bij in spreadsheets.
Een systeem met meerdere agents dat op die ondermijnde data draait, zal onmiddellijk falen. Zo werken AI-automatiseringslagen in de praktijk.
Stop met gissen. Ga aan de slag met een duidelijke routekaart.
Snelle oplevering. Meetbare resultaten. Beveiliging voorop.
Veelgestelde vragen
