Warstwy automatyzacji AI prowadzą od uporządkowanego fundamentu danych do autonomicznych operacji reagujących na zdarzenia. Każda warstwa działa tylko wtedy, gdy działa ta pod nią. Większość zespołów zatrzymuje się na warstwie 3, gdzie AI zaczyna wykonywać działania zamiast tylko doradzać. Przyczyną niemal zawsze jest jakość danych, a nie możliwości modelu.
- Branży brakuje wspólnego standardu, ale połączenie modeli 3, 5 i 6 warstw pokazuje jasną drogę od fundamentu danych do autonomicznych operacji.
- 80% zespołów zatrzymuje się na warstwie 3 (logika decyzyjna) z powodu nieuporządkowanych danych z warstw 1 i 2. To pokazuje, że jakość danych jest większą barierą niż technologia.
- Przejście od poziomu 1, czyli pojedynczych narzędzi ($45-$120/mies.), do poziomu 3, czyli operacji opartych na wielu agentach ($400-$800/mies.), wymaga przemyślanych zmian architektury i ścisłego nadzoru.
Czym są ujednolicone ramy warstw automatyzacji AI?
Ujednolicone ramy warstw automatyzacji AI to niezależny od dostawcy model rozwoju. Łączy rozproszone architektury 3, 5 i 6 warstw w jedną, wyjątkowo czytelną ścieżkę dla osób zarządzających operacjami. Łączymy 5-warstwową architekturę automatyzacji z 6-warstwową architekturą agentów, aby opisać dojrzałość AI od fundamentu danych po autonomiczne operacje.
Dzięki temu wdrożenie techniczne i zdolność systemu do rozumowania rozwijają się równolegle. Oba zespoły muszą działać w zgodzie.
5-warstwowa architektura automatyzacji obejmuje pozyskiwanie danych, orkiestrację potoków, logikę decyzyjną, inteligentne działania i autonomicznych agentów. Łączymy te elementy operacyjne z modelem 6-warstwowej architektury agentów, który opisuje dojrzałość AI od fundamentu danych po autonomiczne operacje. Dzięki temu wdrożenie techniczne i zdolność systemu do rozumowania rozwijają się równolegle.
Dawniej zespoły inżynierii danych pracowały według modelu 5 warstw, a zespoły uczenia maszynowego budowały systemy według modelu 6 warstw. Powstała między nimi poważna luka komunikacyjna.
Zespoły danych skupiały się na przesyłaniu danych, a zespoły ML na pętlach rozumowania. Połączenie obu modeli daje im wspólny warunek przejścia do kolejnego etapu: jeśli zespół danych nie potrafi wykazać, że orkiestracja potoków w modelu 5 warstw obsługuje przypadki brzegowe, zespół ML nie może przejść do wykonywania działań przez narzędzia w modelu 6 warstw.
Warstwa 1 (fundament danych) to etap, na którym dane znajdują się w odizolowanych systemach, bez wspólnej warstwy zapytań dla AI. Zespoły tygodniami piszą własne skrypty, by odpowiedzieć na podstawowe pytania operacyjne. Dla większości przedsiębiorstw to punkt wyjścia.
Błędem jest założenie, że hurtownia danych rozwiązuje problem. Widzimy firmy, które wrzucają surowe pliki CSV do Snowflake i z dumą ogłaszają, że osiągnęły warstwę 1. To pułapka.
Jeśli agent AI musi pisać własne zapytania SQL do parsowania nieuporządkowanych pól tekstowych tylko po to, by znaleźć identyfikator klienta, dane nadal są odizolowane.
Agent działający na podstawie nieaktualnych danych magazynowych może zamówić niedostępny towar albo przeoczyć nagły wzrost sprzedaży. Zanim pozwolisz systemowi składać zamówienia, sprawdź wymagania dotyczące aktualności danych, zdarzenia docierające z opóźnieniem i uzgadnianie danych.
Warstwa 3 (warstwa narzędzi) obejmuje AI, które potrafi odpytywać dane, ale nie może działać w systemach zewnętrznych. Może więc doradzać, lecz nie wykonywać zadań. To tutaj większość zespołów napotyka barierę.
Warstwa 4 (warstwa pamięci) daje agentom trwały kontekst między sesjami. Mogą wyciągać wnioski z wcześniejszych rezultatów i nie powtarzać znanych błędów. Pamiętają preferencje użytkowników i poprzednie niepowodzenia.
Problemem, który może zdyskwalifikować tę warstwę, jest przenikanie stanu między użytkownikami. Występuje wtedy, gdy agent zapamiętuje kod rabatowy konkretnej osoby i przypadkowo stosuje go w sesji innej osoby, powodując wyciek danych. Warstwy pamięci wymagają ścisłego oddzielenia przestrzeni nazw dla każdego użytkownika.
Warstwa 5 (warstwa orkiestracji) pozwala wielu wyspecjalizowanym agentom wspólnie realizować złożone zadania, kolejno, równolegle lub hierarchicznie. To architektura wieloagentowa. Zespoły często próbują pominąć warstwę 4 i od razu przejść do warstwy 5.
Wtedy ich agenci nie potrafią zachować stanu między kolejnymi zadaniami. Powstają pętle orkiestracji, w których agenci wciąż pytają się nawzajem o już pobrane dane. Koszty tokenów rosną 10-krotnie, a opłacalność inwestycji znika.
Warstwa 6 (autonomiczne operacje) oznacza, że agenci AI stale monitorują dane, wykrywają zdarzenia, analizują zbiory danych i podejmują działania bez inicjatywy człowieka. To cel końcowy.
Krok 1: Ustal, na której warstwie automatyzacji AI jesteś
Większość projektów automatyzacji kończy się niepowodzeniem, bo zespoły pomijają warstwy podstawowe lub zaczynają od niewłaściwego miejsca w architekturze. Zanim dodasz agentów, ustal punkt wyjścia.
Stosujemy ścisłą listę kontrolną do samooceny. Pozwala określić punkt wyjścia i uniknąć nadmiernego komplikowania rozwiązania, zanim zaczną działać podstawy. Sprawdź swoją gotowość według poniższych punktów.
- Opóźnienie danych: Sprawdź, ile trwa zebranie podstawowych danych operacyjnych. Jeśli zajmuje to godziny, utknęliście na warstwie 1.
- Sposób zadawania pytań danym: Sprawdź, czy uzyskanie wniosków z danych wymaga promptu wpisanego przez człowieka. Jeśli AI nie potrafi samodzielnie odpytywać bazy danych, jesteście na warstwie 2.
- Uprawnienia do działania: Sprawdź zakresy dostępu API. Jeśli AI może odczytywać dane, ale nie ma uprawnień do zapisu w systemach zewnętrznych, na pewno dotarliście do granicy warstwy 3.
- Trwałość kontekstu: Przetestuj pamięć między sesjami. Jeśli agent zapomina wcześniejsze interakcje po rozpoczęciu nowej sesji, nie macie jeszcze możliwości warstwy 4.
Potok danych wystarczający do raportowania może zawieść, gdy oprogramowanie zacznie działać na podstawie tych danych. Zanim włączysz zapis, przetestuj zmiany schematu, brakujące pola, nieaktualne rekordy, zduplikowane zdarzenia i błędy interfejsów API dalszych systemów.
Skorzystaj z poniższej oceny, aby ustalić poziom dojrzałości swojej organizacji.
Dlaczego automatyzacja decyzji zatrzymuje się na danych słabej jakości
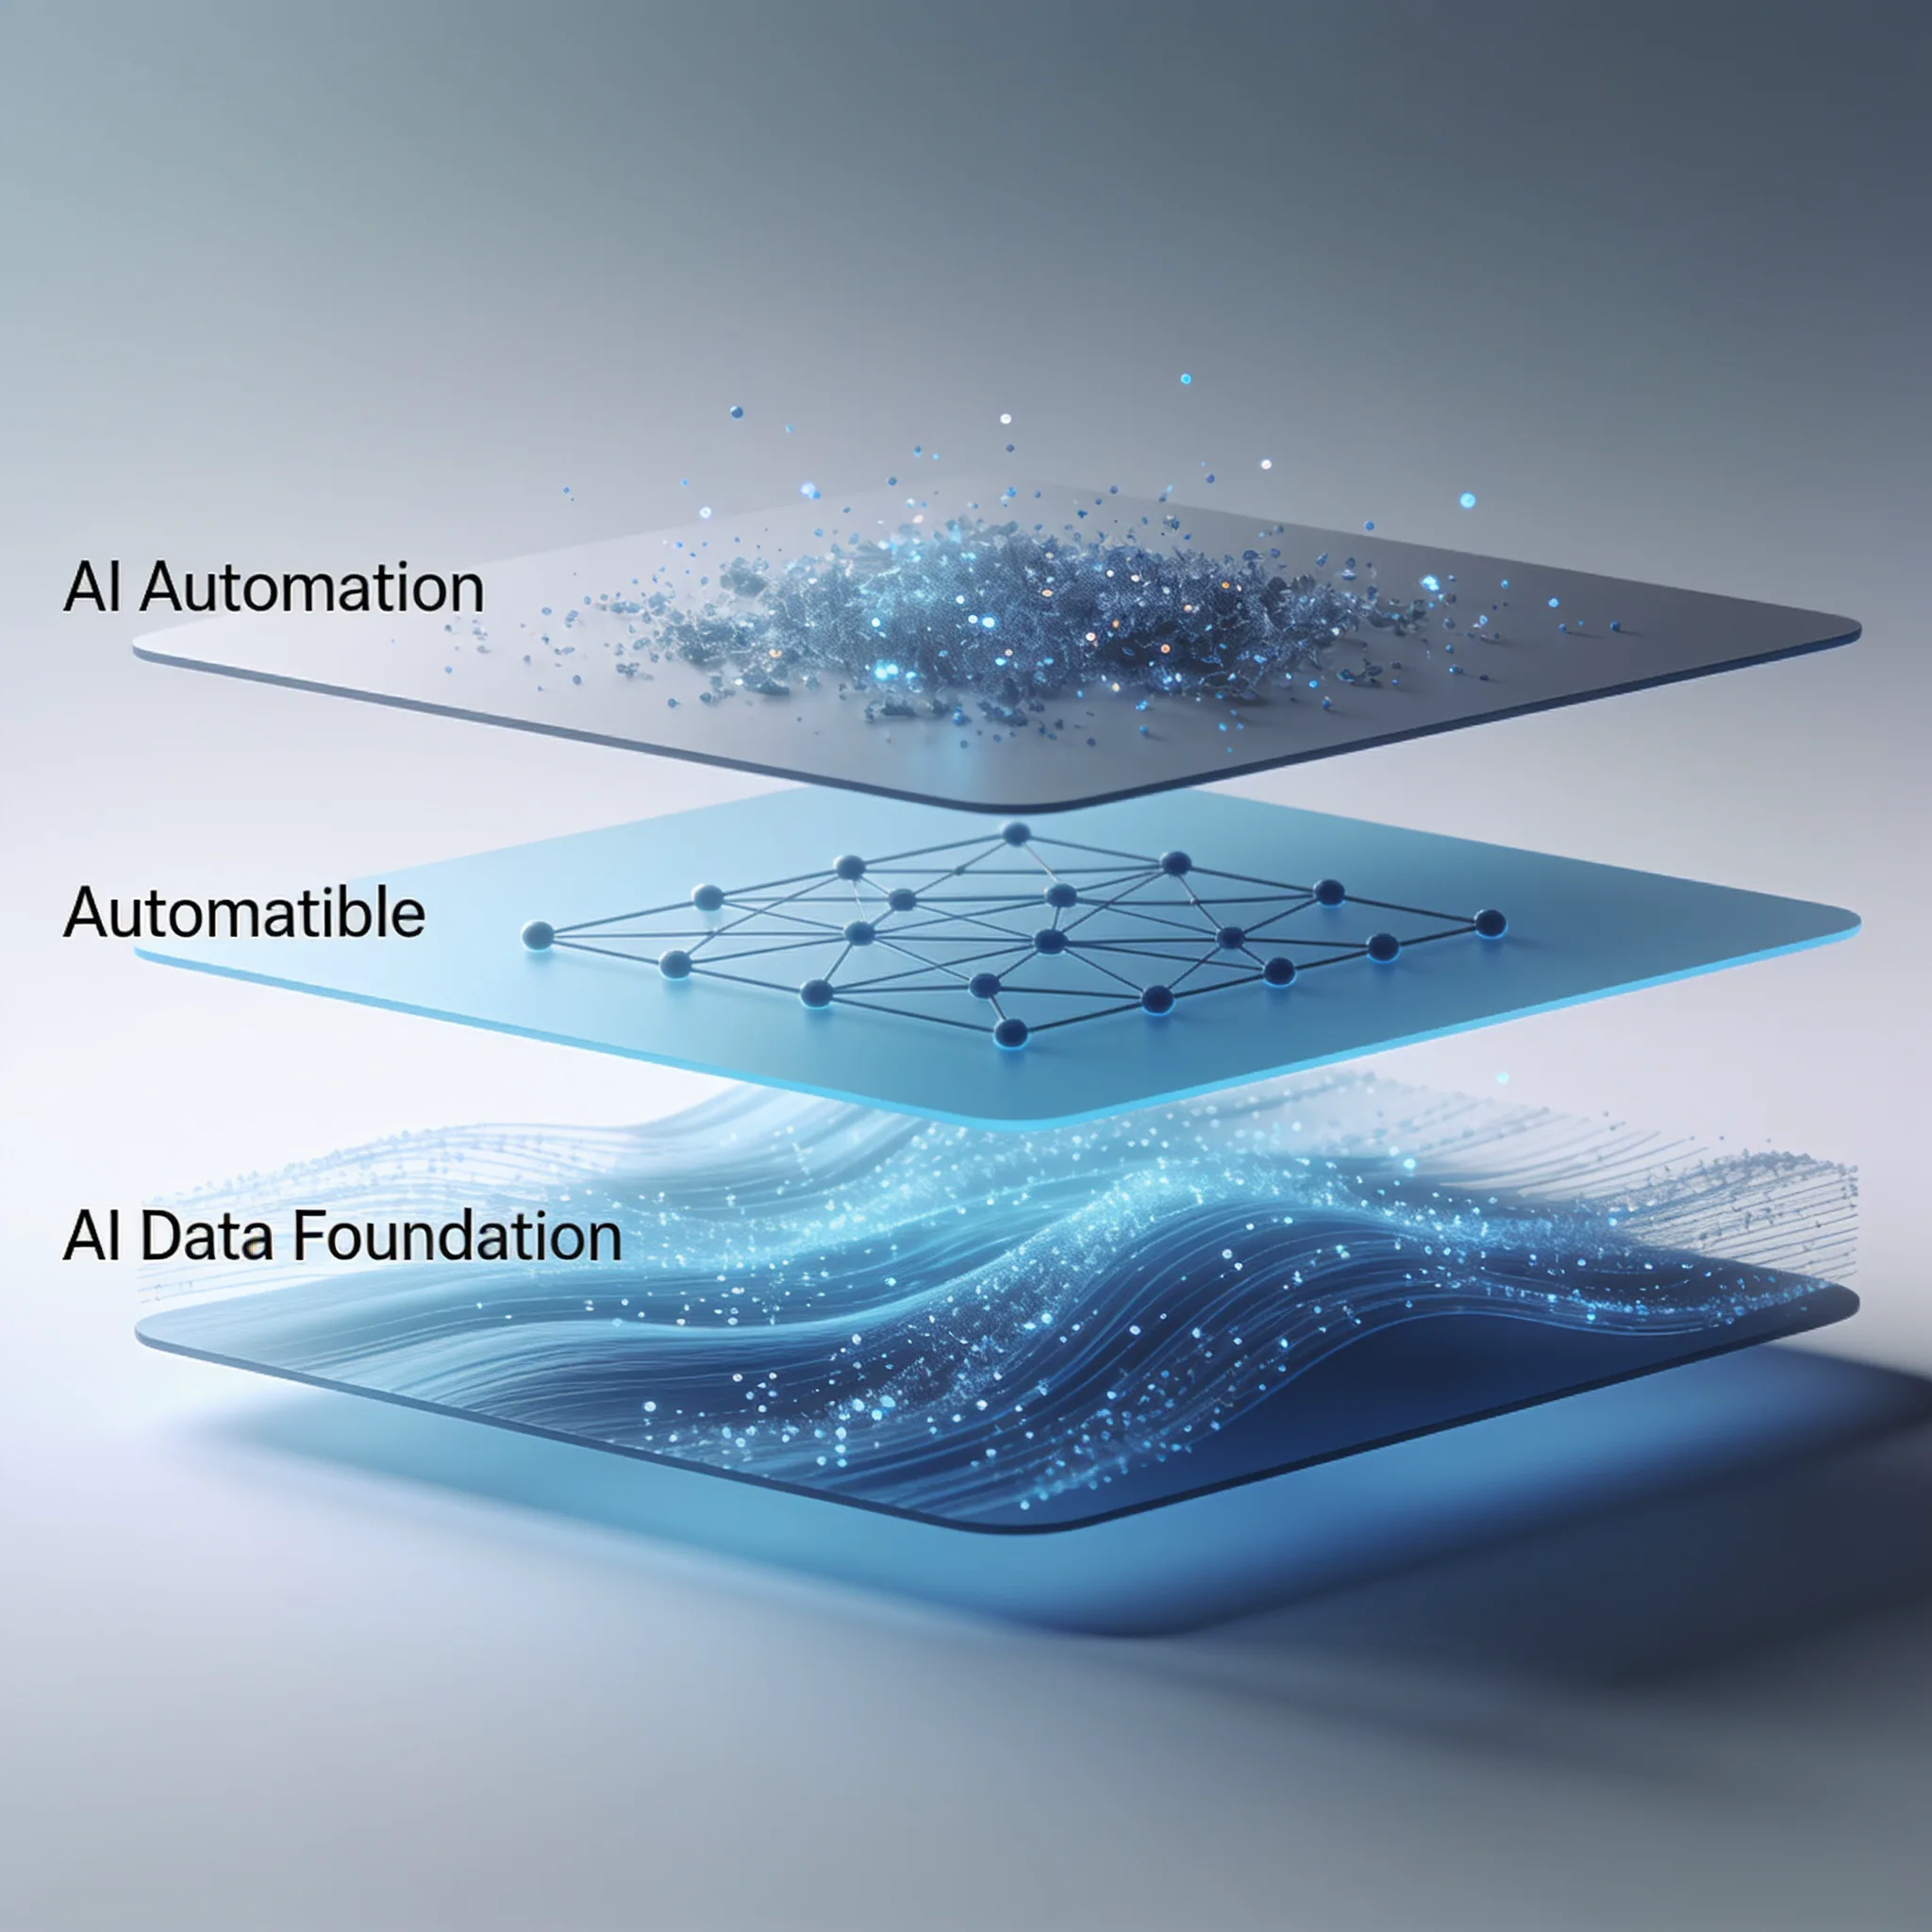
Zastój na warstwie 3 pojawia się, gdy zespoły próbują zbudować automatyczną logikę decyzyjną, zanim uporządkują dane stanowiące jej podstawę. Znaczna część zespołów nie przechodzi tego etapu, ponieważ jakość ich danych jest zbyt niska, by AI mogło na ich podstawie wiarygodnie wnioskować. Prawdziwą barierą okazują się więc uporządkowane dane.
Najczęstszą przeszkodą w przejściu z warstwy 2 do warstwy 3 automatyzacji AI jest jakość danych, a nie technologia. Skala niepowodzeń obnaża powszechne złudzenie.
Zespoły kupują firmowe narzędzia do automatyzacji, zanim uporządkują swoje jeziora danych. Błędnie zakładają, że model AI sam poradzi sobie z chaotycznymi schematami. Nie poradzi sobie.
AI nie może wiarygodnie wnioskować na podstawie nieuporządkowanych danych bez ogromnego zużycia tokenów i ryzyka halucynacji. Zastój na warstwie 3 to w rzeczywistości problem architektury danych, który wygląda jak ograniczenie AI.
| Warstwa dojrzałości | Rodzaj awarii | Główna przyczyna | Sposób rozwiązania |
|---|---|---|---|
| Warstwa 1 | Przekroczenie czasu zapytania | Odizolowane bazy danych | Scentralizowanie pozyskiwania danych |
| Warstwa 2 | Nieprzydatne wyniki | Statyczne raporty | Dodanie embeddingów wektorowych |
| Warstwa 3 | Działania oparte na halucynacjach | Nieuporządkowane dane wejściowe | Egzekwowanie SLA jakości danych |
| Warstwa 4 | Utrata kontekstu | Brak mechanizmów przechowywania stanu | Zbudowanie trwałej pamięci |
Jeśli Twoje AI podejmuje działania z przekonaniem, ale błędnie, problemem nie jest model, tylko dane. Popraw dane wejściowe, zanim zaczniesz dostrajać wyniki.
Krok 2: Zaprojektuj architekturę techniczną dla różnych ekosystemów dostawców
Stos automatyzacji AI można podzielić na cztery elementy: wyzwalacz, dane wejściowe, przetwarzanie przez AI i kierowanie wyników. W miarę rozwoju każdego z nich potrzebujesz innych narzędzi.
Na poziomie 1 automatyzacja AI zwykle opiera się na Claude Pro lub ChatGPT Plus oraz współdzielonej przestrzeni roboczej, takiej jak Teams. Ten poziom służy do tworzenia prostych wersji roboczych i podsumowań. Nie ma tu właściwie żadnej architektury.
Wszystko opiera się na kopiowaniu i wklejaniu, więc głównym zagrożeniem jest utrata kontekstu. Użytkownik wkleja długi wątek do modelu językowego, ale narzędzie ucina historię, przez co podsumowanie jest niepełne.
Poziom 2 obejmuje narzędzia API i platformy automatyzacji, takie jak Make Business czy Zapier Professional. Łączą one CRM z modelem AI. Ten poziom kosztuje około $150 do $350 miesięcznie.
Zapier wydaje się oczywistym wyborem, bo oferuje natywne integracje niemal ze wszystkim. Kryje się za tym jednak ograniczenie związane z cyklicznym odpytywaniem API. W standardowych planach Zapier sprawdza je co 15 minut.
Jeśli dane klienta się zmienią, agent AI może nie dowiedzieć się o tym przez 15 minut, co narusza wymóg czasu reakcji poniżej 5 minut dla warstwy 1. Aby zachować aktualny kontekst, zamiast cyklicznego odpytywania używaj wyzwalaczy opartych na webhookach.
Poziom 3, czyli połączone operacje wielu agentów, wymaga wieloetapowych frameworków agentowych i narzędzi do automatyzacji klasy enterprise, takich jak n8n. Pozwala obsługiwać rozgałęzioną logikę i złożone kierowanie zadań. n8n wymaga samodzielnego hostingu albo planu chmurowego dla przedsiębiorstw.
Koszt przenosi się więc z licencji na czas pracy inżynierów DevOps. Problem pojawia się, gdy zakładasz, że standardowy zespół IT utrzyma samodzielnie hostowaną instancję n8n bez monitorowania infrastruktury węzłów automatyzacji. W przeciwnym razie wyciek pamięci w jednym procesie może unieruchomić całą platformę agentów.
Oto standardowy ładunek webhooka w formacie JSON, który na poziomie 2 kieruje dane do węzła przetwarzania AI:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Po otrzymaniu tego ładunku węzeł przetwarzania AI wybiera odpowiedni szablon promptu na podstawie parametru `task`. Jeśli Stripe zmieni strukturę danych zwracanych przez API i umieści `amount_due` w zagnieżdżonym obiekcie, model AI może zmyślić tę wartość i przygotować e-mail dotyczący kwoty $0. Aby zapobiec regresjom, wymagamy semantycznego wersjonowania szablonów promptów.
Gdy aktualizujesz prompt do nowej struktury danych Stripe, zwiększasz numer wersji.
Jeśli nowy prompt zacznie generować nieprawdziwe informacje na produkcji, możesz natychmiast przywrócić poprzednią wersję bez zmian w kodzie. Węzeł przetwarzania AI umieść też za kolejką, na przykład RabbitMQ. Awaria Sendgrid nie powinna powodować błędu webhooka.
Kolejka przechowuje ładunek i ponawia próbę przekazania wyniku, aż zewnętrzne API znów będzie dostępne.
Oblicz podstawowe koszty budowy stosu poziomu 3 za pomocą poniższego kalkulatora.
Kalkulator kosztów automatyzacji AI
Oszacuj miesięczne koszty na różnych poziomach automatyzacji AI.
Chcesz sprawdzić, co AI może zrobić w twojej firmie?
Realizacja w 3-5 dni roboczych. Bez zobowiązań.
Krok 3: Zadbaj o bezpieczeństwo i nadzór nad autonomicznymi operacjami
Na warstwie 3 (warstwa narzędzi) AI może odpytywać dane, ale nie może wykonywać działań w systemach zewnętrznych. Służy więc do doradzania, a nie działania. Na warstwie 6 (operacje autonomiczne) agenci AI stale monitorują dane, wykrywają zdarzenia, analizują zbiory danych i podejmują działania bez inicjatywy człowieka.
Przejście od doradzania do działania niesie poważne zagrożenia dla bezpieczeństwa. Gdy agenci AI wykonują działania w systemach zewnętrznych, musisz wdrożyć zasady nadzoru.
Często porównuje się to do instalacji elektrycznej. Ona również potrzebuje uziemionej rozdzielnicy z bezpiecznikami. Twoi autonomiczni agenci potrzebują podobnego mechanizmu odcinającego.
Wymagamy zatwierdzenia przez człowieka każdego działania związanego z transakcjami finansowymi lub usuwaniem danych. System musi się zatrzymać i uzyskać potwierdzenie.
Ustaw ścisłe limity liczby żądań i kontrolę dostępu opartą na rolach dla tokenów agentów. Agent, który może zwracać płatności, nie powinien mieć uprawnień do zapisu w repozytorium kodu źródłowego. Używaj kluczy API z ograniczonym zakresem uprawnień, które wygasają co 24 godziny.
Mniej oczywisty wniosek: bez uporządkowanych danych warstwy pamięci i orkiestracji są przeceniane
Rynek przedstawia zaawansowane systemy wielu agentów jako szczyt możliwości automatyzacji AI. Zdecydowanie się z tym nie zgadzamy. Inwestowanie w warstwy 4 i 5 nie ma sensu, jeśli warstwa 1 nadal ma wady.
Warstwa 4 (warstwa pamięci) zapewnia agentom trwały kontekst między sesjami, dzięki czemu mogą uczyć się na podstawie wcześniejszych wyników. Jeśli jednak dane źródłowe są błędne, agent jedynie utrwala błędy. System wielu agentów oparty na złych danych skaluje porażki szybciej niż pojedynczy agent.
Najczęstszą przeszkodą przy przechodzeniu z warstwy 2 na warstwę 3 automatyzacji AI jest jakość danych, nie technologia. Problem dotyka też kolejnych warstw. Złe dane szkodzą każdej warstwie powyżej.
Najpierw zaprojektuj architekturę danych, potem architekturę AI. Zanim kupisz narzędzia do orkiestracji, uporządkuj strukturę danych w CRM. Prosty skrypt działający na czystych danych zawsze sprawdzi się lepiej niż system wielu agentów zasilany danymi niskiej jakości. Zacznij od solidnych podstaw.
Jak powiązać warstwy automatyzacji AI ze zwrotem z inwestycji i zarządzaniem zmianą
Pięciowarstwowy stos automatyzacji obejmuje gromadzenie danych, orkiestrację procesów, logikę decyzyjną, inteligentne działania i autonomicznych agentów. Powiązanie tych warstw technicznych z wynikami biznesowymi pomaga uzyskać poparcie kierownictwa.
Już sama szybkość działania znacznie skraca czas rozwiązywania zgłoszeń klientów.
Przed pilotażem użyj hipotetycznego procesu klasyfikowania zgłoszeń, aby zamodelować cały stos. Wprowadź rzeczywistą liczbę zgłoszeń w organizacji, koszt ich obsługi, opłaty za oprogramowanie, wykorzystanie modelu, czas weryfikacji i koszt błędów. Próg rentowności oblicz na podstawie zaobserwowanych danych, zamiast przedstawiać go jako wynik osiągnięty u klienta.
W większości przedsiębiorstw przejście od warstwy 1 do warstwy 5 zajmuje średnio 14 miesięcy. Nie oczekuj zmiany z dnia na dzień. Przygotuj plan zarządzania zmianą, który obejmie przeszkolenie zespołu w korzystaniu z nowego stosu automatyzacji.
Pilotaż klasyfikacji zgłoszeń może wywołać opór pracowników, jeśli sukces będzie mierzony wyłącznie liczbą obsłużonych zgłoszeń. W hipotetycznym wdrożeniu zespół mógłby mierzyć liczbę rozwiązanych złożonych problemów i jakość korekt, podczas gdy system zajmowałby się rutynową klasyfikacją. Zapytaj pracowników o opinię i opublikuj rzeczywiste wyniki dopiero po pilotażu.
Plan wdrożenia powinien wskazywać, które sprawy nadal obsługują pracownicy oraz jakich umiejętności potrzebują do weryfikacji, obsługi wyjątków i nadzorowania systemu. Czas szkolenia i zmiany ról dokumentuj na podstawie rzeczywistego wdrożenia, zamiast wymyślać wyniki dotyczące zatrudnienia.
Jeśli pominiesz zarządzanie zmianą, zespół może podważyć jakość danych, wpisując chaotyczne notatki zamiast korzystać z pól wyboru. Może też omijać CRM i prowadzić rejestr transakcji w arkuszach kalkulacyjnych. System wielu agentów oparty na tak zepsutych danych od razu zawiedzie.
Tak wyglądają warstwy automatyzacji AI w praktyce.
Przestań zgadywać. Zacznij działać według jasnego planu.
Szybka realizacja. Mierzalne wyniki. Bezpieczeństwo na pierwszym miejscu.
Najczęściej zadawane pytania
