Les couches de l’automatisation par l’IA vont de données de base fiables aux opérations autonomes déclenchées par des événements. Chacune dépend du bon fonctionnement de la couche précédente. La plupart des équipes restent bloquées à la couche 3, lorsque l’IA doit passer du conseil à l’action. La cause est presque toujours la qualité des données, et non les capacités du modèle.
- Le secteur manque de normes communes, mais réunir les modèles à 3, 5 et 6 couches fait apparaître une progression claire, des données de base aux opérations autonomes.
- 80 % des équipes restent bloquées à la couche 3 (logique décisionnelle) à cause de données non structurées provenant des couches 1 et 2. La qualité des données constitue donc un obstacle plus important que la technologie.
- Passer du niveau 1, avec des outils individuels ($45-$120/mois), au niveau 3, avec des opérations multi-agents ($400-$800/mois), exige des changements d’architecture réfléchis et une gouvernance stricte.
Qu’est-ce que le cadre unifié des couches de l’automatisation par l’IA ?
Le cadre unifié des couches de l’automatisation par l’IA est un modèle de progression indépendant des fournisseurs. Il rassemble les architectures dispersées à 3, 5 et 6 couches en un parcours clair pour les équipes opérationnelles. Nous faisons correspondre l’architecture d’automatisation à 5 couches à l’architecture des agents à 6 couches pour définir les étapes de maturité de l’IA, des données de base aux opérations autonomes.
L’exécution technique et les capacités de raisonnement doivent progresser ensemble. Les deux équipes doivent avancer de concert.
L’architecture d’automatisation à 5 couches comprend la collecte des données, l’orchestration des pipelines, la logique décisionnelle, les actions intelligentes et les agents autonomes. Nous faisons correspondre ces composants opérationnels au cadre de l’architecture des agents à 6 couches (qui définit les étapes de maturité de l’IA, des données de base aux opérations autonomes), afin que l’exécution technique et les capacités de raisonnement progressent ensemble. Historiquement, les équipes d’ingénierie des données travaillaient selon le modèle à 5 couches, tandis que les équipes de machine learning s’appuyaient sur celui à 6 couches.
Résultat : un profond décalage de communication.
Les équipes chargées des données se concentraient sur leur circulation, tandis que les équipes de machine learning se concentraient sur les boucles de raisonnement. En réunissant les deux modèles, nous imposons aux équipes un même jalon : si l’équipe chargée des données ne peut pas prouver que l’orchestration des pipelines du modèle à 5 couches gère les cas limites, l’équipe de machine learning ne peut pas passer à l’exécution des outils du modèle à 6 couches.
À la couche 1 (données de base), les données sont réparties dans des silos déconnectés, sans couche d’interrogation unifiée pour l’IA. Les équipes passent des semaines à écrire des scripts sur mesure pour répondre à des questions opérationnelles élémentaires. C’est le point de départ de la plupart des entreprises.
L’erreur consiste à croire qu’un entrepôt de données suffit. Nous voyons des entreprises déposer des fichiers CSV bruts dans Snowflake et annoncer fièrement qu’elles ont atteint la couche 1. C’est un piège.
Si un agent IA doit écrire du SQL sur mesure pour analyser des champs textuels non structurés et simplement trouver un identifiant client, vos données sont encore cloisonnées.
Un agent qui agit sur des données de stock obsolètes peut commander des produits indisponibles ou passer à côté d’un pic de ventes. Vérifiez les exigences de fraîcheur des données, la gestion des événements reçus tardivement et le rapprochement des données avant d’autoriser le système à passer commande.
À la couche 3 (couche des outils), l’IA peut interroger les données, mais pas agir dans des systèmes externes. Elle conseille, sans pouvoir exécuter. C’est là que la plupart des équipes se heurtent à un mur.
La couche 4 (mémoire) donne aux agents un contexte persistant d’une session à l’autre. Ils peuvent ainsi tirer les leçons des résultats passés et cesser de répéter des erreurs connues. Ils se souviennent des préférences des utilisateurs et des échecs précédents.
Le cas limite qui met cette couche en défaut est la contamination entre sessions : un agent mémorise le code de réduction d’un utilisateur, puis l’applique par erreur à la session d’un autre, provoquant une fuite de données. Les couches de mémoire exigent une isolation stricte des espaces de noms pour chaque utilisateur.
La couche 5 (orchestration) permet à plusieurs agents spécialisés de collaborer sur des tâches complexes, selon des schémas séquentiels, parallèles ou hiérarchiques. C’est l’architecture multi-agents. Les équipes essaient souvent de sauter la couche 4 pour passer directement à la couche 5.
Leurs agents ne peuvent alors pas conserver leur état entre leurs propres tâches successives. On obtient des boucles d’orchestration dans lesquelles les agents se redemandent sans cesse des données déjà récupérées, multipliant par 10 les coûts en tokens et réduisant à néant le retour sur investissement.
À la couche 6 (opérations autonomes), les agents IA surveillent les données en continu, détectent les événements, raisonnent à partir des jeux de données et agissent sans intervention humaine préalable. C’est l’objectif final.
Étape 1 : déterminer à quelle couche d’automatisation par l’IA vous vous situez
La plupart des projets d’automatisation échouent parce que les équipes sautent les couches fondamentales ou démarrent au mauvais niveau de l’architecture. Avant d’ajouter des agents, faites le point sur votre situation actuelle.
Nous utilisons une grille d’auto-évaluation rigoureuse pour déterminer le point de départ. Elle évite de concevoir une solution trop complexe avant même que les bases soient en place. Parcourez cette liste pour évaluer votre préparation.
- Latence des données : Vérifiez le temps nécessaire pour agréger les principales données opérationnelles. Cela prend-il des heures ? Vous êtes alors bloqué à la couche 1.
- Structure des requêtes : Vérifiez si une personne doit saisir une requête pour obtenir des informations de vos données. Si l’IA ne peut pas interroger la base de données de façon autonome, vous êtes à la couche 2.
- Autorisations d’action : Examinez les droits de vos API. Si votre IA peut lire les données, mais ne peut pas écrire dans des systèmes externes, vous avez atteint le plafond de la couche 3.
- Persistance du contexte : Testez la mémoire entre les sessions. Si votre agent oublie les interactions précédentes au début d’une nouvelle session, il ne dispose pas des capacités de la couche 4.
Un pipeline qui suffit pour produire des rapports peut échouer dès qu’un logiciel agit à partir de ses données. Testez les changements de schéma, les champs manquants, les enregistrements obsolètes, les événements en double et les erreurs des API en aval avant d’autoriser les écritures.
Utilisez l’évaluation ci-dessous pour établir votre niveau de maturité actuel.
Pourquoi l’automatisation des décisions se heurte à des données de mauvaise qualité
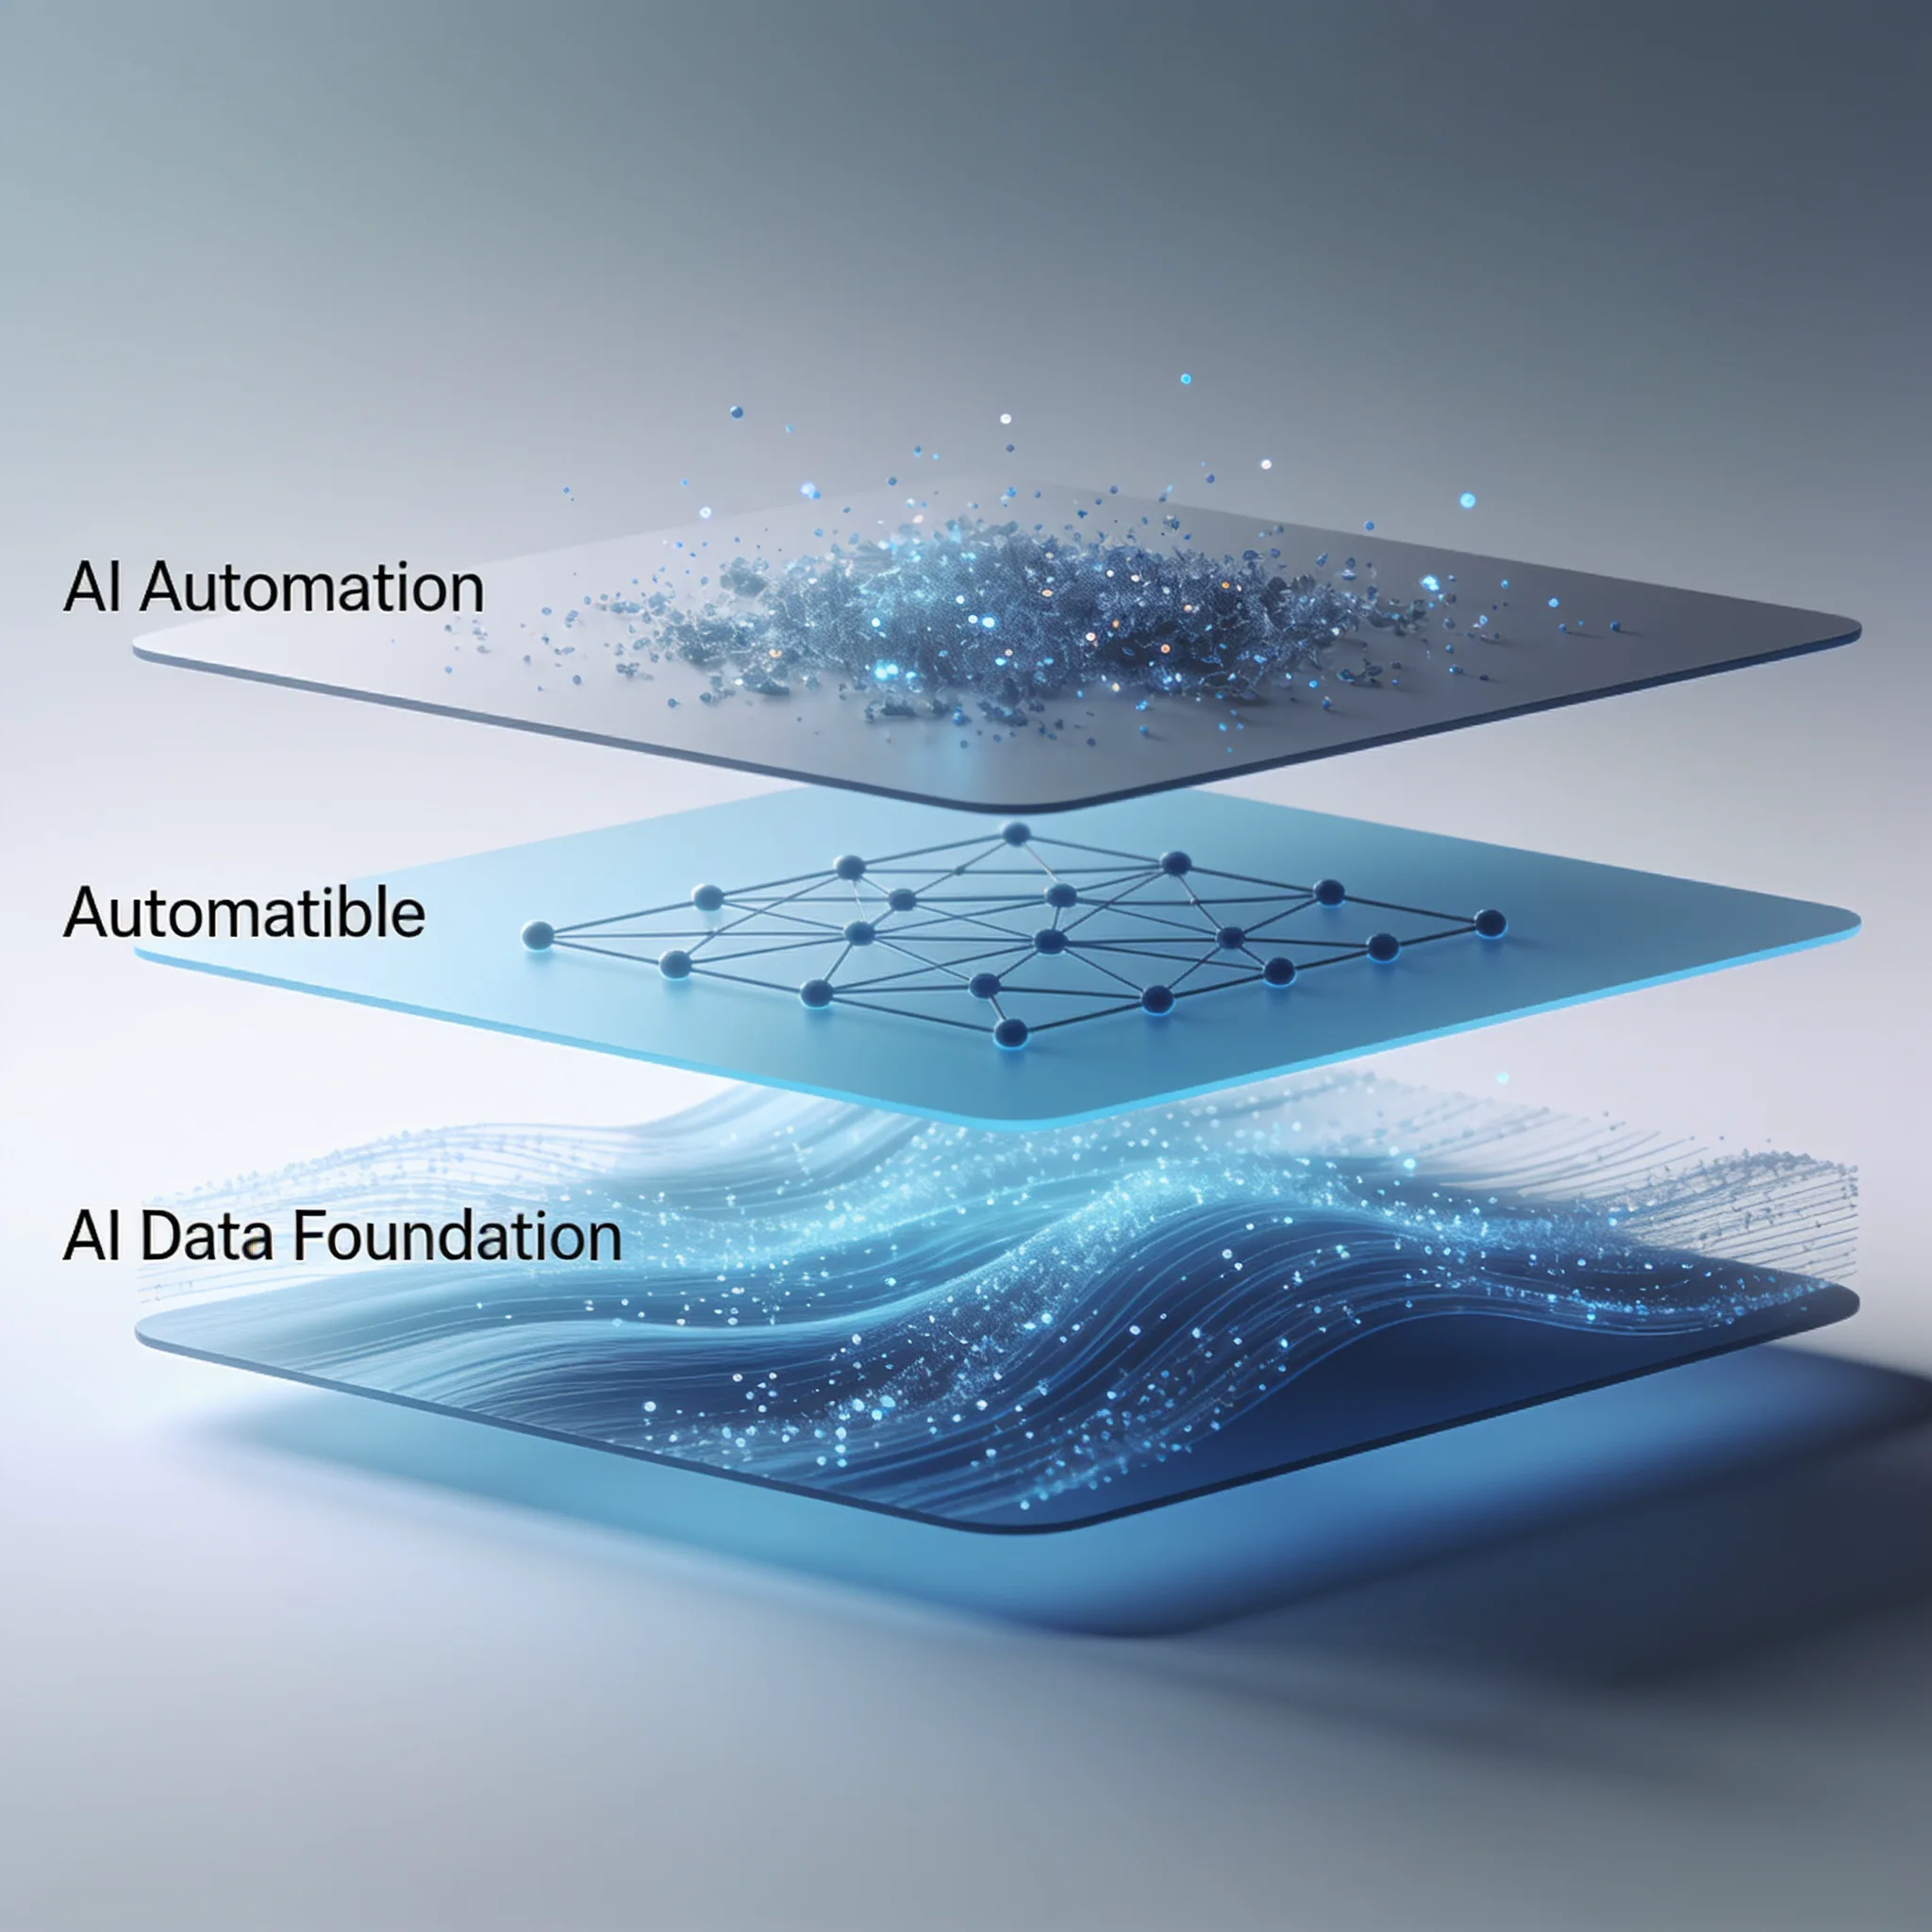
Le blocage à la couche 3 survient lorsque les équipes tentent de construire une logique décisionnelle automatisée sans avoir d’abord assaini leurs données de base. Une part importante des équipes échoue à ce stade parce que la qualité de leurs données ne permet pas à l’IA de raisonner de façon fiable. Ce sont donc les données structurées qui conditionnent réellement la progression.
Le principal obstacle au passage de la couche 2 à la couche 3 de l’automatisation par l’IA est la qualité des données, pas la technologie. Ce taux d’échec révèle une illusion répandue.
Les équipes achètent des outils d’automatisation destinés aux entreprises avant de nettoyer leurs lacs de données, en supposant à tort que le modèle d’IA saura se débrouiller avec des schémas incohérents. Ce n’est pas le cas. L’IA ne peut pas raisonner sur des données non structurées et inutilisables sans consommer énormément de tokens et risquer des hallucinations.
Le blocage à la couche 3 est en réalité un problème d’architecture des données qui se fait passer pour une limite de l’IA.
| Couche de maturité | Type d’échec | Cause principale | Solution |
|---|---|---|---|
| Couche 1 | Délais d’attente des requêtes dépassés | Bases de données cloisonnées | Centraliser la collecte des données |
| Couche 2 | Résultats non pertinents | Rapports statiques | Ajouter des représentations vectorielles |
| Couche 3 | Actions fondées sur des hallucinations | Données d’entrée non structurées | Imposer des SLA de qualité des données |
| Couche 4 | Perte du contexte | Absence de stockage de l’état | Mettre en place une mémoire persistante |
Si votre IA entreprend des actions avec assurance, mais se trompe, le problème ne vient pas du modèle. Il vient des données. Corrigez les entrées avant d’ajuster les sorties.
Étape 2 : concevoir l’architecture technique dans différents écosystèmes de fournisseurs
La pile d’automatisation par l’IA se décompose en quatre niveaux : déclencheur, données d’entrée, traitement par l’IA et acheminement des résultats. À mesure que vous progressez, vous avez besoin d’outils différents.
Au niveau 1, l’automatisation par l’IA repose généralement sur Claude Pro ou ChatGPT Plus, avec un espace de travail partagé comme Teams. Ce niveau couvre la rédaction et la synthèse de base, sans véritable architecture. Tout passe par le copier-coller, avec un risque majeur de perte de contexte.
Une personne colle une longue conversation dans le LLM, mais l’outil tronque l’historique et produit un résumé incomplet.
Le niveau 2 fait appel à des outils API et à des plateformes d’automatisation comme Make Business ou Zapier Professional. Ces plateformes relient votre CRM à votre modèle d’IA. Ce niveau coûte environ $150 à $350 par mois.
Zapier semble être le choix évident grâce à ses intégrations natives très nombreuses, mais sa fréquence d’interrogation des API a une limite : avec les forfaits standard, Zapier interroge les API toutes les 15 minutes. Si les données de vos clients changent, votre agent IA peut donc l’ignorer pendant 15 minutes, ce qui ne respecte plus l’exigence du niveau 1, fixée à moins de 5 minutes de latence. Pour disposer d’un contexte en temps réel, utilisez des déclencheurs par webhook plutôt qu’une interrogation périodique.
Le niveau 3, celui des opérations connectées avec plusieurs agents, nécessite des frameworks d’agents à plusieurs étapes et des outils d’automatisation pour entreprises comme n8n. Il permet de gérer les embranchements logiques et les acheminements complexes. n8n exige un hébergement autonome ou une offre cloud entreprise, ce qui déplace vos coûts des licences logicielles vers le temps d’ingénierie DevOps.
Le risque est de supposer que votre équipe informatique habituelle peut maintenir une instance n8n auto-hébergée sans surveillance dédiée de l’infrastructure de vos nœuds d’automatisation. Sans cette surveillance, une fuite de mémoire dans un seul workflow peut faire tomber toute votre plateforme d’agents.
Voici un exemple de charge utile JSON transmise par webhook pour acheminer une automatisation de niveau 2 vers un nœud de traitement par l’IA :
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Quand le nœud de traitement par l’IA reçoit cette charge utile, il utilise le paramètre `task` pour sélectionner un modèle de prompt précis. Si Stripe modifie la structure de sa charge utile API et place `amount_due` dans un objet imbriqué, votre modèle d’IA risque d’inventer la valeur et de rédiger un e-mail indiquant $0. Nous imposons un versionnement sémantique des modèles de prompts pour éviter les régressions.
Lorsque vous modifiez un prompt pour prendre en charge la nouvelle structure de Stripe, vous incrémentez son numéro de version.
Si le nouveau prompt provoque des hallucinations en production, vous pouvez revenir immédiatement à la version précédente sans toucher au code. Vous placez également le nœud de traitement par l’IA derrière une file d’attente comme RabbitMQ. Si Sendgrid tombe en panne, votre webhook ne doit pas échouer.
La file conserve la charge utile et retente l’acheminement du résultat jusqu’au rétablissement de l’API externe.
Calculez le coût de base d’une pile de niveau 3 à l’aide du calculateur ci-dessous.
Calculateur du coût de l’automatisation IA
Estimez les coûts mensuels des différents niveaux d’automatisation par l’IA.
Prêt à découvrir ce que l’IA peut apporter à vos opérations ?
Livré sous 3-5 jours ouvrés. Sans engagement.
Étape 3 : mettre en place la sécurité et la gouvernance des opérations autonomes
À la couche 3 (couche des outils), l’IA peut interroger les données, mais pas agir dans des systèmes externes : elle conseille sans pouvoir exécuter d’actions. À la couche 6 (opérations autonomes), les agents IA surveillent les données en continu, détectent les événements, analysent les jeux de données et agissent sans intervention humaine préalable.
Passer du conseil à l’exécution crée des risques de sécurité considérables. Vous devez définir des règles de gouvernance pour les actions que les agents IA exécutent dans des systèmes externes.
On compare souvent cela à l’électricité. Même une installation électrique a besoin d’un tableau avec disjoncteur et mise à la terre. Vos agents autonomes ont besoin d’un dispositif de sécurité comparable.
Nous exigeons une validation humaine pour toute action impliquant une transaction financière ou la suppression de données. Le système doit s’interrompre et demander confirmation.
Définissez des limites de débit strictes et un contrôle des accès fondé sur les rôles pour les jetons de vos agents. Un agent autorisé à effectuer des remboursements ne doit pas pouvoir modifier votre dépôt de code source. Utilisez des clés API aux droits limités, qui expirent toutes les 24 heures.
Un point souvent négligé : sans données fiables, la mémoire et l’orchestration sont surestimées
Le marché présente les configurations avancées à plusieurs agents comme le graal de l’automatisation par l’IA. Nous ne partageons pas cet avis. Investir dans les couches 4 et 5 ne sert à rien si la couche 1 reste défaillante.
La couche 4 (couche mémoire) donne aux agents un contexte persistant d’une session à l’autre, afin qu’ils puissent tirer des enseignements des résultats passés. Mais si les données sous-jacentes sont corrompues, l’agent ne fait que mémoriser des erreurs. Un système à plusieurs agents alimenté par de mauvaises données amplifie les échecs plus vite qu’un agent seul ne le pourrait.
Le principal obstacle au passage de la couche 2 à la couche 3 dans l’automatisation par l’IA est la qualité des données, pas la technologie. Le problème se répercute ensuite sur toutes les couches supérieures.
L’architecture des données doit précéder celle de l’IA. Avant d’acheter des outils d’orchestration, corrigez le schéma de votre CRM : un simple script alimenté par des données fiables sera toujours plus efficace qu’un système à plusieurs agents nourri de données inutilisables. Commencez par consolider vos fondations.
Relier les couches d’automatisation par l’IA au retour sur investissement et à la conduite du changement
La pile d’automatisation à 5 couches comprend la collecte des données, l’orchestration des pipelines, la logique de décision, les actions intelligentes et les agents autonomes. Relier ces couches techniques aux résultats de l’entreprise permet d’obtenir l’adhésion de la direction.
À elle seule, cette rapidité réduit considérablement les délais de résolution des demandes de support client.
Avant de lancer un pilote, modélisez la pile à partir d’un scénario hypothétique de tri des tickets. Renseignez le volume propre à l’organisation, le coût de traitement, les frais logiciels, l’utilisation du modèle, le temps de vérification et le coût des erreurs. Calculez le seuil de rentabilité à partir des données observées, sans le présenter comme un résultat obtenu chez un client.
Pour la plupart des entreprises, passer de la couche 1 à la couche 5 prend en moyenne 14 mois. N’attendez pas une transformation du jour au lendemain. Prévoyez un plan de conduite du changement pour former votre équipe à cette nouvelle pile d’automatisation.
Un pilote de tri des tickets peut susciter des réticences si sa réussite se mesure uniquement au nombre de tickets traités. Dans un déploiement hypothétique, l’équipe pourrait mesurer les problèmes complexes résolus et la qualité des corrections, tandis que le système se chargerait de la classification courante. Interrogez le personnel et ne publiez les résultats réels qu’après le pilote.
Le plan de déploiement doit préciser quels cas restent confiés au personnel et quelles compétences sont nécessaires pour la validation, la gestion des exceptions et la responsabilité du système. Consignez le temps de formation et l’évolution des rôles constatés lors du déploiement réel, plutôt que d’inventer un résultat concernant les effectifs.
Si vous négligez cette conduite du changement, votre équipe risque de compromettre la qualité des données à la source : elle saisira des notes non structurées au lieu d’utiliser les champs à menus déroulants. Elle contournera le CRM pour suivre les opportunités dans des feuilles de calcul. Un système à plusieurs agents alimenté par ces données dégradées échouera aussitôt.
Voilà à quoi ressemblent les couches d’automatisation par l’IA dans la pratique.
Ne restez pas dans le flou. Avancez avec une feuille de route claire.
Livraison rapide. Résultats mesurables. Priorité à la sécurité.
Questions fréquentes
