Lagene i KI-automatisering strekker seg fra et ryddig datagrunnlag til autonom, hendelsesstyrt drift. Hvert lag fungerer bare hvis laget under gjør det. De fleste team stopper opp på lag 3, der KI skal gå fra å gi råd til å utføre handlinger. Årsaken er nesten alltid datakvalitet, ikke modellens evner.
- Bransjen mangler en felles standard, men når modellene med 3, 5 og 6 lag samles, trer en tydelig utvikling frem: fra datagrunnlag til autonom drift.
- 80% av teamene stopper opp på lag 3 (beslutningslogikk) på grunn av ustrukturerte data fra lag 1 og 2. Det viser at datakvalitet er en større hindring enn teknologi.
- Å skalere fra nivå 1 med enkeltverktøy ($45-$120/mnd.) til nivå 3 med drift basert på flere agenter ($400-$800/mnd.) krever bevisste endringer i arkitekturen og streng styring.
Hva er det helhetlige rammeverket for lag i KI-automatisering?
Det helhetlige rammeverket for lag i KI-automatisering er en leverandøruavhengig modell for utvikling. Det samler fragmenterte arkitekturer med 3, 5 og 6 lag i én tydelig vei videre for dem som skal ta systemene i bruk. Vi kobler automatiseringsarkitekturen med 5 lag til agentarkitekturen med 6 lag for å beskrive KI-modenhet fra datagrunnlag til autonom drift.
Slik kan teknisk gjennomføring og evnen til å resonnere utvikles i takt. Begge fagmiljøene må trekke i samme retning.
Automatiseringsarkitekturen med 5 lag består av datainnsamling, koordinering av datapipelines, beslutningslogikk, intelligente handlinger og autonome agenter. Vi kobler disse operative delene til rammeverket for agentarkitektur med 6 lag, som beskriver KI-modenhet fra datagrunnlag til autonom drift. Målet er at teknisk gjennomføring og evnen til å resonnere skal utvikles i takt.
Tradisjonelt har datateam jobbet etter modellen med 5 lag, mens team for maskinlæring har bygget etter modellen med 6 lag. Det har skapt et stort kommunikasjonsgap.
Datateamene har konsentrert seg om å flytte data, mens teamene for maskinlæring har konsentrert seg om resonneringssløyfer. Når vi samler modellene, må begge fagmiljøene forholde seg til den samme milepælen: Hvis datateamet ikke kan dokumentere at koordineringen av datapipelines i modellen med 5 lag håndterer særtilfeller, kan teamet for maskinlæring ikke gå videre til verktøyutførelse i modellen med 6 lag.
Lag 1 (datagrunnlag) er stadiet der data ligger i atskilte siloer uten et felles spørringslag for KI. Team bruker uker på å skrive egne skript for å besvare grunnleggende spørsmål om driften. For de fleste virksomheter er denne manuelle tilnærmingen utgangspunktet.
Feilen er å anta at et datavarehus løser problemet. Vi ser selskaper legge rå CSV-filer i Snowflake og stolt kalle det lag 1. Det er en felle.
Hvis en KI-agent må skrive egen SQL for å tolke ustrukturerte tekstfelt bare for å finne en kunde-ID, er dataene fortsatt i siloer.
En agent som handler på grunnlag av utdaterte lagerdata, kan bestille varer som ikke er tilgjengelige, eller overse en salgstopp. Test kravene til dataenes ferskhet, forsinkede hendelser og avstemming før systemet får legge inn bestillinger.
På lag 3 (verktøylaget) kan KI hente data, men ikke utføre handlinger i eksterne systemer. Den kan dermed gi råd, men ikke handle. Det er her de fleste team møter veggen.
Lag 4 (minnelaget) gir agenter kontekst som bevares på tvers av økter. De kan lære av tidligere resultater og slutte å gjenta kjente feil. De husker brukerpreferanser og tidligere feil.
Særtilfellet som kan ødelegge dette laget, er at tilstand lekker mellom økter: En agent husker en rabattkode for én bruker og bruker den ved en feil i en ny brukers økt. Det fører til datalekkasje. Minnelaget krever streng isolering av navnerom for hver bruker.
På lag 5 (koordineringslaget) kan flere spesialiserte agenter samarbeide om komplekse oppgaver, enten sekvensielt, parallelt eller hierarkisk. Dette er arkitektur med flere agenter. Team prøver ofte å hoppe over lag 4 og gå rett til lag 5.
Da kan ikke agentene bevare tilstand mellom sine egne sekvensielle oppgaver. Resultatet blir koordineringssløyfer der agentene stadig ber hverandre om data de allerede har hentet. Det kan tidoble tokenkostnadene og ødelegge avkastningen på investeringen.
Lag 6 (autonom drift) innebærer at KI-agenter kontinuerlig overvåker data, oppdager hendelser, resonnerer ut fra datasett og handler uten at et menneske må sette dem i gang. Dette er målet.
Trinn 1: Finn ut hvilket lag i KI-automatiseringen du er på
De fleste automatiseringsprosjekter mislykkes fordi team hopper over grunnleggende lag eller starter på feil sted i automatiseringsarkitekturen. Du må kartlegge utgangspunktet før du legger til agenter.
Vi bruker en konkret sjekkliste for egenvurdering for å finne riktig startpunkt. Den hindrer at du bygger en unødvendig komplisert løsning før det grunnleggende er på plass. Gå gjennom listen for å se hvor klar du er.
- Dataforsinkelse: Sjekk hvor lang tid det tar å samle sentrale driftsdata. Tar det flere timer? Da står du fast på lag 1.
- Spørringsstruktur: Sjekk om et menneske må stille spørsmål for at dataene skal gi innsikt. Hvis KI ikke kan søke i databasen på egen hånd, er du på lag 2.
- Tilgang til å utføre handlinger: Gå gjennom tilgangene i API-et ditt. Hvis KI kan lese data, men ikke har skrivetilgang til eksterne systemer, har du nådd grensen for lag 3.
- Varig kontekst: Test minnet på tvers av økter. Hvis agenten glemmer tidligere samhandlinger når en ny økt starter, mangler du funksjonaliteten på lag 4.
En datapipeline som virker god nok til rapportering, kan likevel svikte når programvare skal handle på grunnlag av dataene. Test skjemaendringer, manglende felt, utdaterte oppføringer, dupliserte hendelser og feil i API-er lenger ned i kjeden før du åpner for skrivetilgang.
Bruk vurderingen nedenfor til å kartlegge hvor moden organisasjonen er.
Hvorfor svake data bremser automatiserte beslutninger
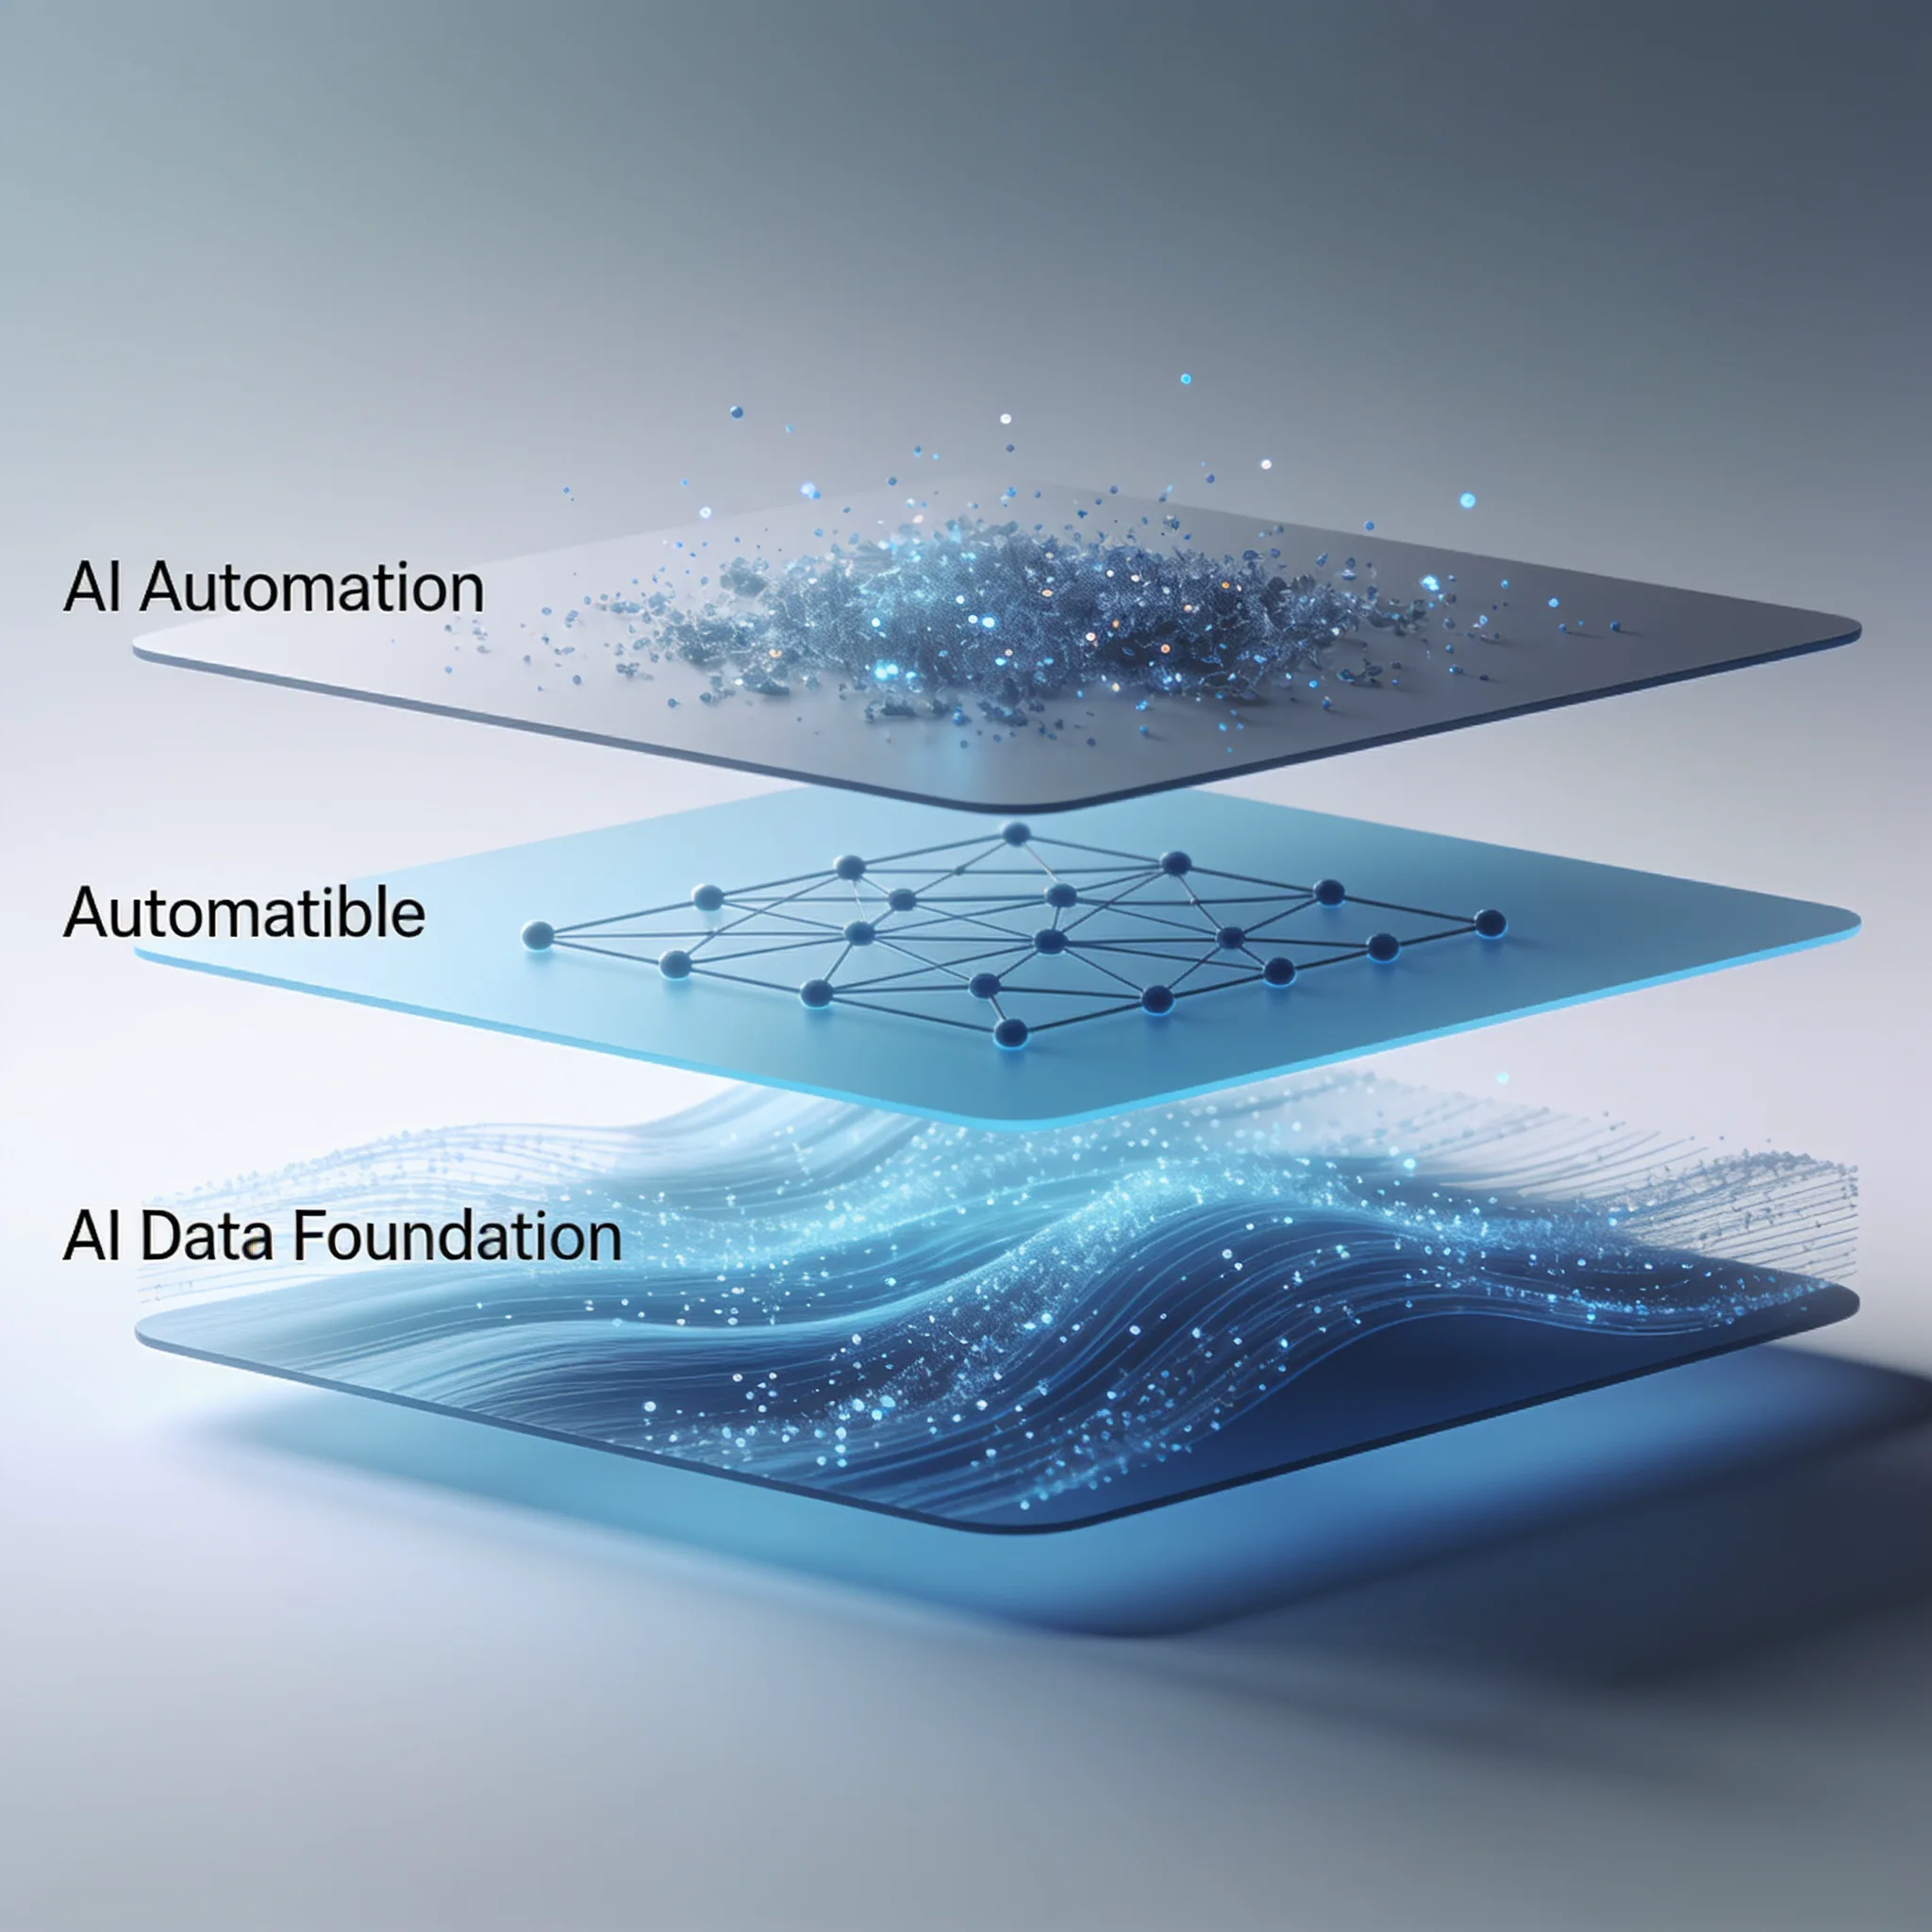
Stagnasjonen på lag 3 oppstår når team prøver å bygge automatisert beslutningslogikk uten først å rydde opp i datagrunnlaget. En betydelig andel stopper her fordi datakvaliteten er for dårlig til at KI kan resonnere pålitelig. Strukturerte data er dermed den reelle forutsetningen for å komme videre.
Den vanligste hindringen for å gå fra lag 2 til lag 3 i KI-automatisering er datakvalitet, ikke teknologi. At så mange mislykkes, avslører en utbredt feiloppfatning.
Team kjøper avanserte automatiseringsverktøy før de rydder opp i datalagringen, fordi de tror KI-modellen selv vil finne ut av rotete datastrukturer. Det gjør den ikke. KI kan ikke resonnere over ustrukturerte data av dårlig kvalitet uten enormt tokenforbruk og risiko for hallusinasjoner.
Stagnasjonen på lag 3 er egentlig en svikt i dataarkitekturen som ser ut som en begrensning ved KI.
| Modenhetslag | Feiltype | Hovedårsak | Veien videre |
|---|---|---|---|
| Lag 1 | Spørringer tidsavbrytes | Data i siloer | Samle datainnsamlingen |
| Lag 2 | Irrelevante resultater | Statiske rapporter | Legg til vektorrepresentasjoner |
| Lag 3 | Hallusinerte handlinger | Ustrukturerte inndata | Still krav til datakvalitet gjennom tjenestenivåavtaler |
| Lag 4 | Tap av kontekst | Manglende lagring av tilstand | Bygg varig minne |
Hvis KI-systemet ditt utfører handlinger som virker riktige, men ikke er det, er ikke modellen problemet. Dataene er problemet. Rett opp inndataene før du finjusterer resultatene.
Trinn 2: Utform den tekniske arkitekturen på tvers av leverandørøkosystemer
En KI-automatiseringsstack kan deles inn i nivåene utløser, datainndata, KI-behandling og ruting av resultater. Du trenger ulike verktøy etter hvert som du beveger deg gjennom disse nivåene.
KI-automatisering på nivå 1 bruker vanligvis Claude Pro eller ChatGPT Plus med et delt arbeidsområde som Teams. Dette nivået dekker enkel utforming av tekst og oppsummering, uten noen egentlig systemarkitektur. Du er avhengig av å kopiere og lime inn, og den viktigste feilkilden er at kontekst går tapt.
En bruker limer inn en lang samtale i språkmodellen, men verktøyet kutter av historikken. Resultatet blir ufullstendige oppsummeringer.
KI-automatisering på nivå 2 bruker API-verktøy og automatiseringsplattformer som Make Business eller Zapier Professional. Disse plattformene kobler CRM-systemet ditt til KI-modellen. Dette nivået koster omtrent $150 til $350 per måned.
Zapier virker som det opplagte valget fordi plattformen har innebygde integrasjoner mot det meste. Ulempen som er lett å overse, er begrensningen i hvor ofte den sjekker etter endringer. På standardabonnementer sjekker Zapier API-er hvert 15.
minutt. Hvis kundedataene dine endres, får KI-agenten derfor ikke vite det før det har gått opptil 15 minutter. Da brytes kravet på nivå 1 om en forsinkelse på under 5 minutter.
For å holde konteksten oppdatert i sanntid må du bruke webhook-baserte utløsere i stedet for regelmessige API-sjekker.
Tilkoblede operasjoner med flere agenter på nivå 3 krever rammeverk for agenter som støtter flere trinn, og automatiseringsverktøy for større virksomheter, som n8n. Nivået håndterer forgrenet logikk og kompleks ruting. n8n krever egen hosting eller et skyabonnement for større virksomheter.
Dermed flyttes kostnaden fra programvarelisenser til arbeidstid for DevOps-utviklere. Feilen er å anta at det vanlige IT-teamet ditt kan drifte en n8n-instans på egen infrastruktur uten dedikert overvåking av infrastrukturen for automatiseringsnodene. Uten slik overvåking kan en minnelekkasje i én enkelt arbeidsflyt sette hele agentplattformen ut av drift.
Her er et standard JSON-innhold for en webhook som ruter automatisering på nivå 2 til en node for KI-behandling:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Når noden for KI-behandling mottar dette innholdet, bruker den parameteren `task` til å velge en bestemt promptmal. Hvis Stripe endrer strukturen på API-dataene og legger til et nestet objekt for `amount_due`, kan KI-modellen finne på en verdi og skrive en e-post der beløpet er $0. Vi krever semantisk versjonering av promptmaler for å unngå regresjoner.
Når du oppdaterer en prompt for å håndtere den nye strukturen på dataene fra Stripe, øker du versjonsnummeret.
Hvis den nye prompten fører til at modellen finner på opplysninger i produksjon, kan du umiddelbart gå tilbake til forrige versjon uten å endre kodebasen. Du bør også isolere noden for KI-behandling bak en kø som RabbitMQ. Hvis Sendgrid får nedetid, skal ikke webhooken feile.
Køen holder på dataene og prøver å rute resultatet på nytt til det eksterne API-et er tilgjengelig igjen.
Beregn grunnkostnadene ved å bygge en stack på nivå 3 med kalkulatoren nedenfor.
Kostnadskalkulator for KI-automatisering
Anslå månedlige kostnader på ulike nivåer av KI-automatisering.
Vil du se hva KI kan gjøre for driften din?
Leveres innen 3-5 virkedager. Ingen forpliktelser.
Trinn 3: Innfør sikkerhet og styring for autonome operasjoner
På nivå 3 (verktøynivået) kan KI hente data, men ikke utføre handlinger i eksterne systemer. Den gir råd, men kan ikke handle. På nivå 6 (autonome operasjoner) overvåker KI-agenter data kontinuerlig, oppdager hendelser, analyserer datasett og handler uten at et menneske setter dem i gang.
Spranget fra rådgivning til handling medfører betydelig sikkerhetsrisiko. Du må innføre styringsrutiner for tilfeller der KI-agenter utfører handlinger i eksterne systemer.
En nærliggende sammenligning er strøm. Selv et elektrisk anlegg trenger et jordet sikringsskap. De autonome agentene dine trenger tilsvarende effektbrytere.
Vi krever at et menneske godkjenner alle handlinger som innebærer økonomiske transaksjoner eller sletting av data. Systemet må stoppe opp og be om bekreftelse.
Sett strenge grenser for antall forespørsler og bruk rollebasert tilgangskontroll for agentenes tilgangstokener. En agent som kan utstede refusjoner, skal ikke ha skrivetilgang til kildekoderepositoriet ditt. Bruk API-nøkler med avgrensede tilganger som utløper hver 24. time.
En oversett innsikt: Hvorfor hukommelse og orkestrering er overvurdert uten rene data
Markedet fremstiller avanserte oppsett med flere agenter som det ultimate målet for KI-automatisering. Vi er sterkt uenige. Det er bortkastet å investere i nivå 4 og nivå 5 hvis grunnlaget på nivå 1 fortsatt er mangelfullt.
Nivå 4 (hukommelsesnivået) gir agenter vedvarende kontekst på tvers av økter, slik at de kan lære av tidligere resultater. Men hvis dataene i bunnen er feil, lærer agenten bare av feilene. Et system med flere agenter som bygger på dårlige data, sprer feil raskere enn én agent kunne gjort alene.
Den vanligste hindringen for å gå fra nivå 2 til nivå 3 i KI-automatisering er datakvalitet, ikke teknologi. Det samme gjelder høyere nivåer. Dårlige data forurenser hvert eneste nivå over.
Dataarkitekturen må på plass før KI-arkitekturen. Ikke kjøp orkestreringsverktøy før du har ryddet opp i datastrukturen i CRM-systemet. Et enkelt skript som bruker rene data, slår et system med flere agenter som bruker dårlige data hver gang. Begynn med grunnlaget for å bygge en bedre kjede.
Slik knytter du nivåene i KI-automatisering til avkastning og endringsledelse
Automatiseringsstacken med 5 nivåer omfatter datafangst, orkestrering av datapipelines, beslutningslogikk, intelligente handlinger og autonome agenter. Når du knytter disse tekniske nivåene til forretningsresultater, blir det lettere å få ledelsen med på satsingen.
Bare denne hastigheten reduserer tiden det tar å løse kundesaker betydelig.
Bruk en tenkt arbeidsmengde for sortering av henvendelser til å modellere stacken før en pilot. Legg inn virksomhetens egne tall for volum, behandlingskostnad, programvarekostnader, modellbruk, tid til gjennomgang og kostnader ved feil. Nullpunktet, der gevinstene dekker kostnadene, skal beregnes ut fra observerte tall, ikke presenteres som et resultat oppnådd hos en kunde.
For de fleste større virksomheter tar det i gjennomsnitt 14 måneder å gå fra nivå 1 til nivå 5. Ikke forvent endring over natten. Lag en plan for endringsledelse som gir teamet opplæring i den nye automatiseringsstacken.
En pilot for sortering av henvendelser kan møte motstand blant ansatte hvis suksess bare måles i antall behandlede saker. I en tenkt utrulling kan teamet måle hvor mange komplekse problemer som løses, og kvaliteten på korrigeringene, mens systemet tar seg av rutinemessig klassifisering. Spør de ansatte og publiser de faktiske resultatene først etter piloten.
En plan for utrulling bør avklare hvilke saker de ansatte fortsatt skal håndtere, og hvilke ferdigheter de trenger for validering, avvikshåndtering og systemansvar. Registrer tid brukt på opplæring og endringer i roller under den faktiske utrullingen, i stedet for å finne på et resultat for bemanningen.
Hvis du hopper over endringsledelsen, kan teamet aktivt undergrave datagrunnlaget. De kan legge inn ustrukturerte notater i stedet for å bruke nedtrekksfelt, omgå CRM-systemet og følge opp avtaler i regneark. Da vil et system med flere agenter som bruker disse dataene, raskt mislykkes.
Slik fungerer nivåene i KI-automatisering i praksis.
Slutt å gjette. Begynn å bygge etter en tydelig plan.
Rask levering. Målbare resultater. Sikkerhet først.
Ofte stilte spørsmål
