As camadas da automação com IA vão de uma base de dados limpa até operações autónomas orientadas por eventos. Cada camada só funciona se a anterior funcionar. A maioria das equipas fica bloqueada na Camada 3, quando a IA deixa de apenas aconselhar e passa a executar ações. A causa é quase sempre a qualidade dos dados, não a capacidade do modelo.
- O setor não tem um padrão único, mas a integração dos modelos de 3, 5 e 6 camadas revela uma progressão clara, desde a base de dados até às operações autónomas.
- 80% das equipas ficam bloqueadas na Camada 3 (lógica de decisão) devido a dados não estruturados das Camadas 1 e 2. Isso mostra que a qualidade dos dados é um obstáculo maior do que a tecnologia.
- Passar das ferramentas individuais do Nível 1 ($45-$120/mês) às operações multiagente do Nível 3 ($400-$800/mês) exige mudanças arquiteturais deliberadas e uma governação rigorosa.
O que é o modelo unificado de camadas da automação com IA?
O modelo unificado de camadas da automação com IA descreve uma progressão independente de fornecedores. Reúne arquiteturas fragmentadas de 3, 5 e 6 camadas num percurso claro para quem gere operações. Relacionamos a arquitetura de automação de 5 camadas com a arquitetura de agentes de 6 camadas para definir a maturidade da IA, desde a base de dados até às operações autónomas.
Assim, a execução técnica e a maturidade de raciocínio avançam em conjunto. As duas equipas precisam de estar alinhadas.
A arquitetura de automação de 5 camadas inclui captura de dados, orquestração de pipelines, lógica de decisão, ações inteligentes e agentes autónomos. Relacionamos estes componentes operacionais com o modelo de arquitetura de agentes de 6 camadas (que define a maturidade da IA desde a base de dados até às operações autónomas) para garantir que a execução técnica e a maturidade de raciocínio avançam em conjunto. Historicamente, as equipas de engenharia de dados trabalhavam com o modelo de 5 camadas, enquanto as equipas de aprendizagem automática desenvolviam com base no modelo de 6 camadas.
Isso criou uma enorme falha de comunicação.
As equipas de dados concentravam-se em transferir dados, enquanto as equipas de aprendizagem automática se concentravam nos ciclos de raciocínio. Ao unificar os dois modelos, exigimos que ambas concordem com o mesmo critério para avançar: se a equipa de dados não conseguir demonstrar que a orquestração de pipelines da arquitetura de 5 camadas trata os casos extremos, a equipa de aprendizagem automática não pode avançar para a execução de ferramentas na arquitetura de 6 camadas.
Na Camada 1 (base de dados), os dados existem em silos desconectados, sem uma camada unificada que permita à IA consultá-los. As equipas passam semanas a escrever scripts personalizados para responder a perguntas operacionais básicas. Esta abordagem manual é o ponto de partida da maioria das empresas.
O erro aqui é presumir que um armazém de dados resolve o problema. Vemos empresas despejar ficheiros CSV brutos no Snowflake e afirmar, com orgulho, que chegaram à Camada 1. É uma armadilha.
Se um agente de IA precisa de escrever SQL personalizado para analisar campos de texto não estruturado apenas para encontrar o ID de um cliente, os dados continuam em silos.
Um agente que atua com dados de inventário desatualizados pode encomendar artigos indisponíveis ou não detetar um pico de vendas. Teste os requisitos de atualização dos dados, os eventos que chegam com atraso e a reconciliação antes de permitir que o sistema faça encomendas.
Na Camada 3 (camada de ferramentas), a IA consegue consultar dados, mas não executar ações em sistemas externos. A inteligência serve para aconselhar, não para agir. É aqui que a maioria das equipas encontra um bloqueio.
A Camada 4 (camada de memória) dá aos agentes contexto persistente entre sessões. Assim, podem aprender com resultados anteriores e deixar de repetir erros conhecidos. Recordam as preferências dos utilizadores e falhas anteriores.
O caso extremo que compromete esta camada é a contaminação de estado: um agente recorda o código de desconto de um utilizador específico e aplica-o acidentalmente à sessão de outro, provocando uma fuga de dados. As camadas de memória exigem um isolamento rigoroso do espaço de nomes por utilizador.
A Camada 5 (camada de orquestração) permite que vários agentes especializados colaborem em tarefas complexas, de forma sequencial, paralela ou hierárquica. É a arquitetura multiagente. Muitas equipas tentam saltar a Camada 4 e ir diretamente para a Camada 5.
Nesse caso, os agentes não conseguem preservar o estado entre as suas próprias tarefas sequenciais. O resultado são ciclos de orquestração em que os agentes pedem constantemente uns aos outros dados que já obtiveram, multiplicando por 10 os custos em tokens e destruindo o retorno do investimento.
A Camada 6 (operações autónomas) envolve agentes de IA que monitorizam dados continuamente, detetam eventos, analisam conjuntos de dados e agem sem intervenção humana inicial. Este é o objetivo final.
Passo 1: identifique a camada de automação com IA em que se encontra
A maioria dos projetos de automação falha porque as equipas saltam camadas fundamentais ou começam pela camada errada. Antes de adicionar agentes, estabeleça uma referência para o seu estado atual.
Usamos uma lista rigorosa de autoavaliação para identificar o ponto de partida e evitar soluções excessivamente complexas antes de os fundamentos estarem operacionais. Percorra a lista para avaliar se a sua organização está preparada.
- Latência dos dados: Verifique quanto tempo demora a reunir os principais dados operacionais. Demora horas? Então ainda está na Camada 1.
- Estrutura das consultas: Verifique se é preciso uma pessoa iniciar prompts para extrair conclusões dos dados. Se a IA não consegue consultar a base de dados autonomamente, está na Camada 2.
- Permissões para agir: Audite as permissões das suas API. Se a IA consegue ler dados, mas não tem acesso de escrita a sistemas externos, atingiu claramente o limite da Camada 3.
- Persistência do contexto: Teste a memória entre sessões. Se o agente esquece as interações anteriores quando começa uma nova sessão, ainda não dispõe das capacidades da Camada 4.
Um pipeline adequado para relatórios pode falhar quando um sistema passa a agir com base nos seus dados. Teste alterações de esquema, campos em falta, registos desatualizados, eventos duplicados e erros nas API a jusante antes de ativar a escrita.
Use a avaliação abaixo para estabelecer uma referência para a maturidade da sua organização.
Porque é que a automação de decisões fica bloqueada quando os dados são fracos
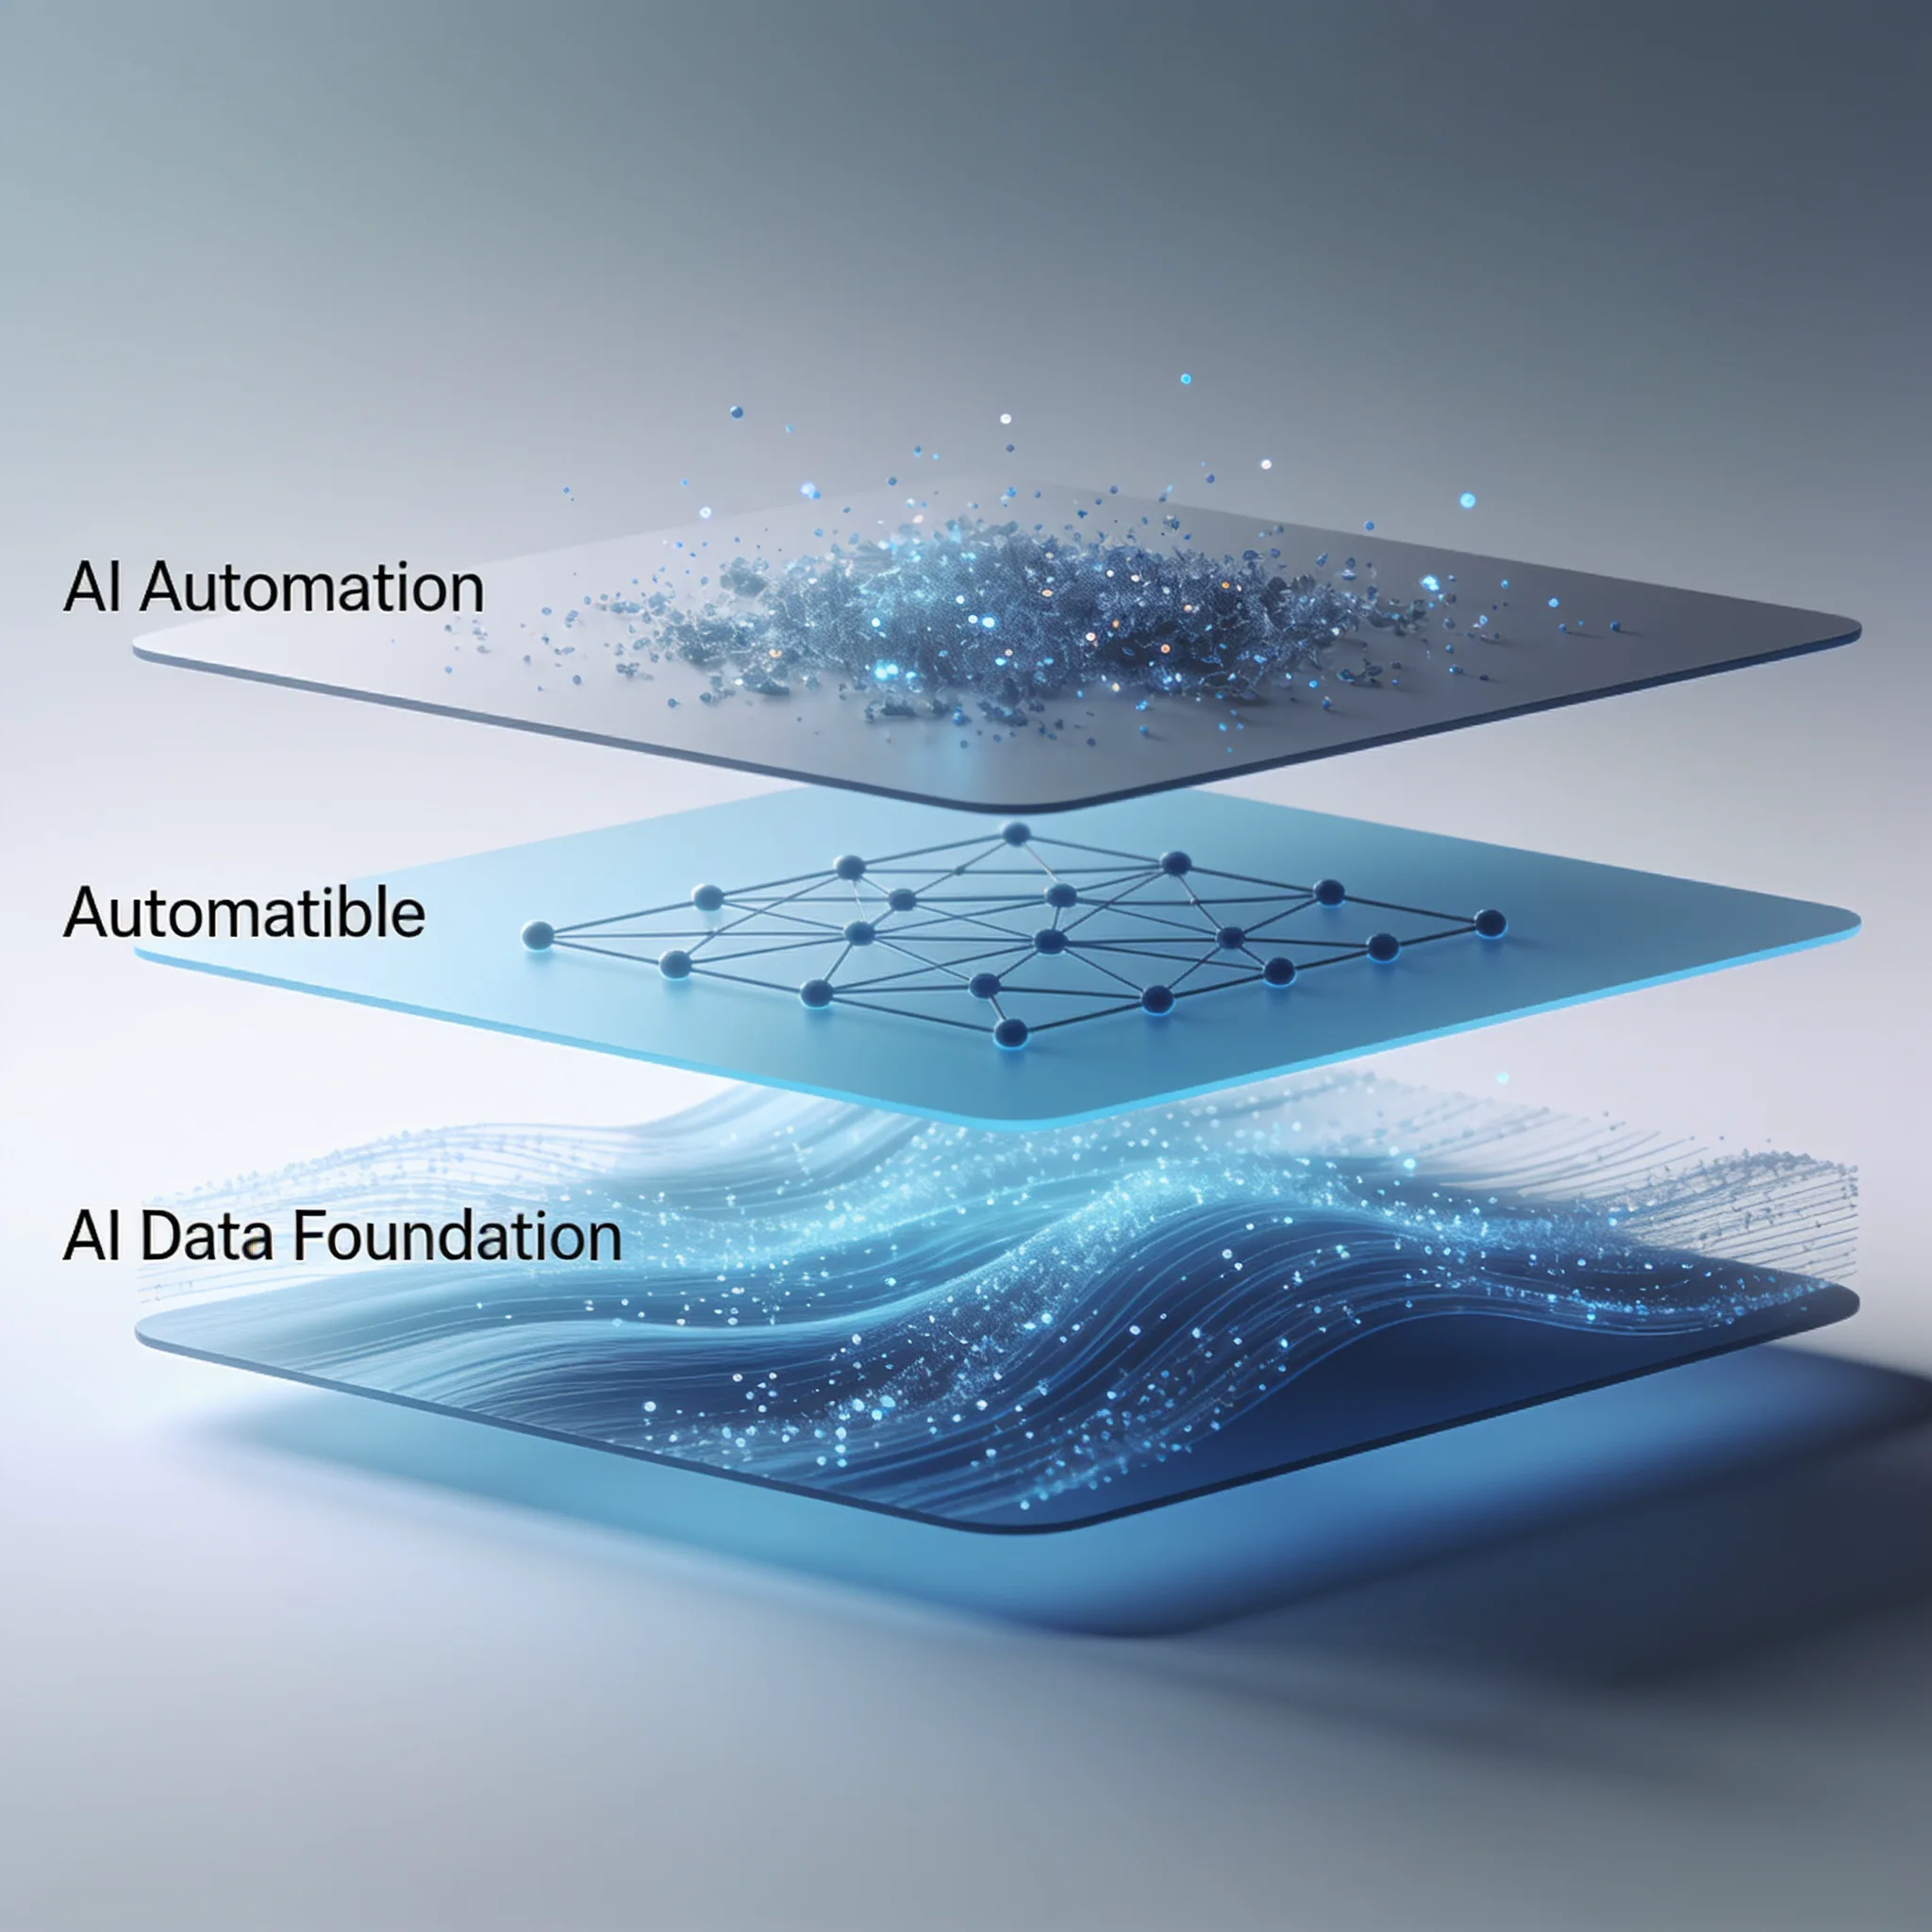
O bloqueio na Camada 3 surge quando as equipas tentam criar lógica de decisão automatizada sem primeiro limpar os dados de base. Uma percentagem significativa das equipas falha nesta fase porque a qualidade dos dados é demasiado baixa para a IA raciocinar sobre eles de forma fiável. Por isso, os dados estruturados são o verdadeiro requisito para avançar.
O obstáculo mais comum à passagem da Camada 2 para a Camada 3 da automação com IA é a qualidade dos dados, não a tecnologia. Esta taxa de insucesso expõe uma ilusão generalizada.
As equipas compram ferramentas de automação empresariais antes de limpar os seus repositórios de dados, partindo erradamente do princípio de que o modelo de IA conseguirá lidar com esquemas desorganizados. Não conseguirá. A IA não consegue raciocinar sobre dados não estruturados de má qualidade sem um consumo enorme de tokens e risco de gerar informações falsas.
O bloqueio na Camada 3 é, na realidade, uma falha na arquitetura de dados disfarçada de limitação da IA.
| Camada de maturidade | Tipo de falha | Causa principal | Como resolver |
|---|---|---|---|
| Camada 1 | Tempo limite excedido nas consultas | Bases de dados em silos | Centralizar a captura de dados |
| Camada 2 | Resultados irrelevantes | Relatórios estáticos | Adicionar representações vetoriais |
| Camada 3 | Ações inventadas pela IA | Dados de entrada não estruturados | Impor acordos de nível de serviço para a qualidade dos dados |
| Camada 4 | Perda de contexto | Ausência de armazenamento de estado | Criar memória persistente |
Se a sua IA executa ações erradas com aparente certeza, o problema não é o modelo. São os dados. Corrija os dados de entrada antes de ajustar os resultados.
Passo 2: desenhe a arquitetura técnica para diferentes ecossistemas de fornecedores
Os níveis de automação com IA podem ser divididos em acionamento, entrada de dados, processamento por IA e encaminhamento da saída. À medida que avança por estas etapas, precisa de ferramentas diferentes.
O nível 1 de automação com IA costuma usar Claude Pro ou ChatGPT Plus com um espaço de trabalho partilhado, como o Teams. Este nível serve para redigir textos e fazer resumos simples, sem uma arquitetura propriamente dita. Tudo depende de copiar e colar, por isso a principal falha é a perda de contexto.
Uma pessoa cola uma conversa longa no LLM, mas a ferramenta corta parte do histórico e produz um resumo incompleto.
O nível 2 de automação com IA usa ferramentas de API e plataformas de automação, como Make Business ou Zapier Professional. Estas plataformas ligam o seu CRM ao modelo de IA. Este nível custa aproximadamente $150 a $350 por mês.
Zapier parece a escolha óbvia porque oferece integrações nativas para praticamente tudo, mas há uma limitação menos visível: a frequência de consulta. Nos planos padrão, Zapier consulta as APIs a cada 15 minutos. Se os dados de um cliente mudarem, o seu agente de IA pode demorar 15 minutos a saber, deixando de cumprir o requisito de latência inferior a 5 minutos da camada 1.
Para manter o contexto atualizado em tempo real, use acionadores baseados em webhooks em vez de consultas periódicas.
O nível 3, de operações interligadas com vários agentes, exige frameworks de agentes com várias etapas e ferramentas de automação empresarial como n8n. Permite gerir lógica condicional e encaminhamentos complexos. n8n exige alojamento próprio ou planos empresariais na nuvem, o que transfere o custo das licenças de software para o tempo de engenharia DevOps.
O risco é presumir que a sua equipa de TI consegue manter uma instância de n8n em alojamento próprio sem monitorização dedicada da infraestrutura dos nós de automação. Sem ela, uma fuga de memória num único fluxo de trabalho pode derrubar toda a plataforma de agentes.
Este é um payload JSON padrão de um webhook que encaminha uma automação de nível 2 para um nó de processamento por IA:
{
 "trigger": "stripe.invoice_payment_failed",
 "data_input": {
 "customer_id": "cus_12345",
 "amount_due": 4900
 },
 "ai_processing": {
 "model": "claude-4-opus",
 "task": "Draft a context-aware recovery email."
 },
 "output_routing": {
 "action": "send_email",
 "platform": "sendgrid"
 }
}
Ao receber este payload, o nó de processamento por IA usa o parâmetro `task` para selecionar um modelo de prompt específico. Se Stripe alterar a estrutura do payload da API e passar a incluir `amount_due` num objeto aninhado, o modelo de IA pode inventar o valor e redigir um email com $0. Exigimos versionamento semântico dos modelos de prompt para evitar regressões.
Ao atualizar um prompt para lidar com a nova estrutura do payload de Stripe, incrementa o número da versão.
Se o novo prompt começar a inventar dados em produção, basta voltar imediatamente à versão anterior, sem alterar o código. O nó de processamento por IA também fica isolado atrás de uma fila como RabbitMQ. Se Sendgrid ficar indisponível, o webhook não deve falhar.
A fila guarda o payload e volta a tentar o encaminhamento da saída até a API externa recuperar.
Calcule os custos de referência para criar uma stack de nível 3 com a calculadora abaixo.
Calculadora do custo da automação com IA
Estime os custos mensais dos diferentes níveis de automação com IA.
Quer descobrir o que a IA pode fazer pelas suas operações?
Entrega em 3-5 dias úteis. Sem compromisso.
Passo 3: Implemente medidas de segurança e governança para operações autónomas
Na camada 3 (camada de ferramentas), a IA pode consultar dados, mas não executar ações em sistemas externos. A sua função é aconselhar, não agir. Na camada 6 (operações autónomas), os agentes de IA monitorizam dados continuamente, detetam eventos, analisam conjuntos de dados e agem sem intervenção humana inicial.
Esta passagem do aconselhamento à ação cria riscos de segurança enormes. É preciso estabelecer protocolos de governança para as ações que os agentes de IA executam em sistemas externos.
Uma comparação frequente é com a eletricidade. Até uma instalação elétrica precisa de um quadro com disjuntor e ligação à terra. Os seus agentes autónomos precisam de uma proteção equivalente.
Exigimos supervisão humana para qualquer ação que envolva transações financeiras ou eliminação de dados. O sistema tem de parar e pedir confirmação.
Defina limites rigorosos de utilização e controlo de acesso baseado em funções para os tokens dos agentes. Um agente autorizado a emitir reembolsos não deve ter permissão de escrita no repositório do código-fonte. Use chaves de API com permissões limitadas que expirem a cada 24 horas.
Uma perspetiva menos comum: por que as camadas de memória e orquestração são sobrevalorizadas sem dados fiáveis
O mercado apresenta os sistemas avançados com vários agentes como a solução definitiva para as camadas de automação com IA. Discordamos. Investir nas camadas 4 e 5 é inútil se a camada 1 continuar a ter falhas.
A camada 4 (camada de memória) dá aos agentes contexto persistente entre sessões, permitindo-lhes aprender com resultados anteriores. Mas, se os dados de base estiverem corrompidos, o agente apenas memoriza erros. Um sistema com vários agentes alimentado por dados deficientes multiplica as falhas mais depressa do que um único agente.
O obstáculo mais comum à passagem da camada 2 para a camada 3 na automação com IA é a qualidade dos dados, não a tecnologia. O problema propaga-se: dados deficientes comprometem todas as camadas acima.
A arquitetura de dados tem de vir antes da arquitetura de IA. Antes de comprar ferramentas de orquestração, corrija a estrutura de dados do seu CRM. Um script simples com dados fiáveis supera sempre um sistema com vários agentes alimentado por dados sem qualidade.
Para criar uma cadeia melhor, comece pela base.
Relacione as camadas de automação com IA com o retorno do investimento e a gestão da mudança
A stack de automação de 5 camadas inclui captura de dados, orquestração de pipelines, lógica de decisão, ações inteligentes e agentes autónomos. Relacionar estas camadas técnicas com resultados empresariais é o que permite obter o apoio da direção.
Só este ganho de velocidade já reduz drasticamente o tempo de resolução dos pedidos de suporte ao cliente.
Antes de um projeto-piloto, use um volume hipotético de pedidos a classificar para modelar a stack. Introduza os valores da própria organização para volume, custo de tratamento, despesas de software, utilização do modelo, tempo de revisão e custo dos erros. O ponto de equilíbrio deve ser calculado com base nos dados introduzidos, não apresentado como um resultado obtido por um cliente.
Para a maioria das empresas, avançar da camada 1 para a camada 5 demora, em média, 14 meses. Não espere uma transformação de um dia para o outro. Crie um plano de gestão da mudança que prepare a sua equipa para a nova stack de automação.
Um projeto-piloto de triagem pode gerar resistência na equipa se o sucesso for medido apenas pelo número de pedidos tratados. Numa implementação hipotética, a equipa poderia medir quantos casos complexos resolve e a qualidade das correções, enquanto o sistema trata da classificação de rotina. Consulte a equipa e só publique os resultados reais depois do projeto-piloto.
O plano de implementação deve definir que casos continuam a cargo da equipa e de que competências ela precisa para validar resultados, tratar exceções e assumir a responsabilidade pelo sistema. Registe o tempo de formação e as mudanças de funções observados na implementação real, em vez de inventar resultados sobre o pessoal.
Se ignorar esta etapa de gestão da mudança, a equipa pode comprometer a base de dados: introduzirá notas sem estrutura em vez de usar campos de seleção. Também pode contornar o CRM e acompanhar os negócios em folhas de cálculo, fazendo com que um sistema com vários agentes alimentado por esses dados falhe de imediato. É assim que as camadas de automação com IA funcionam na prática.
Deixe de adivinhar. Comece a construir com um plano claro.
Entrega rápida. Resultados mensuráveis. Segurança em primeiro lugar.
Perguntas frequentes
